16类常见Python算法:从数据清洗到预测建模,逐步提升分析能力 !
- 2026-09-29 23:33:03
16类常见Python算法:从数据清洗到预测建模,逐步提升分析能力 !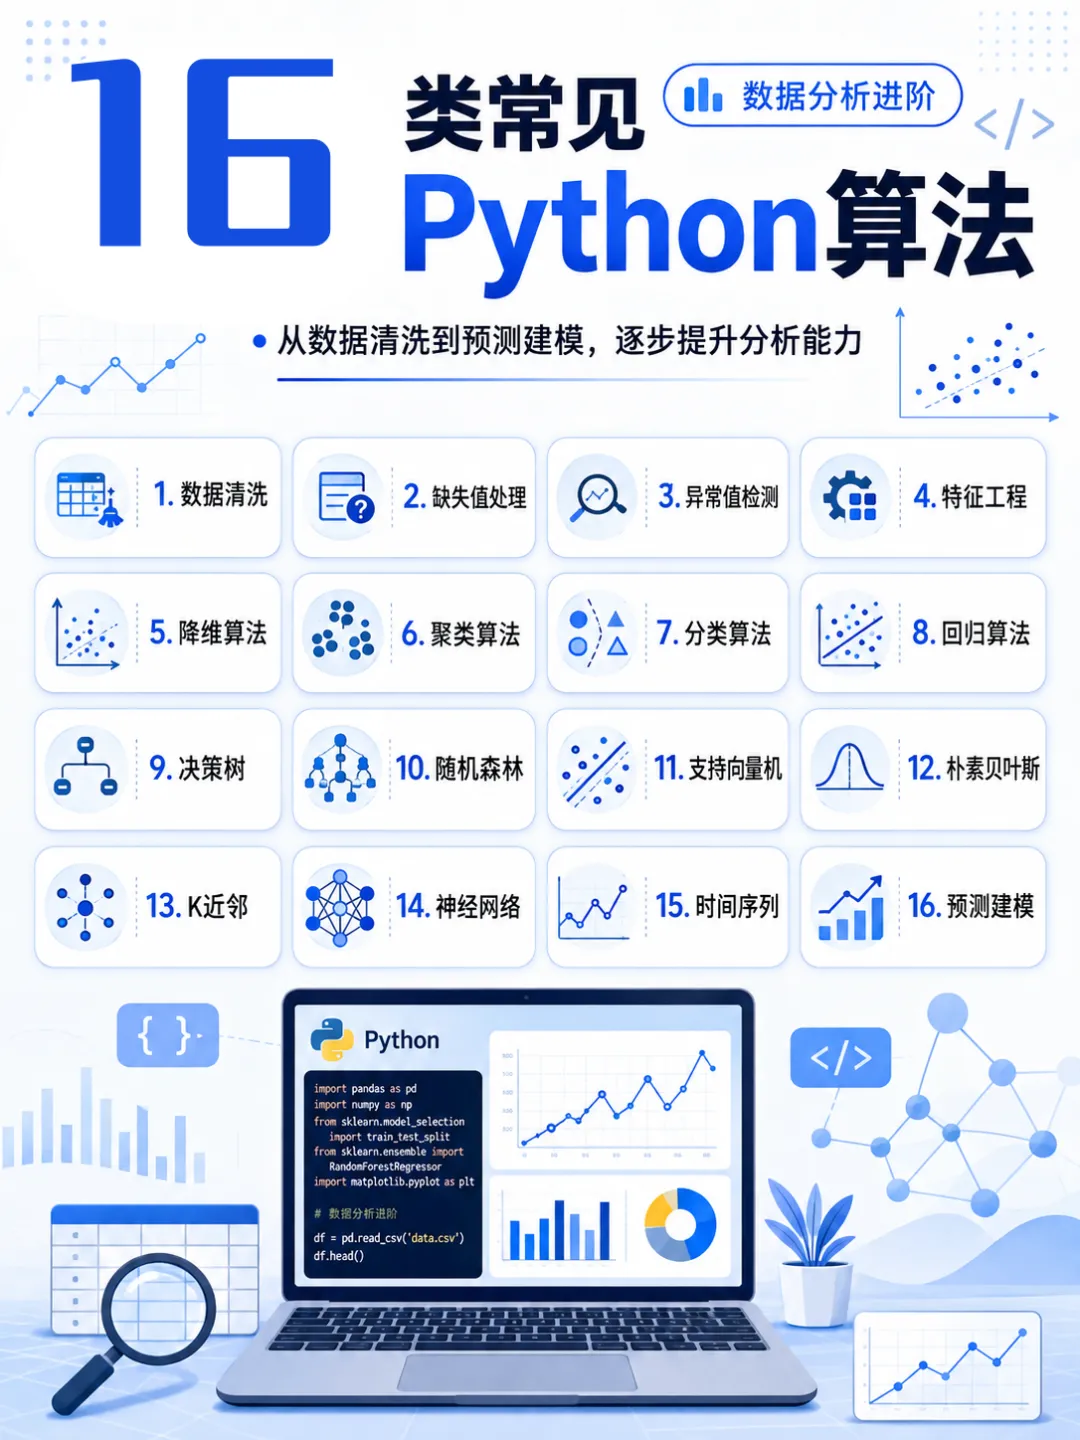
很多人在学习数据分析时,会先从Pandas、Excel和可视化工具开始。 这些工具能够帮助我们完成数据整理、指标计算以及图表展示,是数据分析工作中比较基础的一部分。 但是,如果分析一直停留在取数、制表和展示结果,就很难继续处理用户分层、风险识别、销量预测以及异常检测等相对复杂的问题。 面对这些需求,仅仅掌握工具操作通常还不够,还需要根据业务问题选择相对应的统计方法和算法。 Python拥有较为完整的数据分析生态,可以借助Pandas、NumPy、Scikit-learn、Statsmodels等相关工具,完成从数据预处理到模型训练的整个过程。 下面整理16类比较常见的算法和处理方法,主要覆盖数据清洗、统计分析、回归预测、分类、聚类、降维以及时间序列等方向。 学习时不需要一次记住全部代码。更加重要的是,先理解每一种方法主要解决什么问题,再结合实际数据逐步练习。 在正式开展统计分析或者模型训练以前,通常需要先检查原始数据。 真实业务数据中,经常会出现缺失值、异常值、格式错误以及不同指标量纲不一致等问题。 如果这些问题没有得到处理,后续模型得到的结果也可能受到影响。 销售额、年龄、用户评分等字段中,都可能出现缺失值。 最简单的处理方式是直接删除缺失记录,但如果样本数量本来就不多,删除可能会损失部分有效信息。 根据数据特点,可以选择均值、中位数或者众数进行填充。 均值填充适合分布相对稳定、异常值不明显的数据。 如果数据偏态比较明显,中位数可能更加合适;分类变量则可以考虑使用众数填充。 在更加复杂的场景中,也可以使用KNN插补等方法,根据相似样本推测缺失值。 不过,填充以前需要先分析数据为什么缺失,而不是看到空值就直接补上。 异常值可能来自录入错误、设备故障,也可能是真实存在的极端业务情况。 比较常见的识别方式包括3σ原则和IQR四分位距方法。 例如,在订单数据中,异常大额订单可能是录入错误,也可能是重要客户的正常采购。因此,识别异常值以后,还需要结合业务背景判断是删除、修正还是单独保留。 异常检测的目的不是简单清除所有极端数据,而是判断这些数据是否会影响分析结果。 不同字段之间的数值范围可能相差很大。 例如,用户年龄可能在20到60之间,而年度消费金额可能达到几万元。如果直接计算距离,金额字段就可能占据更大影响。 归一化通常会把数据压缩到0到1之间;标准化则会把数据转换为均值接近0、标准差接近1的分布。 这些方法在KNN、K-Means、SVM等依赖距离或者特征尺度的算法中比较常见。 需要注意的是,树模型通常不太依赖特征缩放,因此并不是所有算法都必须提前标准化。 在建立复杂模型以前,可以先通过统计分析了解数据分布以及变量之间的关系。 不少业务问题,其实通过描述统计、相关性分析或者假设检验,就能够得到比较有价值的结论。 描述性统计主要用于查看数据的均值、中位数、标准差、四分位数、最大值和最小值等信息。 在Pandas中,可以使用: 不过,只看汇总表还不够。 均值相同的数据,分布形态可能完全不同,因此还可以结合直方图、箱线图以及散点图进一步观察。 相关性分析主要用于判断两个变量是否存在一定程度的同向或者反向变化关系。 Pearson相关系数更适合分析连续变量之间的线性关系;Spearman相关系数则基于排序,对异常值和非线性单调关系相对更加稳健。 例如,可以分析广告投入和销售额之间是否存在正相关。 但相关不等于因果。即使两个指标表现出较强关系,也不能直接说明其中一个变量导致了另一个变量发生变化。 假设检验可以用来判断观察到的差异,是来自真实变化,还是可能由随机波动造成。 例如,在A/B测试中,可以比较两个页面版本的转化率是否存在统计差异。 常见方法包括t检验、卡方检验以及方差分析。 选择方法时,需要结合变量类型、样本关系、组数以及数据是否满足相关前提条件,不能只根据结果中是否出现显著性进行判断。 回归算法主要用于预测连续型结果,例如销售额、房价、订单金额或者客流数量。 线性回归可以用来描述特征和目标之间相对简单的线性关系。 它的优点是结构清楚,训练速度较快,模型系数也比较容易解释。 即使最终需要使用更加复杂的模型,也可以先用线性回归建立基线,判断数据是否存在基本规律。 当特征之间存在较强相关关系时,普通线性回归的系数可能不够稳定。 Ridge回归会对过大的系数进行限制,降低多重共线性带来的影响。 Lasso回归有可能把部分特征系数压缩为0,因此可以在一定程度上完成变量筛选。 Elastic Net则结合了Ridge和Lasso的特点,适合特征较多并且变量之间存在相关性的场景。 当数据中存在较复杂的非线性关系时,可以考虑随机森林、梯度提升树或者XGBoost等模型。 这些模型能够自动学习特征之间的交互关系,在结构化表格数据中经常被使用。 不过,模型复杂度增加以后,解释难度、训练成本和调参工作量也会相应提高。 因此,不能只看模型分数,还要关注是否过拟合,以及结果能否在真实业务中稳定使用。 分类算法主要用于预测离散标签。 例如,判断用户是否流失、订单是否存在风险,或者客户属于高价值还是普通价值群体。 逻辑回归虽然名称中带有“回归”,但通常用于分类任务。 它可以输出样本属于某一类别的概率,例如预测用户流失概率或者订单风险概率。 逻辑回归结构相对清楚,模型系数也可以用于观察变量影响方向,因此在需要解释结果的场景中比较常见。 KNN会根据距离目标样本最近的若干个已知样本,对新数据进行分类。 它的逻辑比较直观,适合样本规模不大、特征数量相对有限的任务。 不过,KNN对特征尺度比较敏感,使用前通常需要标准化。数据量较大时,它的预测速度也可能受到影响。 决策树会按照不同条件逐步划分数据,形成类似判断流程的模型结构。 它比较容易解释,也可以展示哪些条件影响了分类结果。 但单棵决策树容易过度拟合训练数据。 随机森林通过训练多棵树并综合结果,提高模型稳定性,适合处理客户分类、风险识别以及行为预测等任务。 聚类属于无监督学习方法。 它不需要提前提供类别标签,而是根据样本之间的相似程度,将数据划分成多个群体。 K-Means需要提前指定聚类数量,然后不断调整聚类中心,直到分组结果相对稳定。 它常被用于用户分层、商品分类以及门店分组等场景。 聚类数量可以结合肘部法、轮廓系数以及业务可解释性进行判断,不能只依赖某一个指标。 K-Means对异常值和特征尺度比较敏感,使用前通常需要进行数据清洗和标准化。 DBSCAN根据样本周围的密度完成分组,不需要提前指定最终聚类数量。 它还可以把部分孤立样本识别为噪声点,因此适合处理形状不规则、存在异常数据的分布。 不过,DBSCAN对邻域半径和最小样本数等参数较为敏感。 当不同区域的数据密度差异较大时,它的聚类效果也可能受到影响。 当数据包含几十个甚至上百个特征时,变量之间可能存在大量重复信息。 特征过多不仅会增加计算成本,也可能影响模型稳定性和可视化效果。 PCA可以把多个原始特征转换为少量新的主成分,并尽量保留原始数据中的主要信息。 它可以用于压缩特征、降低计算复杂度,也可以把高维数据转换成二维或者三维,用于可视化观察。 不过,PCA生成的主成分是多个原始变量的组合,因此业务解释性通常会有所降低。 如果模型需要明确说明每个原始指标的作用,就需要谨慎使用。 销售额、访问量、订单数以及库存等业务数据,通常都带有时间属性。 这类数据不能简单打乱顺序,需要考虑趋势、周期和时间依赖关系。 ARIMA是一种比较经典的时间序列模型,主要根据数据自身的历史变化开展预测。 它通常适合具有一定时间规律、经过处理后相对平稳的数据。 在使用以前,需要检查趋势、季节性以及平稳性,并根据数据特点选择相对应的参数。 如果数据存在明显季节周期,可以进一步了解SARIMA;如果外部因素对结果影响较大,则可能需要加入更多特征或者选择其他模型。 在正式项目中,建议使用虚拟环境管理依赖,并记录各个库的版本,减少不同电脑之间出现运行差异。 不少数据分析人员能够熟练使用Pandas处理表格,也可以制作较为完整的可视化图表,但在面对预测、分类或者用户分群问题时,仍然不知道应该从哪里开始。 出现这种情况,通常不是因为算法数量掌握得不够,而是没有建立“业务问题—数据结构—算法方法—评价指标”之间的联系。 缺失值处理、描述统计和相关性分析,可以帮助我们了解数据;回归和分类模型可以用于预测结果;聚类能够支持用户分层;PCA可以减少高维特征;时间序列模型则适合分析随时间变化的数据。 不同算法解决的问题并不相同,也不存在适用于所有场景的统一模型。 学习时可以先从数据预处理、描述统计和线性模型开始,再逐步进入树模型、聚类以及时间序列分析。 每学习一种算法,都可以尝试回答几个问题: 它适合解决什么业务问题?需要怎样的数据?使用以前有哪些条件?结果应该通过什么指标评价?模型输出能否被业务人员理解和使用? 算法并不是为了让分析看起来更加复杂,而是用来帮助我们处理传统汇总统计难以回答的问题。 只有把算法与实际业务场景结合起来,才能逐渐从简单的数据整理,走向更加完整的分析和建模工作。#python入门教程#数据分析#编程#数据分析转行#python基础#留学生#少儿编程#大学生期末考#零基础学python
一、数据预处理:先解决数据质量问题
1. 缺失值填充
import pandas as pdfrom sklearn.impute import SimpleImputerdf = pd.DataFrame({”sales”: [230, None, 450]})imputer = SimpleImputer(strategy=”mean”)df[”sales”] = imputer.fit_transform(df[[”sales”]]).ravel()print(df)
2. 异常值识别
3. 标准化与归一化
二、统计分析:先看清数据的基本规律
4. 描述性统计
df.describe()5. 相关性分析
6. 假设检验
三、回归算法:预测连续型数值
7. 线性回归
8. Ridge、Lasso与Elastic Net
9. 随机森林与XGBoost回归
四、分类算法:判断数据属于哪一类
10. 逻辑回归
from sklearn.linear_model import LogisticRegressionmodel = LogisticRegression()
11. KNN近邻分类
12. 决策树与随机森林分类
五、聚类算法:在没有标签时自动分组
13. K-Means聚类
from sklearn.cluster import KMeansmodel = KMeans(n_clusters=3, random_state=42)
14. DBSCAN密度聚类
六、降维算法:减少冗余特征
15. PCA主成分分析
七、时间序列算法:分析随时间变化的数据
16. ARIMA时间序列模型
from statsmodels.tsa.arima.model import ARIMA常用环境安装方式
pip install pandas numpy scikit-learn xgboost statsmodels scipy写在最后
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:596563534@qq.com 。
