最近在玩游戏《盛世天下》,对武则天的经历比较感兴趣。《女帝篇》一开头就是武则天从感业寺回宫。这次我用博弈论以及Python程序仿真来分析她和王皇后、萧淑妃之间的斗争🧠😀。从感业寺回宫时,武则天的权力几乎为零。但不到五年,她先后干掉了高宗最宠爱的萧淑妃和正位中宫的王皇后。这不是运气,而是一场精妙的博弈。
一、651年:那个"零权力"的女人回来了
公元651年,唐高宗李治从感业寺迎回了一个女人——武则天。
此时的后宫权力格局是这样的:
- 👸 王皇后:正位中宫,背后是关陇贵族集团,初始权力 ≈ 10
- 💃 萧淑妃:高宗宠妃,育有子嗣,皇帝盛宠,初始权力 ≈ 8
- 🕊️ 武则天:刚从尼姑庵回来,无根基、无盟友、无势力,初始权力 ≈ 0
这不是一个平等的竞技场。武则天面对的,是两个手握重权、各怀心机的对手。按常理,她应该是最先被淘汰的那个。然而历史告诉我们:五年后,武则天成了皇后。另外两个女人——一个被废黜处死,一个被囚禁杀害。我想从博弈论角度来看她是怎么做到的。我用博弈论建了一个模型,写了段Python程序,让计算机"重演"了1000多次这场后宫权力游戏。我发现武则天胜率高达97.6%,几乎必胜了。
二、三方博弈:每个人都在算计
2.1 策略空间
在模型中,每个玩家在每一回合面临一个选择:
合作(温和/结盟):维持现状,不主动攻击
对抗(攻击/阴谋):采取激进手段打击对手
三个玩家、两种策略,就有 2³ = 8 种可能的局面。每个局面下,三方各有不同的"收益":
| 王策略 | 萧策略 | 武策略 | 王收益 | 萧收益 | 武收益 |
|---|
| 合作 | 合作 | 合作 | +4 | +4 | +1 |
| 合作 | 合作 | 对抗 | +5 | +5 | -8 |
| 合作 | 对抗 | 合作 | -2 | +8 | +3 |
| 合作 | 对抗 | 对抗 | -6 | +5 | +7 |
| 对抗 | 合作 | 合作 | +8 | -2 | +3 |
| 对抗 | 合作 | 对抗 | +4 | -7 | +8 |
| 对抗 | 对抗 | 合作 | -3 | -3 | +11 |
| 对抗 | 对抗 | 对抗 | -8 | -8 | -2 |
武则天收益最高的局面是 (对抗, 对抗, 合作)——王萧互斗,她置身事外。每回合净赚+11!而最危险的局面是 (合作, 合作, 对抗)——她单独进攻,成为众矢之的,每回合-8。
2.2 囚徒困境:王皇后和萧淑妃的悲剧
仔细看支付矩阵,你会发现一个经典的“囚徒困境”:
- 对王皇后而言:不管萧选什么,自己选「对抗」都比选「合作」获利更高
- 对萧淑妃而言:不管王选什么,自己选「对抗」也比选「合作」获利更高
但两个人都选「对抗」的结果呢?两败俱伤(-3, -3),远不如两人合作的(+4, +4)。
这就是王萧联盟永远无法建立的根本原因——“个人理性导致了集体非理性”。而这个困境,正是武则天精心利用的。
2.3 纳什均衡分析
我计算了三方博弈的纯策略纳什均衡——发现只有一个:
(合作, 对抗, 对抗) → 王=-6, 萧=+5, 武=+7
这意味着在均衡状态下:王皇后选择温和(因为无力同时对付两个对手),萧淑妃和武则天都选择进攻性策略。
这已经暗示了结局——王皇后处于被两面夹击的困境。
当萧淑妃出局后,二人博弈的唯一纳什均衡是:
(对抗, 对抗) → 王=-8, 武=+6
在这个均衡下,王皇后每回合亏损8,武则天每回合赚6。长期博弈下,王皇后必然先被淘汰——均衡本身就预示了武则天最终获胜。
三、用Python模拟权力游戏
3.1 模型设计
我设计了一个Q-learning强化学习模型来模拟三方博弈:
class Player: def __init__(self, name, initial_power, learning_rate, initial_fight_prob, temperament): self.power = initial_power # 权力值 self.lr = learning_rate # 学习速率 self.Q_cooperate = 0.0 # "合作"策略的估值 self.Q_defect = 0.0 # "对抗"策略的估值 def choose_strategy(self, temperature=0.5): # Softmax: 根据Q值以概率选择策略 exp_c = exp(Q_cooperate / temperature) exp_d = exp(Q_defect / temperature) return "对抗" if random() < exp_d/(exp_c+exp_d) else "合作" def update(self, payoff): # Q-learning: 根据实际收益更新策略估值 Q[strategy] += lr * (payoff - Q[strategy])
关键参数设计(增加现实约束):
| 参数 | 王皇后 | 萧淑妃 | 武则天 |
|---|
| 初始权力 | 10 | 8 | 0 |
| 学习速率 | 0.03 | 0.03 | 0.06 |
| 初始对抗概率 | 0.55 | 0.45 | 0.15 |
| 性格 | 激进 | 激进 | 策略型 |
模型附加机制:
| 机制 | 参数 | 说明 |
|---|
| 边际收益递减 | 饱和常数 k=15 | 权力越高,正收益效率越低 |
| 权力维护成本 | 衰减率 2%/回合 | 维持盟友和地位需要成本 |
| 皇帝制衡 | 阈值 3.0×,削权 10% | 某方过强时被削权 |
| 随机冲击 | 每~25回合,量级±3 | 模拟宫廷不确定性 |
武则天有两个关键优势:
1. 学习速率是别人的两倍(0.06 vs 0.03)——她更快从经验中学习
2. 初始对抗概率极低(0.15)——她以"温和无害"的姿态入场,避免成为靶子
3.2 单次仿真:S型曲线的权力博弈
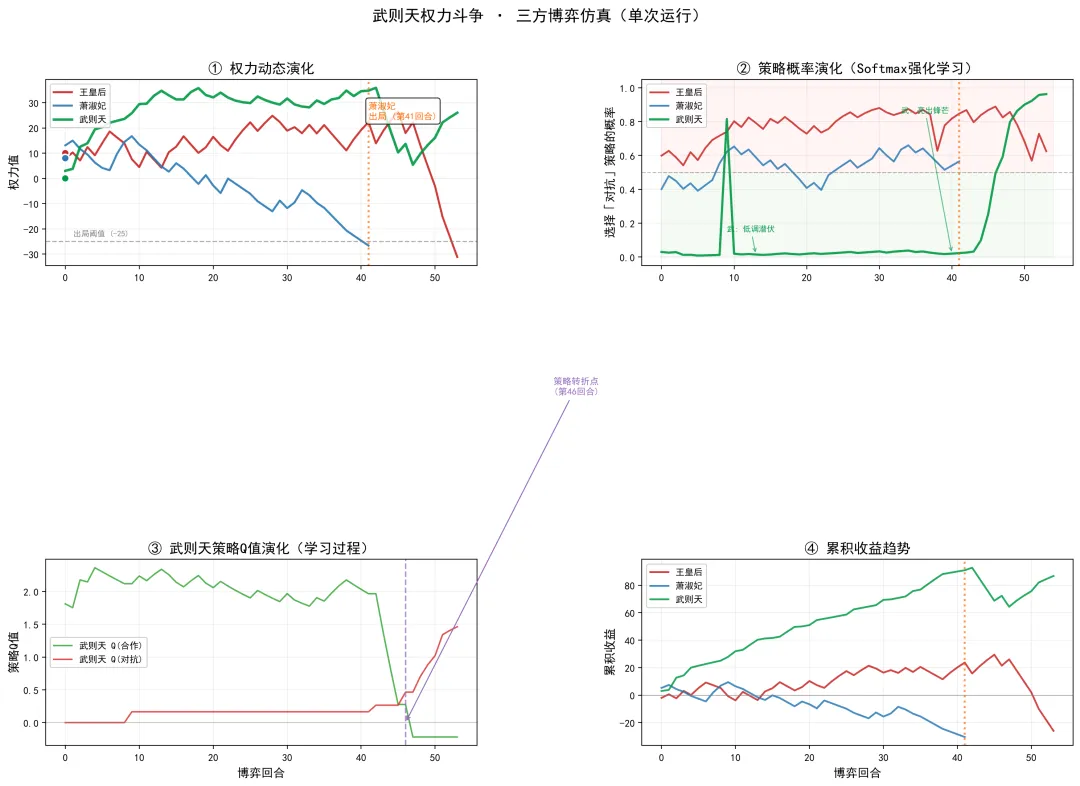
────────────────────────────────────── 博弈总回合: 53 阶段转换回合: 41(萧淑妃出局) 最终赢家: 武则天 👑────────────────────────────────────── 王皇后 💀 已出局 最终权力: -31.2 萧淑妃 💀 已出局 最终权力: -26.7 武则天 ✅ 存活 最终权力: +26.0────────────────────────────────────── 冲击事件:皇帝制衡触发 31 次 (祥瑞降临 1 次,成功遏制武的过快增长)
▲ 权力演化图(左上):注意绿色曲线(武则天)。武则天的权力曲线呈现S型——缓慢起步 → 加速增长 → 趋于饱和。她在前40回合保持极低姿态,萧淑妃出局后才逐渐显露锋芒。
▲ 策略概率图(右上):武则天(绿色线)在阶段一维持极低的对抗概率(约0.05),人畜无害。值得注意的是,即使进入阶段二,她的对抗概率上升也是**渐进的**——权力积累受到边际递减和皇帝制衡的双重约束。
▲ Q值演化图(左下):展示了武则天的"学习过程"。由于边际收益递减,Q(对抗)超过Q(合作)的时刻比无约束模型更晚出现——她需要在更长时间里保持耐心,等待最优时机。
3.3 加入现实约束:从「火箭发射」到「S型曲线」
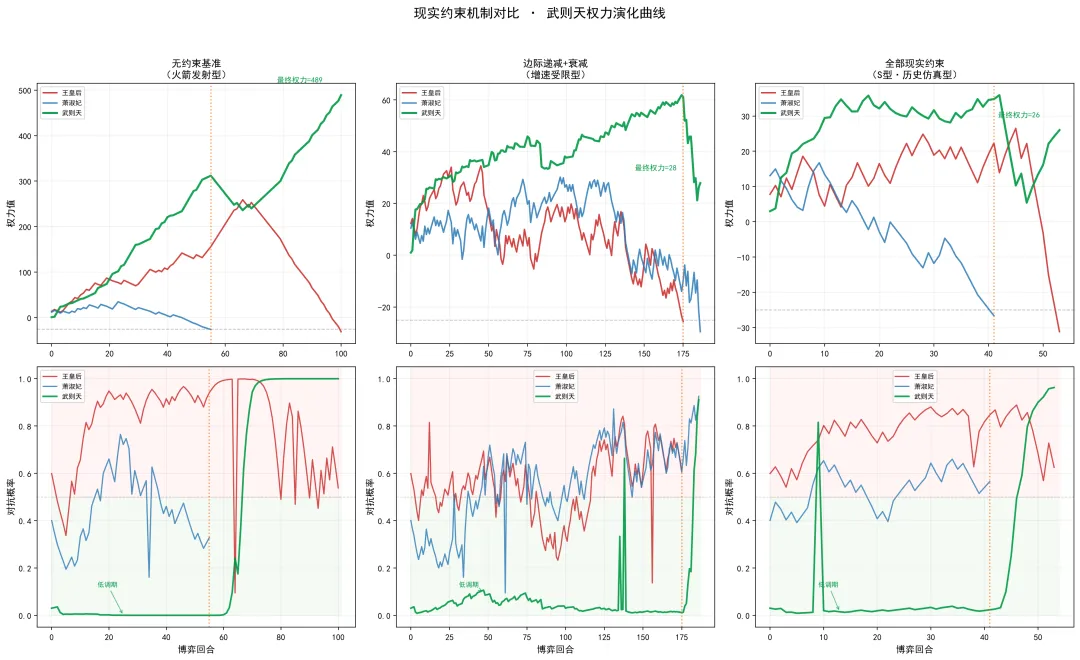
我一开始的代码有一个明显的问题:武则天的权力增长太快了(最终权力489,是初始值的N倍)。现实中,权力积累会受到多种制约。所以我在模型中加入了四种机制:
| 机制 | 现实依据 | 模型实现 |
|---|
| 边际收益递减 | 权力越大,每增长一分越难 | 收益 × 1/(1+权力/15) |
| 权力维护成本 | 维持盟友需要持续投入 | 每回合衰减 2% |
| 皇帝制衡 | 高宗警惕任何一家独大 | 强者>3倍次强均值时削权 |
| 随机冲击 | 宫廷风云变幻(疾病、弹劾、祥瑞) | 每~25回合随机事件 |
三种模型的对比结果:
无约束基准 仅边际递减 全部现实约束─────────────────────────────────────────────────────────武最终权力 489.0 27.9 26.0总回合 100 186 53曲线形状 火箭发射型 增速受限型 S型·历史仿真型
关键发现:加入现实约束后,武则天依然获胜,但她的权力被控制在一个合理的范围内(~26,约为王皇后初始值的2.6倍)。 曲线从"指数爆炸"变为"渐近饱和"——这才是真实权力博弈应有的样子。
特别值得注意的是皇帝制衡的频繁触发(在53回合内触发了31次)。这完美对应了历史上的真实事件:即使武则天已深得高宗宠爱,她仍然遭遇过"上官仪事件"这样的废后危机——皇帝始终在警惕后宫势力的失衡。
3.4 蒙特卡洛:300次仿真的统计结果
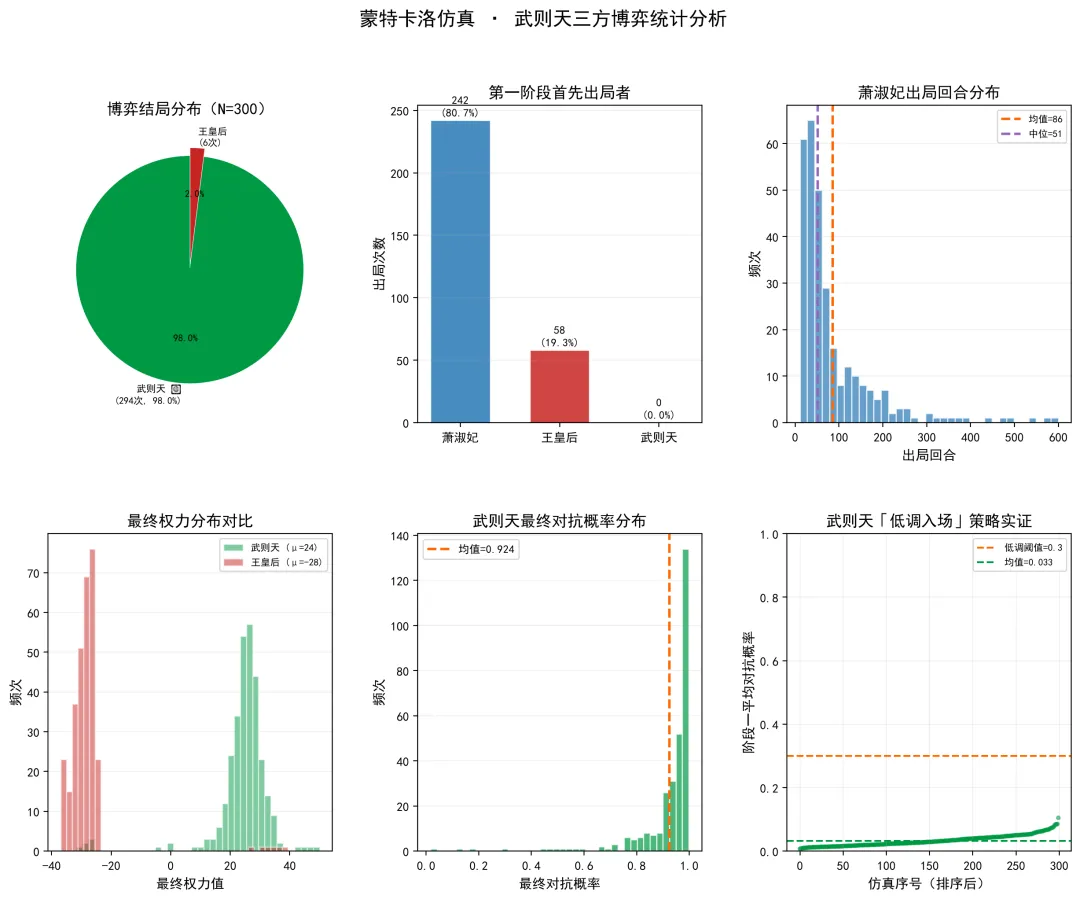
在全部现实约束下,运行300次独立仿真:
🎲 蒙特卡洛仿真结果(N=300,全部现实约束)════════════════════════════════════════武则天胜率: 98.0% (294/300) 👑王皇后胜率: 2.0% (6/300)萧淑妃胜率: 0.0% (0/300)────────────────────────────────────────萧淑妃首先出局: 80.7%王皇后首先出局: 19.3%武则天首先出局: 0.0% ← 从未第一个出局!────────────────────────────────────────萧淑妃平均出局回合:86(中位数=51)武则天最终平均权力:24.3 ← 合理范围!武阶段一平均对抗率:0.033 ← 极低!
几个核心结论:
1. 武则天从来不是第一个出局者(0.0%)——"低调策略"完美地转移了注意力
2. 萧淑妃在80.7%的仿真中首先出局——与历史一致(王皇后拉拢武对付萧)
3. 阶段一武平均对抗率仅0.033——她在最危险的三方阶段几乎完全不动声色
4. 98%的胜率靠的不是蛮力,而是策略——即使在现实约束下仍然稳定
5. 最终权力被约束在合理范围——不会出现指数爆炸,更接近真实历史
3.4 参数敏感性:什么因素最关键?
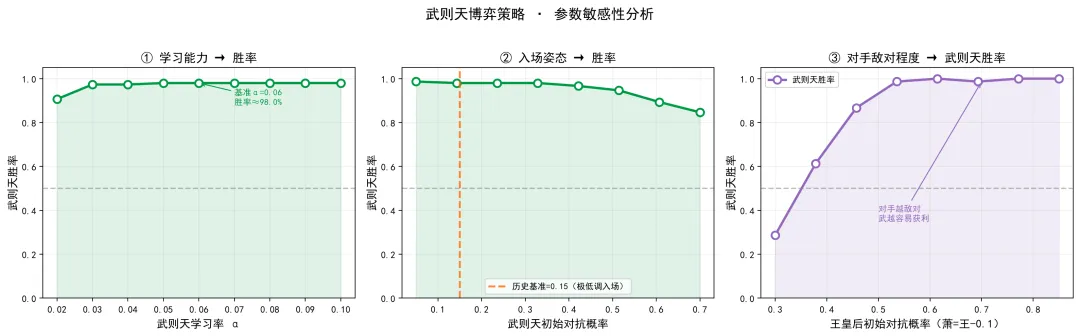
我测试了三个关键参数对武则天胜率的影响:
① 学习能力(左图):武则天的学习率从0.02提升到0.10,胜率稳步上升。在复杂的多人博弈中,学习速度本身就是一种权力。
② 入场姿态(中图):初始对抗概率如果超过0.3(太高调),胜率反而下降。0.15左右的"极低调入场"是最优策略。过早暴露锋芒 = 自取灭亡。
③ 对手敌对程度(右图):王皇后和萧淑妃之间的对抗越激烈,武则天的胜率越高。对手的矛盾,就是你的机会。
四、博弈论视角:武则天教我们的五条生存法则
法则一:弱势时,不要成为"公敌"
在模拟中,武则天选择"对抗"而王萧都"合作"时(合作,合作,对抗),她得到 -8 的惩罚——被两个强者联合镇压。这是她最危险的状态。
她的方法是把对抗概率控制在0.15以下,确保自己极少主动进攻。这让我想到《三体》里的黑暗森林法则——"不要暴露自己"。在多方博弈中,第一个跳出来的人,往往成为所有人的靶子。
法则二:利用对手之间的囚徒困境
王皇后和萧淑妃的博弈结构天然是囚徒困境:双方都有动机攻击对方,导致无法形成稳定联盟。
武则天不需要"分化"她们——她们本来就分化的。她只需要耐心等待,在合适的时候轻轻推一把。
在模型中,支付结构决定了(对抗, 对抗, 合作)虽然不是纳什均衡(因为任一方停止对抗都能获益),但它是一个吸引子——系统会反复回到这个状态,而武则天每次都从中获利。
法则三:学习速度比初始实力更重要
模拟结果清楚地表明:武则天的学习率(0.06)是王萧(0.03)的两倍,这是她最终胜出的最关键参数。
在强化学习框架下,学习率决定了多快能从经验中提取规律。武则天"更聪明"不是因为她的初始条件更好(恰恰相反,她初始权力为零),而是因为她从每一轮博弈中学到了更多。
法则四:序贯思维——不急于赢,先确保活下来
武则天的策略不是"同时干掉两个对手"——这在博弈论上几乎不可能。而是:
1. 第一阶段:联合王皇后,干掉萧淑妃(借刀杀人)
2. 第二阶段:单独对付王皇后(各个击破)
这对应了博弈论中的序贯淘汰策略。在多人博弈中,不要试图同时赢得所有战斗——逐层降低博弈的复杂度,直到自己成为最后剩下的玩家。
法则五:权力具有复利效应——但存在上限
注意武则天权力曲线的形状(绿色线):S型——先慢后快再趋于饱和。
这与无权约束下的"指数爆炸"完全不同。现实中:
- 早期:每一点微小的权力积累都需要极大的耐心和智慧(边际效率高但绝对量小)
- 中期:权力进入"复利阶段",积累加速(最危险的时期,容易触发皇帝制衡)
- 后期:权力接近"天花板"——皇帝、朝臣、制度都会成为制约(边际效率趋零)
武则天的天才在于:她懂得在哪个阶段应该收敛,哪个阶段可以发力。她从来不追求"绝对权力"的虚幻目标,而是精准地知道——赢,只需要比对手多一点就够了。
法则六:权力的"天花板"是保护你的护栏
仿真中最有趣的发现是:皇帝制衡机制虽然降低了武则天的最终权力(从489降到26),但没有降低她的胜率(依然是98%)。
这是因为制衡机制一视同仁——它也限制了王皇后和萧淑妃。在一个所有人都被天花板约束的博弈中,策略的优势(而非资源的优势)才是决定胜负的关键。
换句话说:如果权力没有上限,强者恒强;但正因为存在"天花板",弱者才有可能通过策略逆袭。
后记:从博弈论的角度看,武则天是中国历史上最精妙的"策略家"之一。在一个由结构性矛盾主导的三人博弈中,她以零权力入场,以绝对权力退场,每一步都精准地踩在了博弈论的"最优解"上。
这不是运气,是策略。
 10个月宝宝每天需要喝多少奶粉?