大多数初学者能够编写Python 代码,但很少有人知道如何规划应用结构,保障项目易于维护,避免最终代码杂乱无序。在这份案例中,你将学习专业开发者使用的实践步骤,打造结构整洁、便于调试、极易扩展的项目。
案例说明:
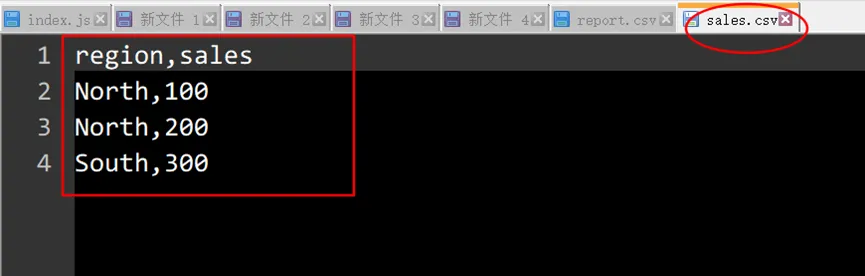
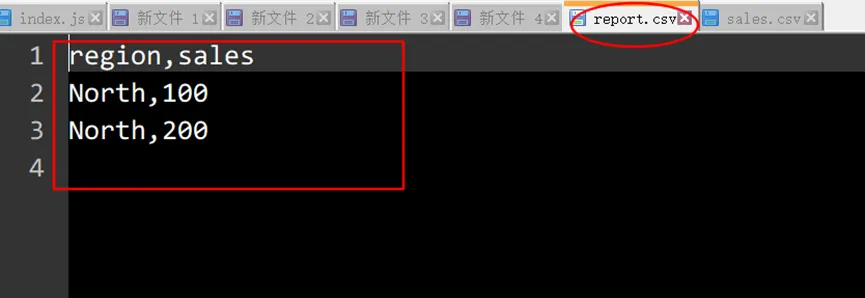
从下面的sales.csv文件中筛选出region为North的记录,保存为report.csv文件。
sales.csv:
reports.csv:
第一步:像书店分类整理图书一样组织代码
保持代码良好的组织结构,能够带来诸多优势:
代码规范组织的好处
• 可读性更高 —— 你能快速理解代码实现的功能。
• 便于排查漏洞 —— 更容易发现并修复程序错误。
• 方便迭代更新 —— 新增功能时不会让代码变得杂乱。
• 减少重复编写 —— 复用已有代码,无需重复造轮子。
• 利于团队协作 —— 其他人能够更快读懂并接手你的代码。
• 节省开发时间 —— 不用在杂乱的代码里反复搜寻内容。
• 程序更加稳定 —— 结构清晰的代码出错概率更低。
编程语言的主要组成单元:
• 代码行
• 函数
• 模块
第二步:借助注释,把任务转化为代码
启动项目有一个简单方法:先以注释形式列出项目需要完成的各项核心任务。
main.py
# load the data # filter the data # write data to a report
def load_data(): print("load_data()") def filter_data(): print("filter_data()") def write_report(): print("write_report()") # load the data load_data() # filter the data filter_data() # write data to a report write_report()
优化初始代码结构:
我们将主代码放入名为 report_flow()的函数中,让代码更加整洁:
def load_data(): print("load_data()") def filter_data(): print("filter_data()") def write_report(): print("write_report()")def report_flow(): # load the data load_data() # filter the data filter_data() # write data to a report write_report() # runs this firstreport_flow()
第三步:在运行代码前捕获错误
Pylance 十分实用,它能帮助你更顺畅地编写 Python 代码,减少代码出错。
使用 Pylance 的优势
• 边编码边发现错误:在运行程序前高亮标出代码问题。
• 代码智能提示:提供自动补全建议,提升编码速度。
• 问题解读:提示错误原因,通常还会给出修复方案。
• 支持代码跳转:可以快速定位函数、变量的定义位置。
• 提升开发效率:减少排查错误的时间,把更多精力用于编写代码。
简要总结:
Pylance 就像一位贴心助手,在你编写 Python 代码时实时检查代码,帮助你尽早发现错误。
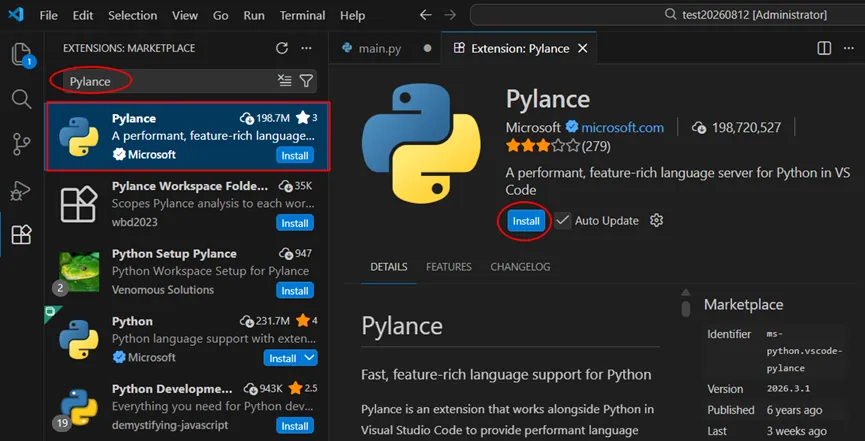
安装 Pylance:
点击侧边栏的扩展面板(Windows快捷键:Ctrl + Shift + X),搜索Pylance,然后点击安装按钮。
注意:安装 Pylance 之后,你可能需要重启 Visual Studio Code。
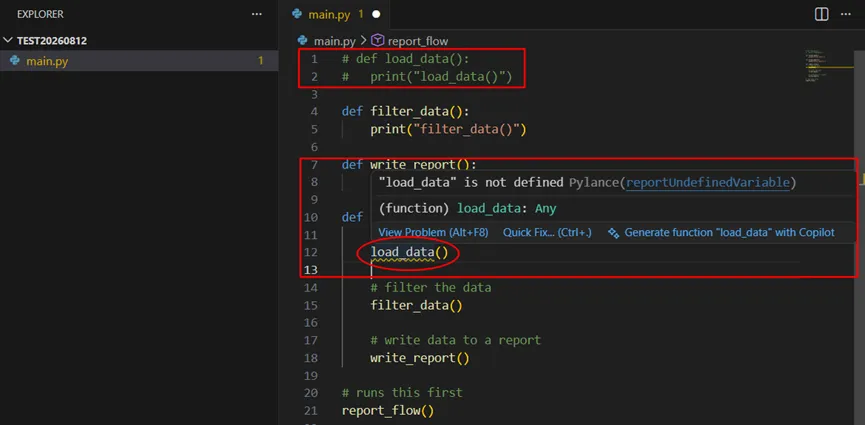
Pylance 会在代码出错的位置添加下划线,以此标出常见错误。比如我们注释掉load_data()函数的定义后:
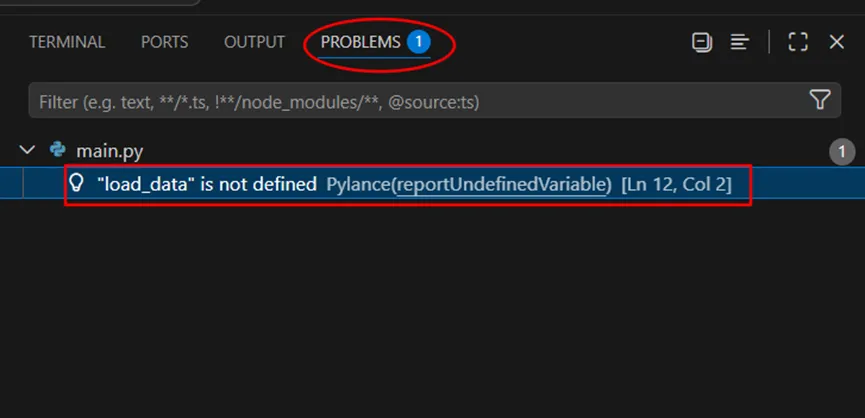
它还会在【问题】面板中列出当前所有错误(快捷键:Ctrl + Shift + M)。
第四步:灵活传递数据,提升程序可扩展性
即便函数只设计用来完成单一特定任务,依旧需要访问程序数据。
不要依赖全局变量,我们可以将数据作为参数(输入)传递给函数,并把更新后的数据以返回值(输出)形式传出。
数据传参方式的优势:
• 行为可预测(无副作用):只需查看函数的输入与输出,就能清楚了解函数功能,无需担心程序其他位置发生隐蔽的数据改动。
• 便于调试:如果函数输出结果异常,只需检查传入的参数即可,不用排查整个程序的运行状态。
• 轻松测试:只需传入模拟测试数据、校验输出结果就能测试函数,不必搭建复杂的全局程序环境。
• 代码可复用:函数不绑定特定全局变量,因此你可以在代码任意位置传入不同参数,安全调用该函数。
我们可以先定义函数之间传入、传出的数据框架,之后再添加一些示例数据用于测试。这样能够保证在继续开发前,代码可以正常运行。
import pandas as pd def load_data(): # sample data data = { "region": ["North", "North", "South"], "sales": [100, 200, 300] } # create a dataframe from this data return pd.DataFrame(data) def filter_data(df): filtered_df = df return filtered_df def write_report(df): print(f"dataframe is: \n {df}") def report_flow(): # load the data df = load_data() # filter the data filtered_df = filter_data(df) # write data to a report write_report(filtered_df)report_flow()
使用类型提示(Type Hints)
在 Python 中,我们可以借助类型提示指定参数和返回值应当具备的数据类型。
这能大幅提升代码可读性;同时借助 Pylance,VS Code 这类集成开发环境会在你鼠标悬停或调用函数时,通过悬浮提示框展示类型信息。
函数返回值的类型提示写法:使用 -> 后紧跟数据类型。
def load_data() -> pd.DataFrame:
如果函数没有返回值,则使用 None标注:
def write_report() -> None:
参数的类型提示写法:在参数名称后加冒号,紧接着写明数据类型。
def write_report(df: pd.DataFrame):
下面我们为代码加上类型提示进行更新:
import pandas as pd def load_data() -> pd.DataFrame: # sample data data = { "region": ["North", "North", "South"], "sales": [100, 200, 300] } # create a dataframe from this data return pd.DataFrame(data) def filter_data(df: pd.DataFrame) -> pd.DataFrame: filtered_df = df return filtered_df def write_report(df: pd.DataFrame) -> None: print(f"dataframe is: \n {df}") def report_flow() -> None: # load the data df = load_data() # filter the data filtered_df = filter_data(df) # write data to a report write_report(filtered_df)report_flow()
最终,我们将编写项目的主体代码,也就是实现数据读取、筛选与数据输出的代码。
import pandas as pd import os os.chdir(r'E:\TestData')def load_data() -> pd.DataFrame: df = pd.read_csv('sales.csv') return dfdef filter_data(df: pd.DataFrame) -> pd.DataFrame: filtered_df = df[df['region'] == 'North'] return filtered_df def write_report(df: pd.DataFrame) -> None: df.to_csv('reports.csv',index = False)def report_flow() -> None: # load the data df = load_data() # filter the data filtered_df = filter_data(df) # write data to a report write_report(filtered_df)report_flow()
第五步:使用断言防范运行时错误
Python 中的断言可以理解为向程序下达这样一条指令:“该条件理应恒成立;倘若不成立,就说明程序出现异常。”
基础语法
举个例子:下面这个条件成立,20大于 18。
age = 20 assert age >= 18
因此不会产生任何提示,程序继续运行。
如果条件为假:
age = 16 assert age >= 18
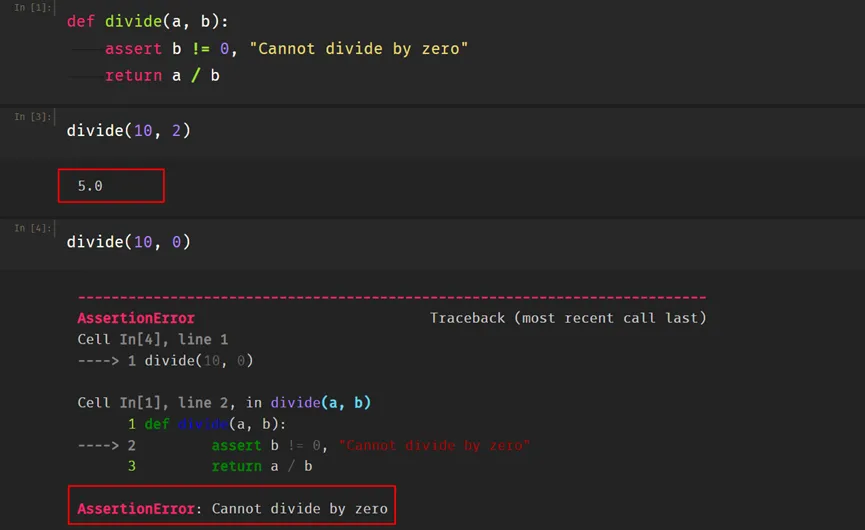
Python 会终止程序运行并抛出错误。
简单实用示例:
设想你正在编写一个用于两个数字相除的函数:
什么时候使用断言
断言主要用于开发阶段查找程序缺陷,用来验证我们预设的条件是否成立。
一旦断言条件不满足,我们希望能立刻收到提醒。
断言不适合处理常规用户错误(例如用户输入非法内容、文件不存在等场景)。这类情况应当使用异常机制,例如条件判断捕获错误,或是try/except 语句。
简易记忆区分:
• assert = “这种情况绝对不应该发生。”
• try + raise = “用户有可能触发这类问题,需要妥善处理。”
添加断言后的更新代码:
def report_flow(): # load the data from csv df = load_data_sales() assert len(df) == 7, "dataframe should have 7 records after loading" # filter the data filtered_df = filter_data(df) assert len(filtered_df) == 2, "dataframe should have 2 records after filtering" # write the report write_report(filtered_df)
第六步:代码分层(整洁代码架构方案)
分层使各模块职责单一,方便阅读与维护。
分层优势:
• 变更隔离:局部修改不影响其他代码
• 测试便捷:支持单独测试模块
• 逻辑复用:核心代码多处共用
• 并行开发:多人同时开发不同层级
• 易于理解:开发人员想要修复单个问题时,无需掌握整套系统的运行原理。
如何在代码中实现分层
落实到实操层面,我们遵循几条简单规范来对代码分层:
• 按主题归类:将功能相关的函数放置在同一个文件(模块)中。
• 函数职责单一:让函数专注完成一项特定任务,不要同时处理互不相关的工作。
• 划定清晰边界:确保各层级只处理自身范畴内的事务(例如:数据库相关代码负责数据处理,网页相关代码负责界面交互)。
• 传递简洁数据载体:使用简易数据对象(例如字典、数据类)在不同层级之间传递数据。
• 隐藏内部实现细节:其他层级只需调用函数,无需关心函数底层是如何实现功能的。
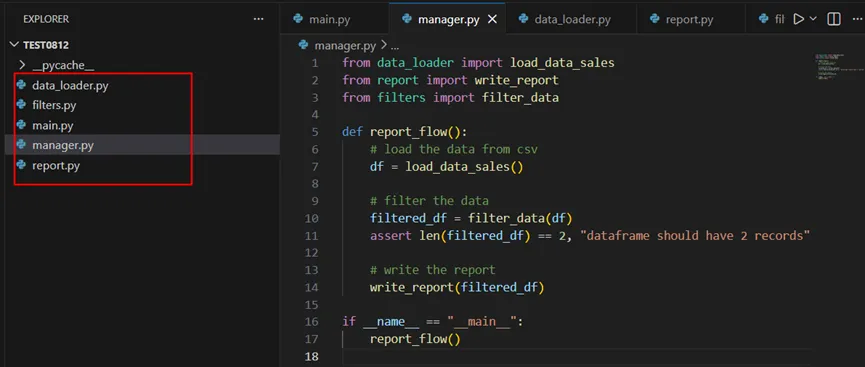
改造代码,实现分层架构:
1)main.py:
from manager import report_flow report_flow()
2)manager.py:
from data_loader import load_data_sales from report import write_report from filters import filter_data def report_flow(): # load the data from csv df = load_data_sales() # filter the data filtered_df = filter_data(df) assert len(filtered_df) == 2, "dataframe should have 2 records" # write the report write_report(filtered_df) if __name__ == "__main__": report_flow()
3)data_loader.py:
import pandas as pdimport os os.chdir(r'E:\TestData')def load_data_sales() -> pd.DataFrame: df = pd.read_csv(r"sales.csv") return df
import pandas as pd import os os.chdir(r'E:\TestData')def write_report(df: pd.DataFrame): df.to_csv(r"report.csv", index=False)
5)filters.py:
import pandas as pd def filter_data(df: pd.DataFrame) -> pd.DataFrame: filtered_df = df[df["region"] == "North"] return filtered_df
其实还有一步就是使代码更加易读,也就是添加一个常量模块constants.py,不过我觉得可有可无,根据自己的喜好来。当然把所有的常量专门放在一个模块中不失为一种好的方法。
今天的分享就到这儿啦,非常感谢您对“Python SQL审天下”公众号的关注和点赞。如果您觉得我的公众号能给您带来一丝丝的收获,请多多转发给您的朋友圈,让更多的人看到并了解。也许您不经意间的点赞和转发,会给他人带来独特的体验和感受。