植被是地球表层系统中最活跃的组分之一,也是全球碳循环、水文过程和粮食安全的关键。利用遥感技术大范围、重复地监测植被状态,是理解地表生态系统动态变化的核心手段。本文将从植物光谱响应的物理基础出发,深入解析归一化植被指数 (NDVI) 与增强型植被指数 (EVI) 的计算原理与抗干扰机制,并提供一套完整的 Python 工程代码,用于处理一整年的多时相卫星影像序列,最终提取农作物的物候生长曲线。
1. 植被的光谱响应机理
要理解植被指数,首先需要了解健康植被叶片的光谱反射特性。这决定了我们为什么选择特定的波段进行计算。
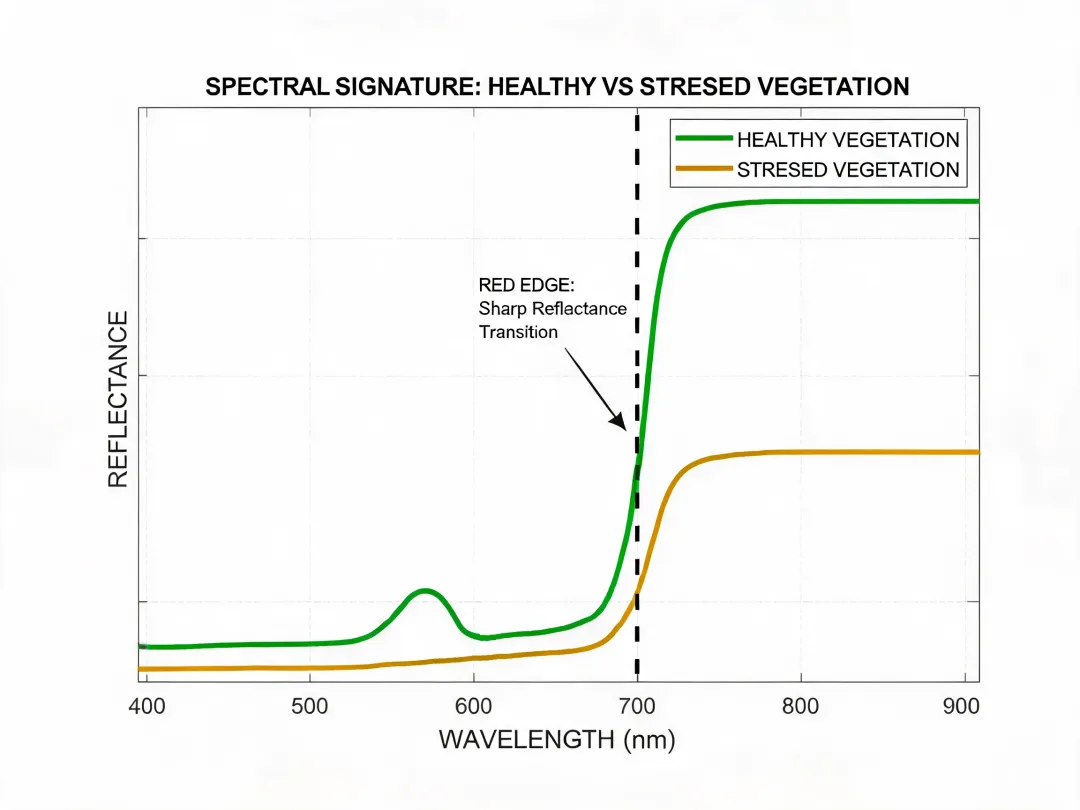
如上图所示,健康绿色植被的光谱曲线呈现两个显著特征:
1.可见光区(约 400-700 nm)的“吸收谷”:植物叶片中的叶绿素对蓝光(450 nm)和红光(650 nm)有强烈的吸收作用,用于光合作用。因此,在蓝波段和红波段,植被反射率很低,图像上呈现暗绿色。2.近红外区(约 700-1300 nm)的“高反射平台”:叶片内部的海绵状栅栏组织细胞结构对近红外光产生多次散射和反射,导致植被在近红外波段(NIR,通常对应 Sentinel-2 的 B08 或 Landsat 的 Band 5)具有很高的反射率,通常可达 40%-50%。
在这两个特征之间,约 680-750 nm 的狭窄区间内,反射率从极低急剧上升到极高,形成一个陡峭的斜坡,被称为 “红边” (Red Edge)。红边的位置和斜率是衡量植被健康状况(如叶绿素含量、水分胁迫)极为敏感的指标,这也是高光谱遥感的优势所在。
2. 植被指数:NDVI 与 EVI
基于上述机理,科学家们设计了一系列植被指数,通过组合特定波段来量化植被的绿度、覆盖度和健康状况。
2.1 归一化植被指数 (NDVI)
NDVI 是应用最广泛的植被指数,其公式直观地利用了红波段与近红外波段的差异:
NDVI = (ρNIR - ρRed) / (ρNIR + ρRed)
其中:
•ρNIR 是近红外波段的地表反射率。•ρRed 是红波段的地表反射率。•NDVI 的取值范围在 -1 到 +1 之间。
物理意义:健康植被因强烈吸收红光并反射近红外光,ρNIR >> ρRed,故 NDVI 值高(通常在 0.6 到 0.9 之间)。土壤、水体、云雪等的 NDVI 值则低得多甚至为负值。
NDVI 的局限性:
•对大气条件敏感:大气中的气溶胶主要散射可见光(尤其是红波段),会使 ρRed 升高,导致 NDVI 被低估。•对土壤背景敏感:在植被稀疏的区域,土壤背景的反射会“污染”像元,使得 NDVI 无法准确反映低覆盖度植被的真实状况。•饱和效应:当植被覆盖度很高时,NDVI 对叶面积指数 (LAI) 的增加不再敏感,出现饱和。
2.2 增强型植被指数 (EVI)
为了克服 NDVI 的上述缺陷,Liu and Huete (1995) 提出了 EVI。EVI 通过引入蓝波段,并加入一个土壤调节系数,对大气和土壤背景的影响进行了优化:
EVI = G * (ρNIR - ρRed) / (ρNIR + C1 * ρRed - C2 * ρBlue + L)
其中:
•G 是增益因子,通常为 2.5。•C1 和 C2 是大气修正系数,分别取 6 和 7.5。•L 是土壤背景调节参数,通常为 1。•ρBlue 是蓝波段的地表反射率。
EVI 的优势:
•更强的大气抗扰性:通过 ρBlue 项,对气溶胶散射进行了显式校正。•减弱土壤背景影响:参数 L 使得 EVI 在稀疏植被区更稳定。•动态范围更宽:在高植被覆盖区域,EVI 不易饱和,能更好地区分茂密植被的微小差异。
3. Python 实现:多时相影像处理与物候曲线提取
接下来,我们将使用 Python 的 Rasterio 库,处理一整年的 Sentinel-2 影像时间序列,计算每月的 NDVI 和 EVI,并绘制一个典型农田像元的物候生长曲线。
我们假设已经拥有按月整理好的 Sentinel-2 数据(如 12 个 .tif 文件,每个文件包含红、蓝、近红外三个波段)。
3.1 数据准备与波段读取
首先,定义一个函数来读取指定月份影像的指定波段数据。这里我们假设每个文件的波段顺序固定为 [B02 (蓝), B04 (红), B08 (近红外)]。
import rasterioimport numpy as npimport osimport globimport matplotlib.pyplot as pltdef read_band_from_stack(stack_path, band_index): """ 从多波段栅格文件中读取指定索引的波段数据。 参数: stack_path (str): 输入的多波段 TIF 文件路径。 band_index (int): 要读取的波段索引 (1-based)。 返回: numpy.ndarray: 波段数据数组。 """ with rasterio.open(stack_path) as src: band_data = src.read(band_index) # 获取元数据用于后续写入或参考 profile = src.profile transform = src.transform crs = src.crs return band_data, profile, transform, crs
3.2 植被指数计算
我们定义计算 NDVI 和 EVI 的函数。这些函数将直接操作 NumPy 数组。
def calculate_ndvi(nir_band, red_band): """ 计算 NDVI。 """ # 避免除以零 with np.errstate(divide='ignore', invalid='ignore'): ndvi = (nir_band.astype(float) - red_band.astype(float)) / (nir_band.astype(float) + red_band.astype(float)) # 将无效值(如 NaN)设置为 -1 或其他特定填充值 ndvi[np.isnan(ndvi)] = -1.0 return ndvidef calculate_evi(nir_band, red_band, blue_band, G=2.5, C1=6, C2=7.5, L=1): """ 计算 EVI。 """ with np.errstate(divide='ignore', invalid='ignore'): evi = G * (nir_band.astype(float) - red_band.astype(float)) / \ (nir_band.astype(float) + C1 * red_band.astype(float) - C2 * blue_band.astype(float) + L) evi[np.isnan(evi)] = -1.0 return evi
3.3 批量处理时间序列
现在,编写主流程来循环处理 12 个月的数据,并存储结果。
def process_annual_timeseries(monthly_stack_paths, output_dir, pixel_coords=None): """ 处理一年的多时相影像,计算每月 NDVI 和 EVI。 参数: monthly_stack_paths (list): 包含12个月影像路径的列表,需按时间排序。 output_dir (str): 输出目录。 pixel_coords (tuple, optional): 特定像元的 (row, col) 坐标,用于提取物候曲线。 """ os.makedirs(output_dir, exist_ok=True) monthly_ndvi = [] monthly_evi = [] time_axis = [] for i, path in enumerate(monthly_stack_paths): month = i + 1 print(f"正在处理第 {month} 月数据: {os.path.basename(path)}") # 读取三个波段 (假设索引:1-Blue, 2-Red, 3-NIR) blue, _, _ = read_band_from_stack(path, 1) # 蓝波段 red, _, _ = read_band_from_stack(path, 2) # 红波段 nir, profile, transform, _ = read_band_from_stack(path, 3) # 近红外波段 # 计算指数 ndvi_month = calculate_ndvi(nir, red) evi_month = calculate_evi(nir, red, blue) # 保存结果为新的 GeoTIFF ndvi_out_path = os.path.join(output_dir, f'NDVI_2023_{month:02d}.tif') evi_out_path = os.path.join(output_dir, f'EVI_2023_{month:02d}.tif') # 更新 profile 为单波段 profile.update(count=1, dtype='float32') with rasterio.open(ndvi_out_path, 'w', **profile) as dst: dst.write(ndvi_month.astype(np.float32), 1) with rasterio.open(evi_out_path, 'w', **profile) as dst: dst.write(evi_month.astype(np.float32), 1) # 收集时间序列数据 monthly_ndvi.append(ndvi_month) monthly_evi.append(evi_month) time_axis.append(month) # 如果指定了特定像元,提取该点的时间序列值 if pixel_coords is not None: row, col = pixel_coords # 检查边界 if 0 <= row < ndvi_month.shape[0] and 0 <= col < ndvi_month.shape[1]: ndvi_val = ndvi_month[row, col] evi_val = evi_month[row, col] print(f" 像元 ({row},{col}) - NDVI: {ndvi_val:.3f}, EVI: {evi_val:.3f}") return monthly_ndvi, monthly_evi, time_axis# --- 主程序入口 ---if __name__ == '__main__': # 假设数据目录结构 DATA_DIR = r'E:\Data\Sentinel2_Monthly' OUTPUT_DIR = r'E:\Data\VegetationIndex_TimeSeries' # 按月份排序获取文件列表 monthly_files = sorted(glob.glob(os.path.join(DATA_DIR, '*_stack.tif'))) if len(monthly_files) != 12: print(f"警告:预期12个月的数据,实际找到 {len(monthly_files)} 个文件。") else: # 假设我们想追踪一个位于影像中心的像元 # 首先获取影像尺寸 with rasterio.open(monthly_files[0]) as src: height, width = src.shape center_pixel = (height // 2, width // 2) print(f"将追踪像元坐标: {center_pixel}") # 执行处理 ndvi_stack, evi_stack, months = process_annual_timeseries( monthly_files, OUTPUT_DIR, pixel_coords=center_pixel ) print("年度时间序列处理完成!") print(f"NDVI 影像已保存至: {OUTPUT_DIR}")
3.4 绘制物候生长曲线
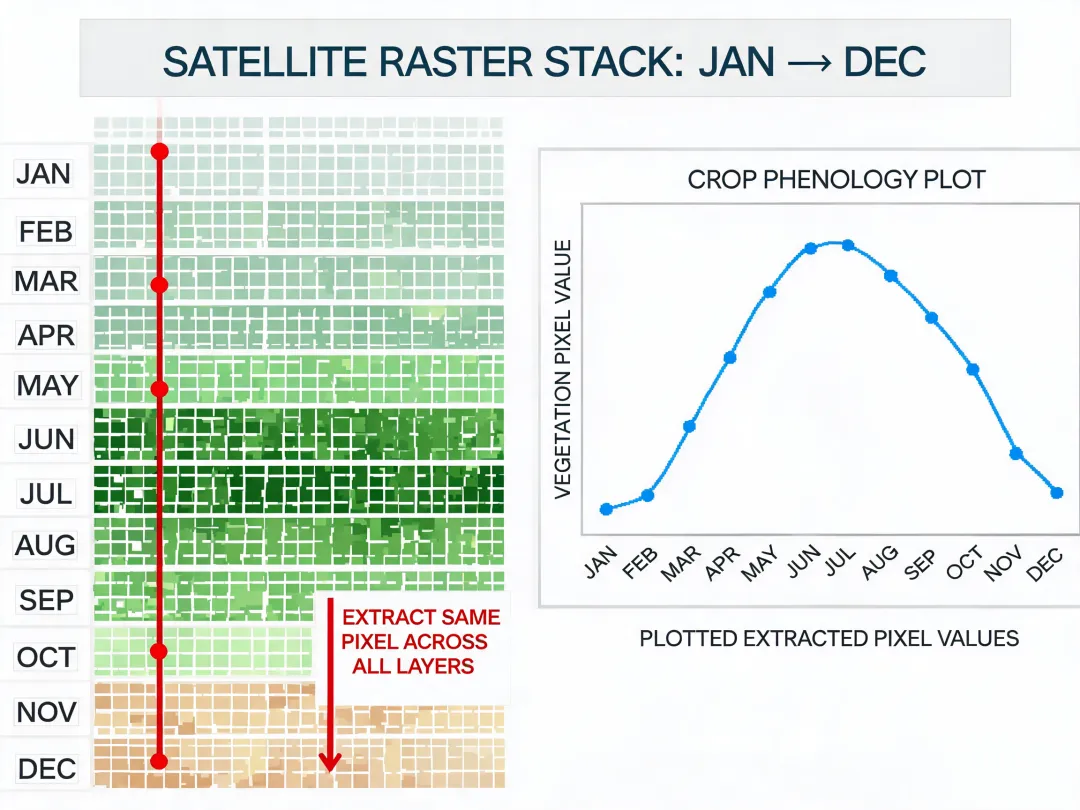
最后,我们提取之前指定像元的值,并绘制其全年的 NDVI 和 EVI 变化曲线,以观察农作物的物候期(如返青、抽穗、成熟、收割)。
def plot_phenology_curve(months, ndvi_stack, evi_stack, pixel_coords): """ 绘制指定像元的 NDVI/EVI 物候曲线。 """ row, col = pixel_coords ndvi_pixel = [ndvi_stack[m][row, col] for m in range(len(months))] evi_pixel = [evi_stack[m][row, col] for m in range(len(months))] plt.figure(figsize=(12, 6)) plt.plot(months, ndvi_pixel, 'g-o', linewidth=2, markersize=6, label='NDVI') plt.plot(months, evi_pixel, 'r-s', linewidth=2, markersize=6, label='EVI') plt.xlabel('月份', fontsize=12) plt.ylabel('指数值', fontsize=12) plt.title(f'像元 ({row}, {col}) 的年度植被指数物候曲线', fontsize=14) plt.legend(fontsize=11) plt.grid(True, alpha=0.3) plt.xticks(months) plt.ylim(-0.1, 1.0) plt.tight_layout() # 保存图表 plt.savefig(os.path.join(OUTPUT_DIR, f'phenology_curve_{row}_{col}.png'), dpi=150) plt.show() print(f"物候曲线图已保存。")# 在主程序末尾调用# plot_phenology_curve(months, ndvi_stack, evi_stack, center_pixel)
4. 物候曲线解读与应用
生成的物候曲线(如上代码所绘)是遥感应用于农业和生态管理的直接成果。一条典型的北半球中纬度地区冬小麦生长曲线可能呈现以下特征:
•春季(3-4月):NDVI/EVI 迅速上升,对应作物返青和快速生长期。•初夏(5-6月):达到峰值,对应抽穗和灌浆期,植被光合作用最旺盛。•盛夏(7月):可能出现急剧下降,这往往标志着作物成熟和收割。•夏末秋初(8-9月):如果进行复种(如种植玉米),曲线可能再次上升。
通过对比不同年份、不同地块的物候曲线,可以监测作物生长异常(如干旱、病虫害)、进行产量估算、识别作物类型,甚至为精准农业中的灌溉和施肥决策提供依据。
5. 从 NDVI/EVI 到高光谱分析
本文聚焦于基于多光谱数据的宽波段植被指数。当数据源升级为高光谱影像(如 PRISMA, EnMAP,或未来国产的珠海一号等)时,我们能够利用成百上千个连续窄波段,进行更精细的分析:
•红边位置 (REP):精确定位反射率陡升的波段位置,与叶绿素含量强相关。•光谱特征吸收深度:分析水分、氮素等生化参数引起的光谱吸收特征。•光谱指数库:开发针对特定作物或胁迫状态的专用窄波段指数,如 PRI(光化学反射指数,与光合效率相关)。
Python 中的 Spectral 和 HyperSpec 等库为处理高光谱数据栈提供了便利工具,其核心思路与本文介绍的多时相处理框架一脉相承。
结语
植被指数时间序列分析,是将离散的卫星影像转化为连续生态过程信息的桥梁。本文从光谱原理出发,详细阐述了 NDVI 和 EVI 的物理内涵与工程实现。通过 Python 构建的自动化处理流水线,我们能够从海量影像中提取出富有洞察力的物候生长曲线。无论是用于大范围的农业估产、生态系统健康评估,还是全球变化研究,这套方法都提供了坚实的技术基础。真正的价值,在于将这些数字指标与我们脚下土地的真实生命节律联系起来。
 10个月宝宝每天需要喝多少奶粉?