当前位置:首页>python>【大数据毕设选题】Python+Spark+Hadoop:淘宝化妆品数据分析系统源码 毕业设计 选题推荐 毕设选题 数据分析 机器学习 深度学习

【大数据毕设选题】Python+Spark+Hadoop:淘宝化妆品数据分析系统源码 毕业设计 选题推荐 毕设选题 数据分析 机器学习 深度学习

  • 2026-09-10 06:44:36
【大数据毕设选题】Python+Spark+Hadoop:淘宝化妆品数据分析系统源码 毕业设计 选题推荐 毕设选题 数据分析 机器学习 深度学习

一

淘宝化妆品销售数据分析可视化系统-简介

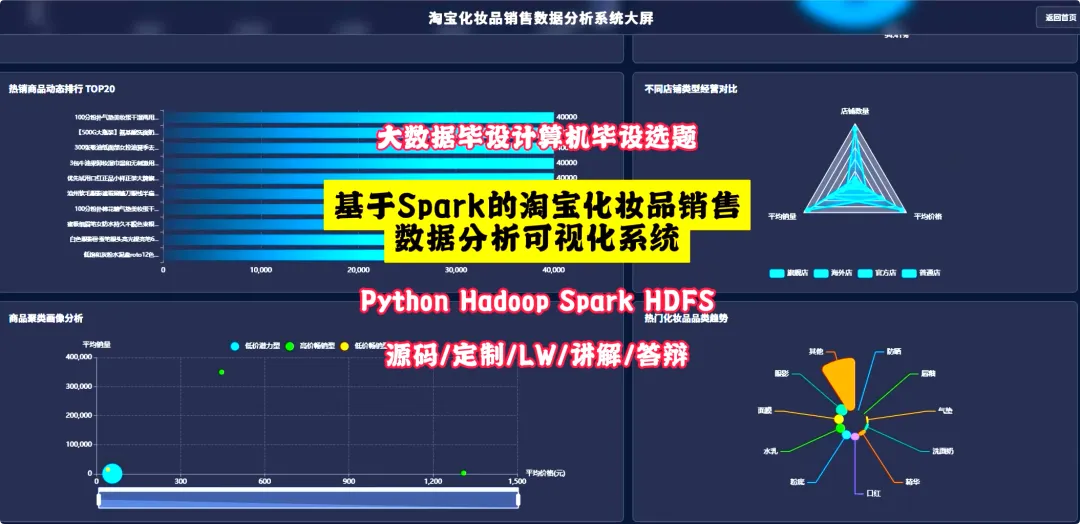
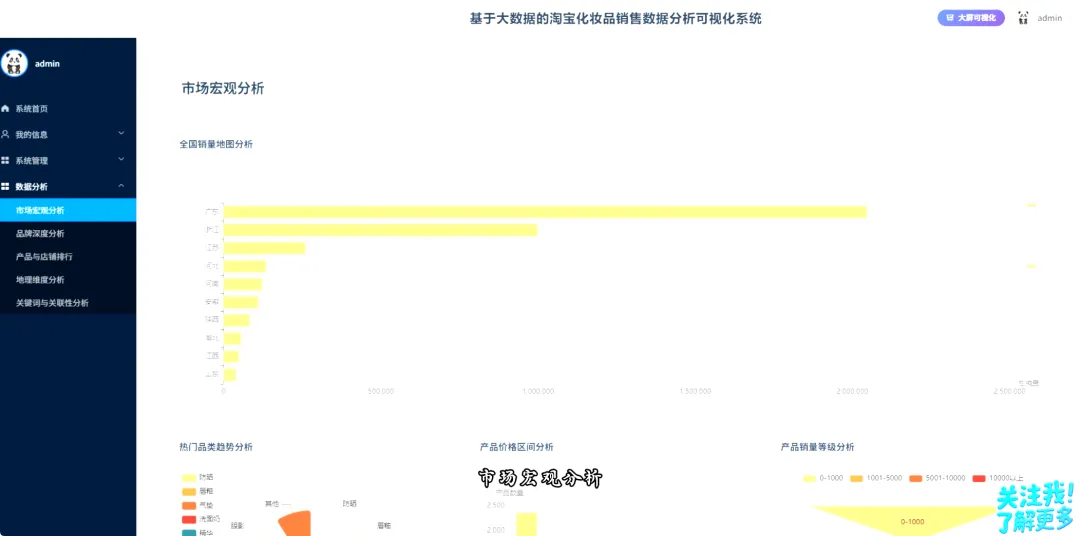
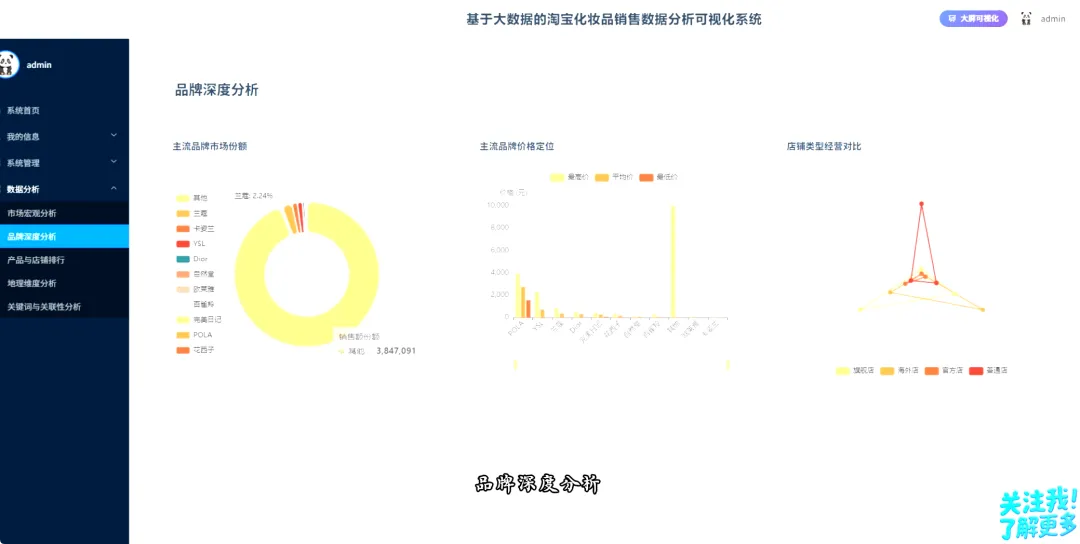
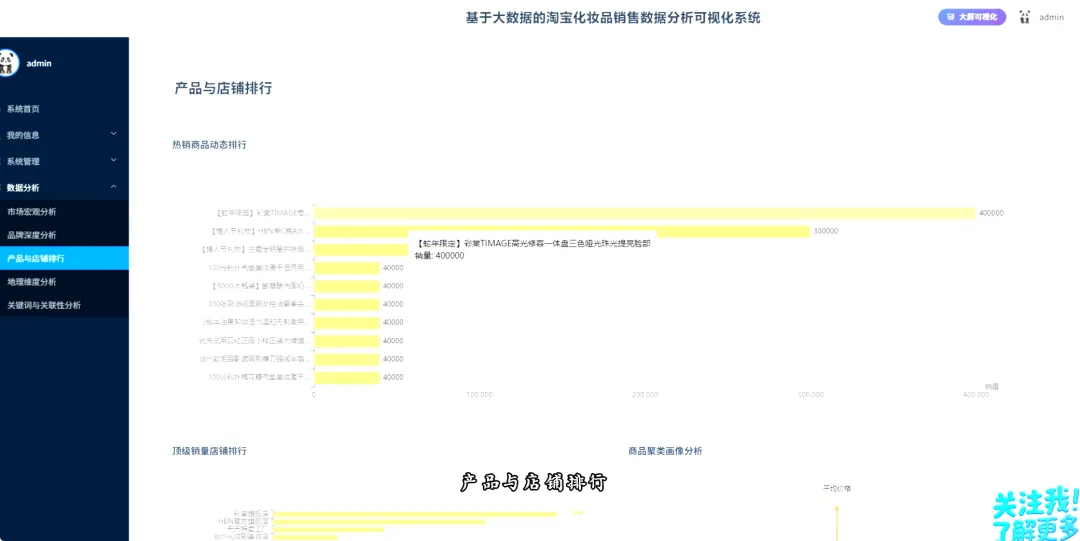
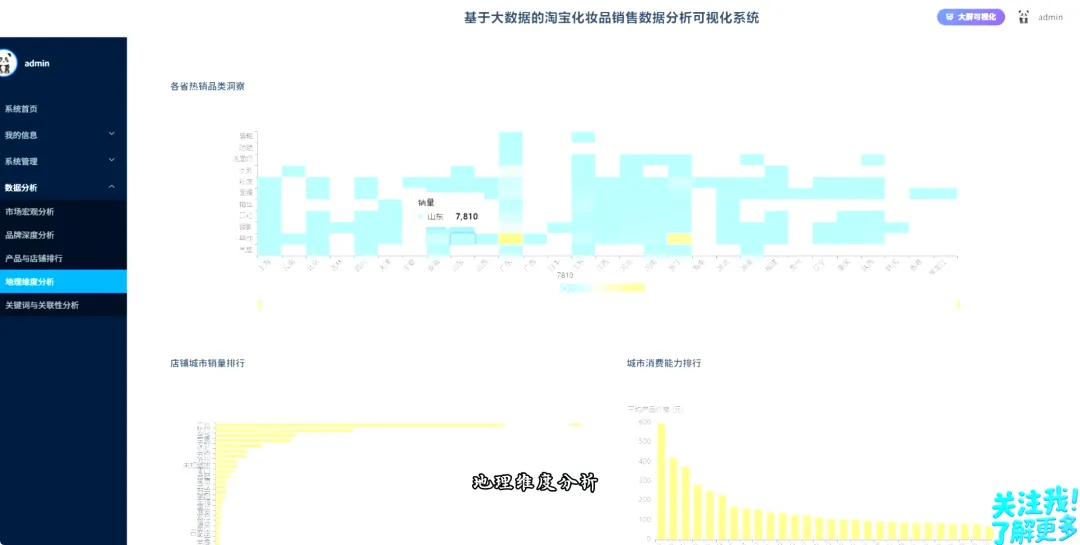
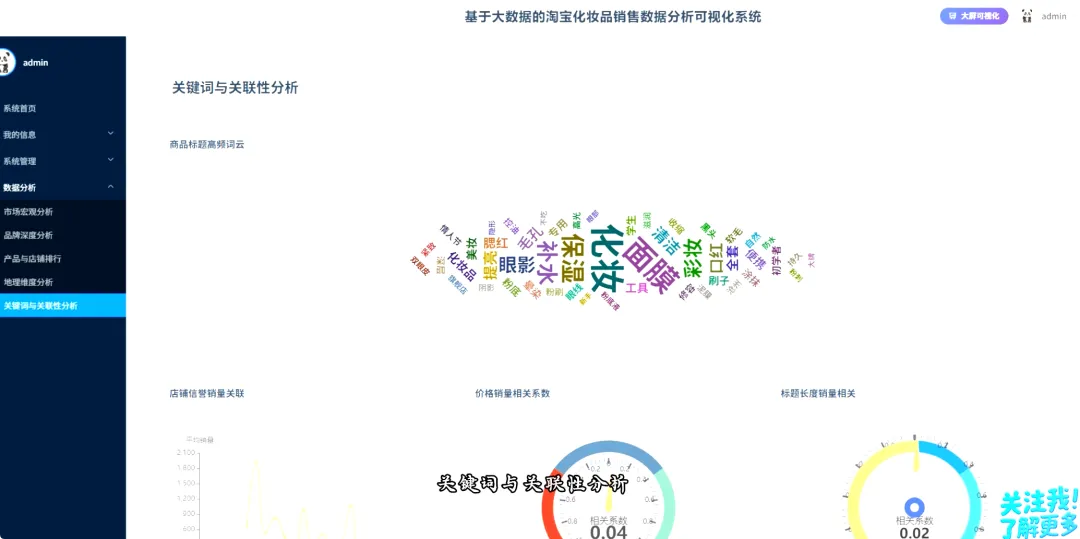
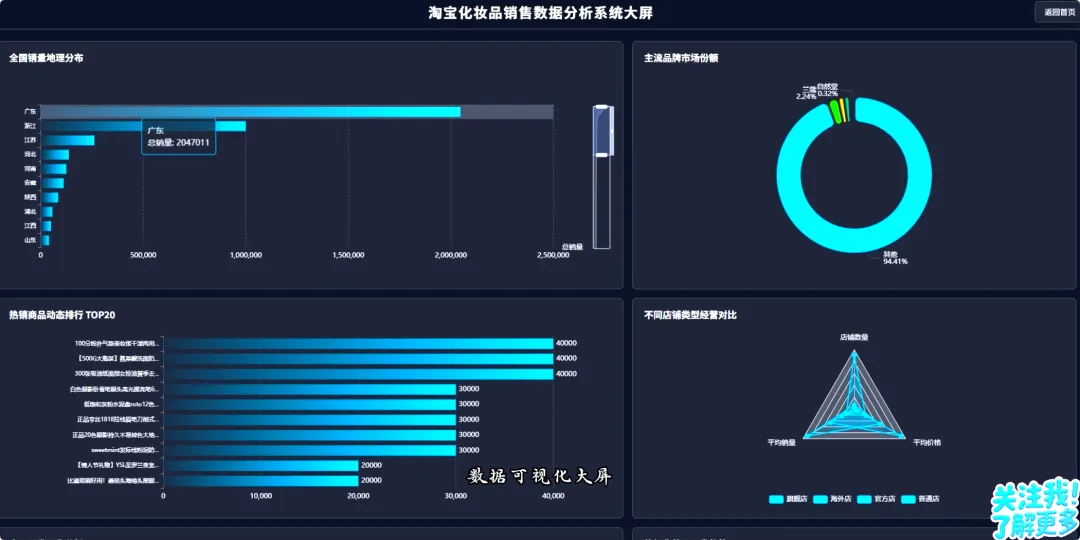
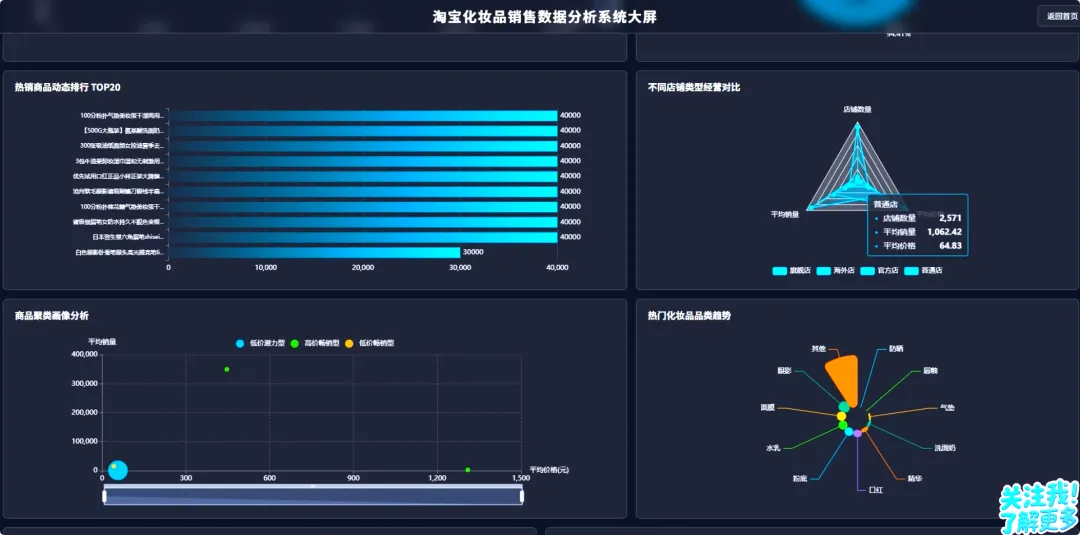
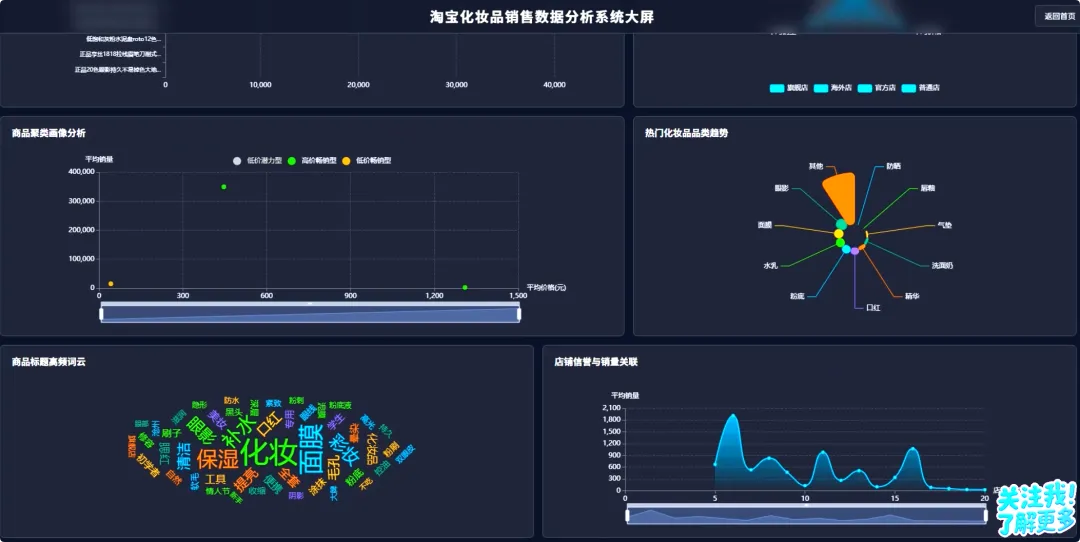
本系统“基于Spark的淘宝化妆品销售数据分析可视化系统”是一个集大数据处理、后端服务与前端可视化于一体的综合性数据分析平台。在技术架构上,系统采用Hadoop HDFS作为海量淘宝化妆品销售数据的分布式存储基础,确保数据的可靠性和可扩展性。核心计算引擎选用Apache Spark,利用其内存计算能力和高效的DAG执行引擎,通过Spark SQL对结构化数据进行快速查询与聚合分析,并结合Python生态中的Pandas与NumPy库进行复杂的数据预处理与特征工程。后端服务基于Python语言和Django框架开发,负责构建RESTful API,处理前端请求,并将Spark分析后的结果数据持久化存储到MySQL数据库中,实现计算结果的高效检索。前端界面则采用Vue.js框架结合ElementUI组件库,构建了响应式、用户友好的操作界面,并借助Echarts强大的图表渲染能力,将17个维度的分析结果——如价格区间分布、热门商品TOP N、品牌市场份额、全国消费力热力图以及基于K-Means算法的商品聚类等——以直观的柱状图、饼图、地图散点图和词云图等形式动态呈现,为用户提供了从宏观市场格局到微观商品特征的全方位洞察。

二

淘宝化妆品销售数据分析可视化系统-背景意义

选题背景

随着电子商务的迅猛发展,线上购物已成为人们日常生活的重要组成部分,其中化妆品类目以其高复购率和强社交属性,成为了竞争异常激烈的市场板块。淘宝平台作为国内领先的电商网站,每天产生着海量的商品交易数据,这些数据背后隐藏着消费者的购买偏好、价格敏感度、品牌忠诚度以及地域消费差异等极具价值的信息。对于商家而言,如何从这片数据海洋中提炼出有效的商业洞察,用以指导产品定价、营销策略和库存管理,成为其在激烈市场竞争中脱颖而出的关键。然而,传统的数据处理工具面对如此规模的数据量往往显得力不从心,无法进行快速、深入的分析。因此,构建一个能够高效处理并可视化这些电商数据,特别是针对化妆品这一垂直领域的分析系统,具有非常现实的迫切需求。

选题意义

本课题的意义在于,它将前沿的大数据技术与具体的商业分析场景相结合,提供了一个具有实践价值的解决方案。从技术学习角度看,该项目完整地覆盖了从数据采集、存储、清洗、计算分析到最终可视化展示的全过程,让开发者能够深入理解和实践Hadoop、Spark等主流大数据框架,并将其与Python、Django、Vue等Web开发技术相融合,有效提升综合技术能力和项目实战经验。从应用价值层面讲,系统所实现的多维度分析功能,能够帮助化妆品行业的从业者,特别是中小卖家,更清晰地把握市场动态。比如,通过分析热门商品和品牌,可以辅助选品决策;通过研究地域消费差异,可以实现精准的区域营销;通过探究价格与销量的关系,可以优化定价策略。虽然作为一个毕业设计,其分析深度和模型复杂度有限,但它为解决实际问题提供了一个清晰的思路和一套可行的技术实现路径,具备良好的参考和借鉴意义。

三

淘宝化妆品销售数据分析可视化系统-技术框架

大数据框架:Hadoop+Spark(本次没用Hive,支持定制)开发语言:Python或Java(两个版本都支持)后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy数据库:MySQL

四

淘宝化妆品销售数据分析可视化系统-视频

已关注
关注
重播 分享 赞

数据处理难+可视化复杂?基于Spark的淘宝化妆品分析系统一次解决

五

淘宝化妆品销售数据分析可视化系统-图片展示

六

淘宝化妆品销售数据分析可视化系统-代码展示

from pyspark.sql import SparkSessionfrom pyspark.ml.feature import VectorAssemblerfrom pyspark.ml.clustering import KMeansdef get_top_n_products(spark, n=10):    df = spark.read.csv("hdfs://.../taobao_cosmetics.csv", header=True, inferSchema=True)    df.createOrReplaceTempView("products")    top_n_df = spark.sql(f"SELECT title, salesnum FROM products ORDER BY cast(salesnum as int) DESC LIMIT {n}")    return top_n_df.toPandas().to_dict('records')def get_province_distribution(spark):    df = spark.read.csv("hdfs://.../taobao_cosmetics.csv", header=True, inferSchema=True)    df.createOrReplaceTempView("products")    province_df = spark.sql("SELECT province, SUM(cast(salesnum as int)) as total_sales FROM products GROUP BY province")    return province_df.toPandas().to_dict('records')def kmeans_product_clustering(spark, k=4):    df = spark.read.csv("hdfs://.../taobao_cosmetics.csv", header=True, inferSchema=True)    df = df.na.drop(subset=["jiage", "salesnum"])    assembler = VectorAssembler(inputCols=["jiage", "salesnum"], outputCol="features")    df_with_features = assembler.transform(df)    kmeans = KMeans(featuresCol="features", k=k)    model = kmeans.fit(df_with_features)    clustered_df = model.transform(df_with_features)    result_df = clustered_df.select("title", "jiage", "salesnum", "prediction")    return result_df.toPandas().to_dict('records')
七

结语

💬 计算机毕业设计过程中遇到任何疑难和需求,欢迎随时与我沟通探讨。扫描文章首尾【二维码】或点击公众号底部菜单栏即可添加。全天候在线,有问必答。祝您毕设顺利,答辩拿高分!🚀

联系我们

        商务合作

        微信号:JSJBSZDS

        关注公众号:计算机毕设指导师

~~感谢您抽出时间来阅读此文~~

最新文章

随机文章