由于借助 AI 工具学习编程已经变得非常容易了,因此之后的课程就不再默认进行视频讲解了,如果特别需要视频讲解也可以联系李老师预约讲解~讲义材料学习过程中遇到的问题也可以及时与李老师联系。
购买 RStata 名师讲堂会员即可参加该课程啦(之前的和未来的都可以参加)!
价格:2800/年 或者 4800/长期
购买会员可以从这里下单:https://rstata.duanshu.com/#/card/list/
名师讲堂会员权益:
- 参加平台上的其他 R 语言和 Stata 的课程;
- 以会员折扣价购买我们分享的数据资料(10 元/份);
* 如果发票可添加小编微信 r_stata2 (RStata 李老师)开具。如需数据资料,购买后可添加小编微信免费领取数据折扣卡。
更多关于 RStata 会员的更多信息可添加微信号 r_stata2 咨询:
课程主页(点击文末的阅读原文即可跳转):https://rstata.duanshu.com/#/brief/course/ed1e11bf437243c6847ba1e7aa473f40
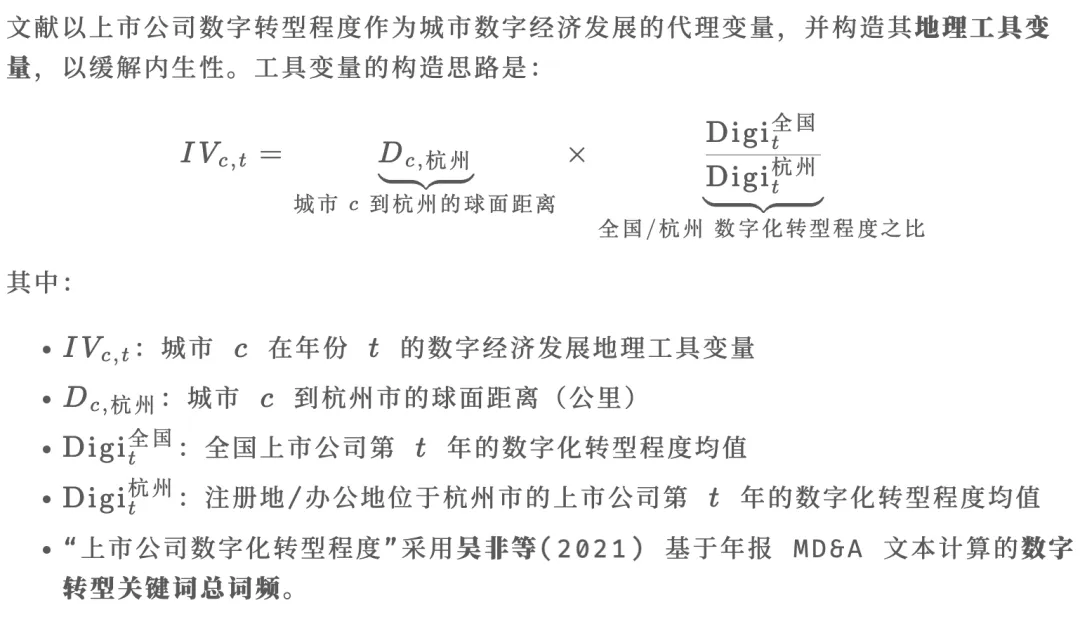
今天给大家分享使用 Python 测算城市数字经济发展地理工具变量(IV)的方法。该方法参考自杨本建、唐金汶《数字经济与区域产业布局》(《经济研究》2026 年第 3 期)。
本文的代码全部在由 reticulate 创建与管理的 Python 虚拟环境中运行,与系统 Python(如 Anaconda)完全隔离,避免包版本冲突。
指标来源与计算原理
地理工具变量(Geographic Instrumental Variable)
计算步骤概述
整个计算过程分为以下几个步骤:
- 生成城市质心:用
geopandas 读取 2021 年行政区划(地级市 .shp),直接得到每个市域多边形的面积加权质心经纬度。 - 读取源数据:读取上市公司数字转型关键词总词频
.dta 与上市公司注册/办公地址 .dta。 - 计算年度数字化转型程度:分别计算全国均值,以及杭州(注册地址口径 / 办公地址口径)均值,并求比值。
- 计算到杭州距离:用
pyproj.Geod(WGS84) 计算各城市质心到杭州质心的测地距离(与 Stata geodist、R sf::st_distance 等价)。 - 构造面板与工具变量:对(城市 × 年份)做笛卡尔积,乘以比值得到地理工具变量 IVIVIV。
- 写盘与绘图:保存 4 个带中文变量标签的
.dta,并绘制 2 张结果图。
使用 reticulate 创建与管理 Python 虚拟环境
在 R 中通过 reticulate 包来调用 Python,最好的实践是为项目创建一个专属的 Python 虚拟环境,将所需依赖隔离到独立空间,避免与系统 Python(如 Anaconda)发生版本冲突。
重要说明(避免"已初始化"报错):reticulate 在 R 会话中只能绑定一次 Python——一旦某个 {python} 代码块运行,Python 解释器就被锁定,之后再调用 use_virtualenv() 会报错:
ERROR: The requested version of Python cannot be used, as another version has already been initialized.因此,虚拟环境的激活必须在所有 {python} 代码块之前完成。本文档的解决方案是在 setup chunk 中通过 Sys.setenv(RETICULATE_PYTHON = ...) 提前锁定 Python 路径,这是 reticulate 选取 Python 的最高优先级入口。
安装 reticulate(仅首次)
# 设置 CRAN 镜像(knit 时 R 处于非交互模式,不会自动选择镜像)options(repos = c(CRAN = "https://mirrors.tuna.tsinghua.edu.cn/CRAN/"))# 仅在尚未安装时才安装,避免每次 knit 都重装if (!requireNamespace("reticulate", quietly = TRUE)) { install.packages("reticulate") message("reticulate 安装完成!") message("reticulate 已安装,版本:", packageVersion("reticulate"))虚拟环境初始化原理(已在 setup chunk 中完成)
本文档的 setup chunk(隐藏运行)包含如下逻辑:
proj_dir <- dirname(knitr::current_input())# 本 Rmd 所在目录.venv_path <- file.path(proj_dir,".venv").venv_python <- virtualenv_python(.venv_path)if(!file.exists(.venv_python)){ virtualenv_create(.venv_path) .venv_python <- virtualenv_python(.venv_path)# 通过环境变量抢先锁定 Python(优先级最高,早于任何 {python} chunk)Sys.setenv(RETICULATE_PYTHON = .venv_python)use_virtualenv(.venv_path, required =TRUE)这样做的关键在于:knitr 在处理第一个 {python} chunk 时,reticulate 已经通过 RETICULATE_PYTHON 环境变量知道要使用 .venv,不会再去碰 Anaconda。
在虚拟环境中安装 Python 包(仅首次)
本项目需要的 Python 包:numpy、pandas、geopandas、shapely、pyproj、matplotlib、pyreadstat。
"numpy", "pandas", "geopandas", "shapely","pyproj", "matplotlib", "pyreadstat"installed <- py_list_packages(.venv_path)$packageneed_install <- setdiff(py_pkgs, installed)if (length(need_install) > 0) { virtualenv_install(.venv_path, packages = need_install) message("已安装缺失的包:", paste(need_install, collapse = ", ")) message("所有 Python 包已就绪,无需安装")验证激活状态
# 验证当前绑定的 Python 路径(应指向 .venv 目录)查看已安装的包
pkgs <- py_list_packages(.venv_path)key_pkgs <- c("numpy", "pandas", "geopandas", "shapely","pyproj", "matplotlib", "pyreadstat")pkgs[pkgs$package %in% key_pkgs, c("package", "version")]虚拟环境管理常用命令
# virtualenv_remove(.venv_path)# virtualenv_install(.venv_path, packages = "geopandas", ignore_installed = TRUE)
运行计算脚本
下方的 {python} 代码块通过 runpy.run_path() 在已激活的 .venv 中执行计算地理工具变量.py(该脚本是全部计算与绘图的唯一实现,保证"单一事实来源"):
脚本需要下载讲义材料查看~
- 生成 4 个带中文变量标签的
.dta(位于 城市数字经济发展地理工具变量_结果/)
runpy.run_path("计算地理工具变量.py", run_name="__main__")
结果校验
校验生成的 .dta 行数与中文变量标签是否正确:
f = "城市数字经济发展地理工具变量_结果/城市数字经济发展地理工具变量_注册地址_2001-2024.dta"df, meta = pyreadstat.read_dta(f)print(f"注册地址面板:{df.shape[0]} 行 × {df.shape[1]} 列")print(f" {c} : {meta.column_names_to_labels.get(c)}")#> dist_hz_km : 各城市到杭州的球面距离(km)#> ratio_natl_hz : 全国/杭州(注册地址)上市公司数字化转型程度之比#> iv_product : 地理工具变量(距离×比值)查看 2024 年杭州(距离应为 0)及部分代表性城市的工具变量取值:
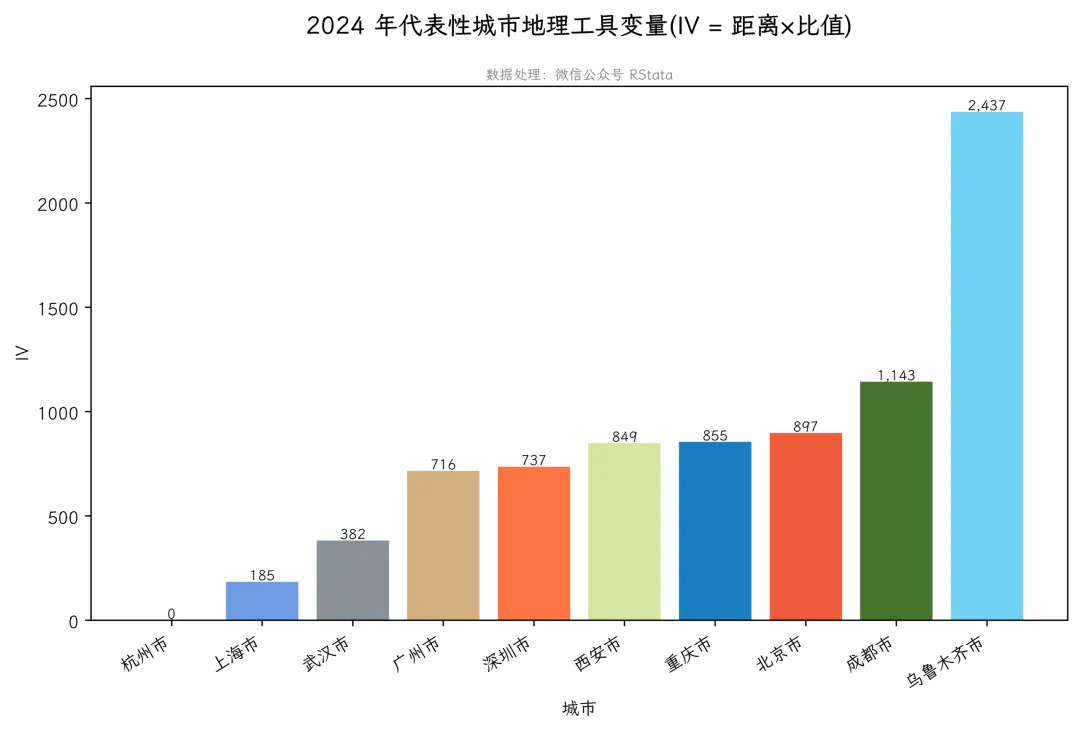
import pyreadstat, pandas as pdpd.set_option("display.width", 120)f = "城市数字经济发展地理工具变量_结果/城市数字经济发展地理工具变量_注册地址_2001-2024.dta"df, _ = pyreadstat.read_dta(f)sub = df[df["year"] == 2024]show = ["杭州市", "上海市", "深圳市", "北京市", "乌鲁木齐市"]print(sub[sub["city"].isin(show)][ ["city", "dist_hz_km", "ratio_natl_hz", "iv_product"]].to_string(index=False))#> city dist_hz_km ratio_natl_hz iv_product#> 上海市 241.801002 0.764106 184.761480#> 乌鲁木齐市 3189.374061 0.764106 2437.018316#> 北京市 1174.523758 0.764106 897.460084#> 杭州市 0.000000 0.764106 0.000000#> 深圳市 963.924290 0.764106 736.539868
数据可视化
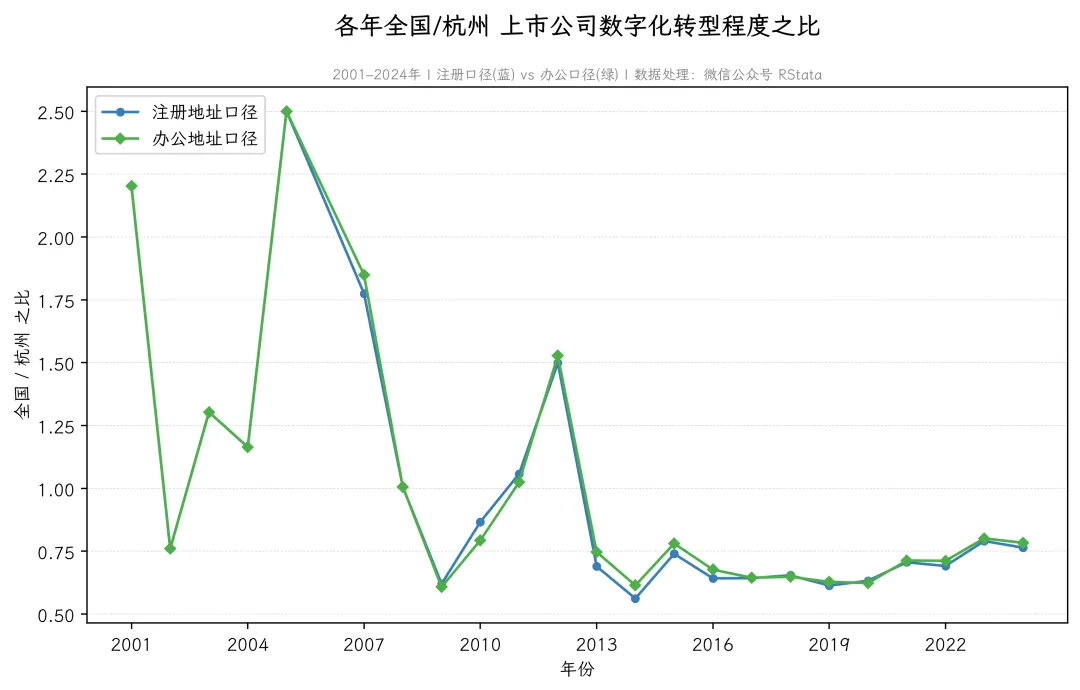
图 1:各年"全国/杭州"数字化转型程度之比趋势
# 图片由 source_python("计算地理工具变量.py") 生成图 2:2024 年代表性城市地理工具变量(IV)柱状图
如何参加课程?
购买 RStata 名师讲堂会员即可参加该课程啦(之前的和未来的都可以参加)!
价格:2800/年 或者 4800/长期
购买会员可以从这里下单:https://rstata.duanshu.com/#/card/list/
名师讲堂会员权益:
- 参加平台上的其他 R 语言和 Stata 的课程;
- 以会员折扣价购买我们分享的数据资料(10 元/份);
* 如果发票可添加小编微信 r_stata2 (RStata 李老师)开具。如需数据资料,购买后可添加小编微信免费领取数据折扣卡。
更多关于 RStata 会员的更多信息可添加微信号 r_stata2 咨询:
课程主页(点击文末的阅读原文即可跳转):https://rstata.duanshu.com/#/brief/course/ed1e11bf437243c6847ba1e7aa473f40
 10个月宝宝每天需要喝多少奶粉?