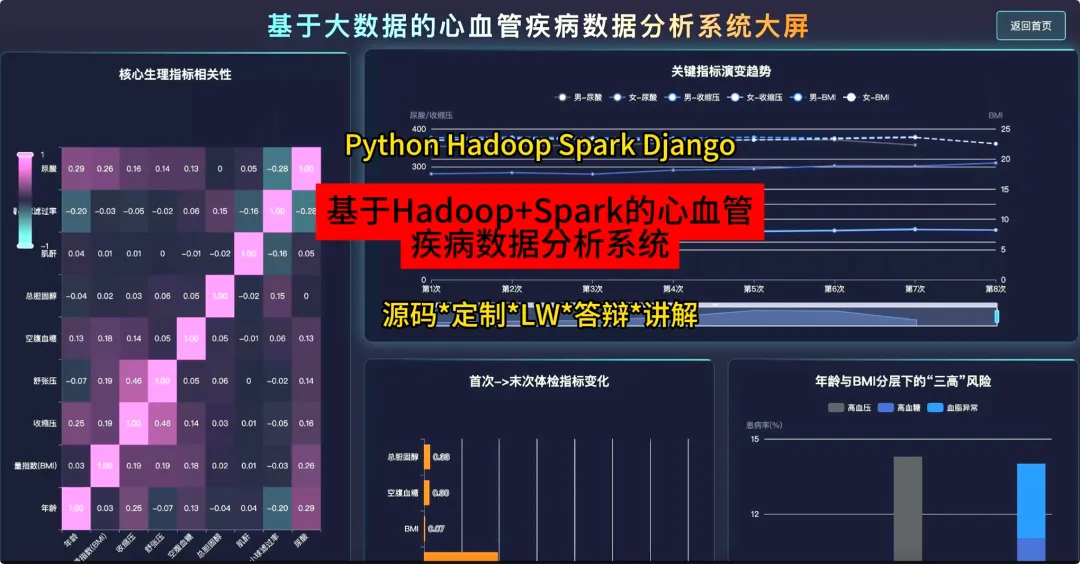
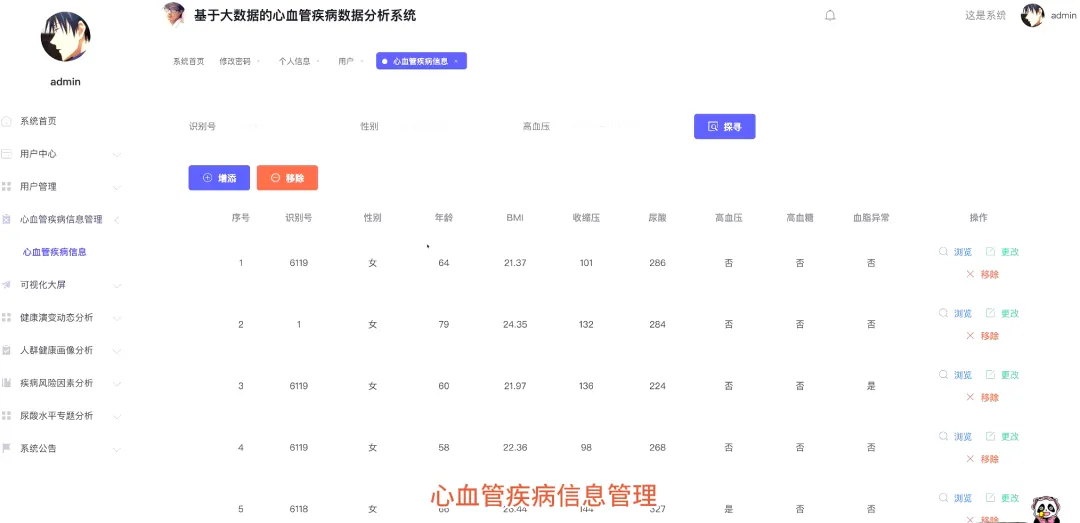
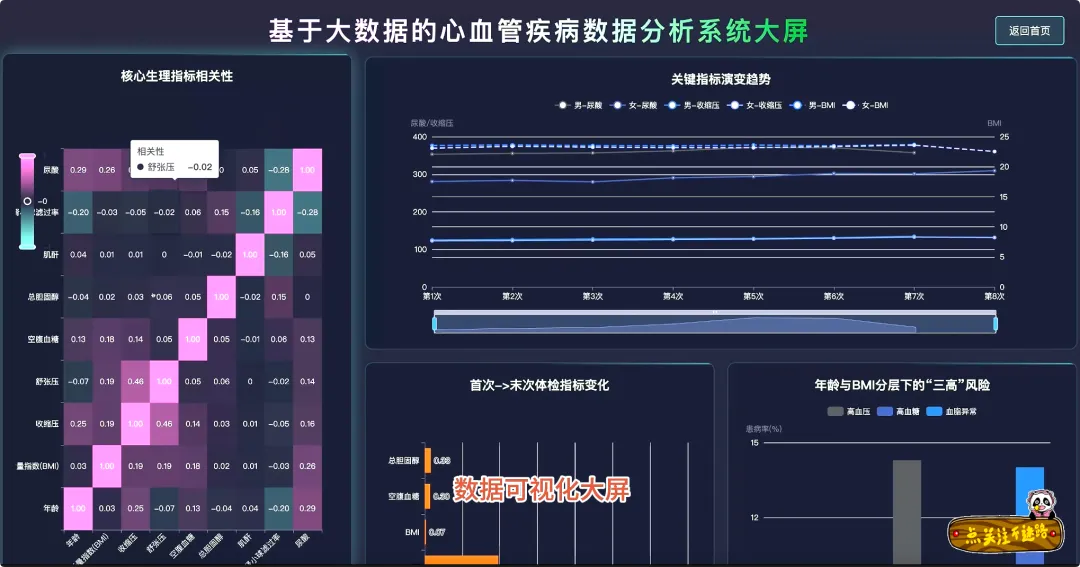
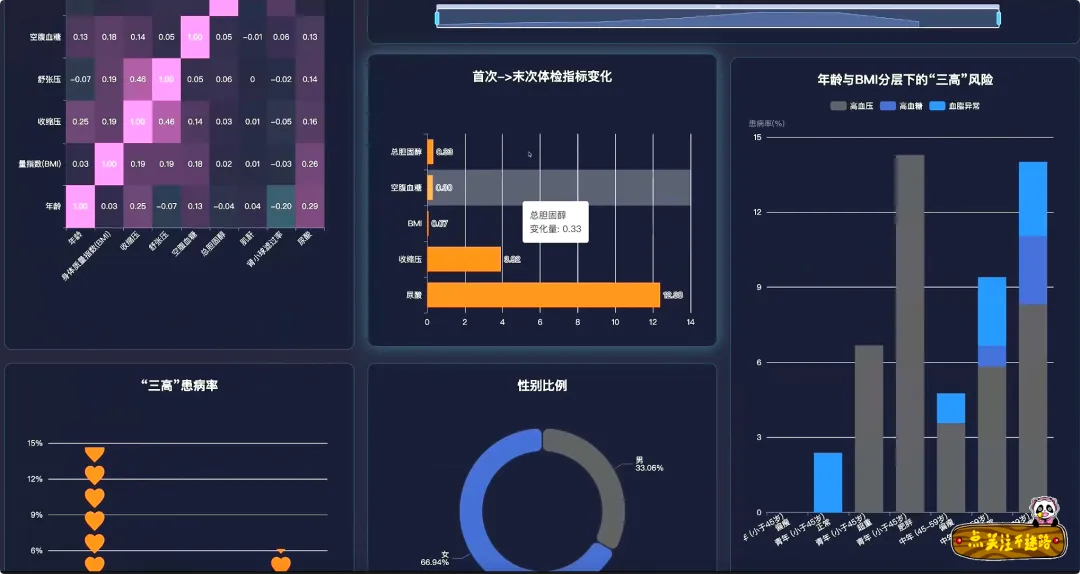
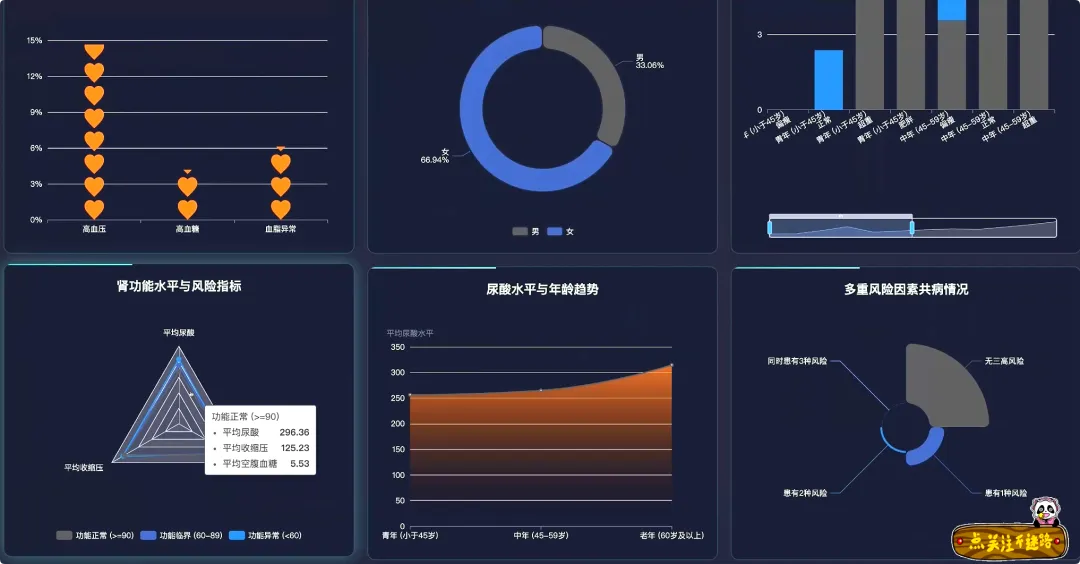
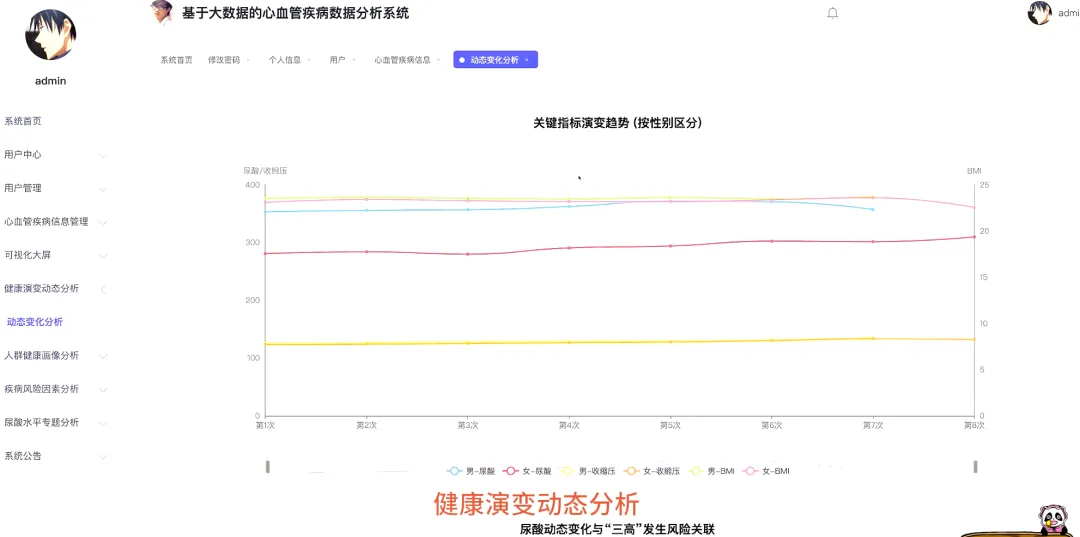
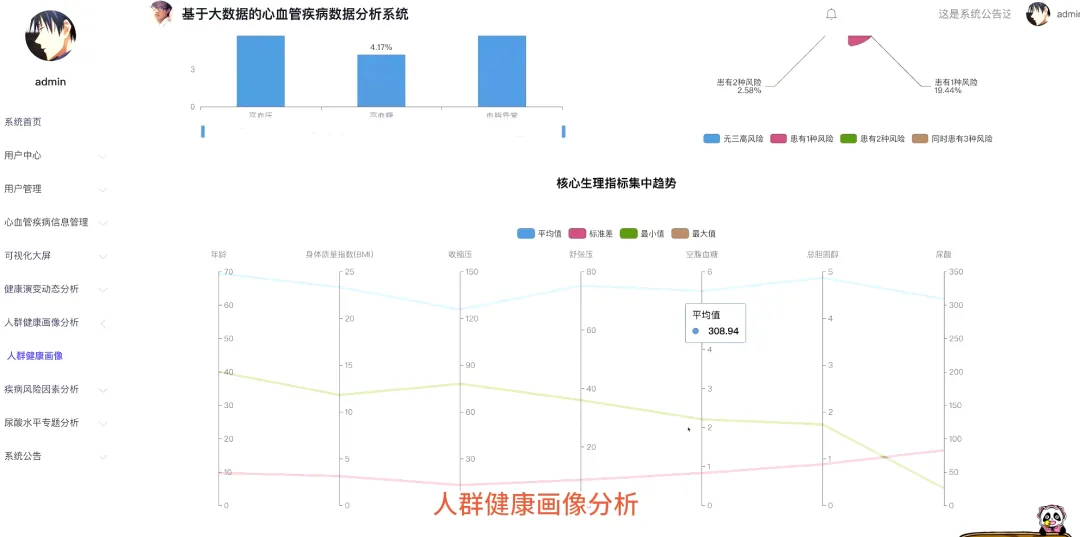
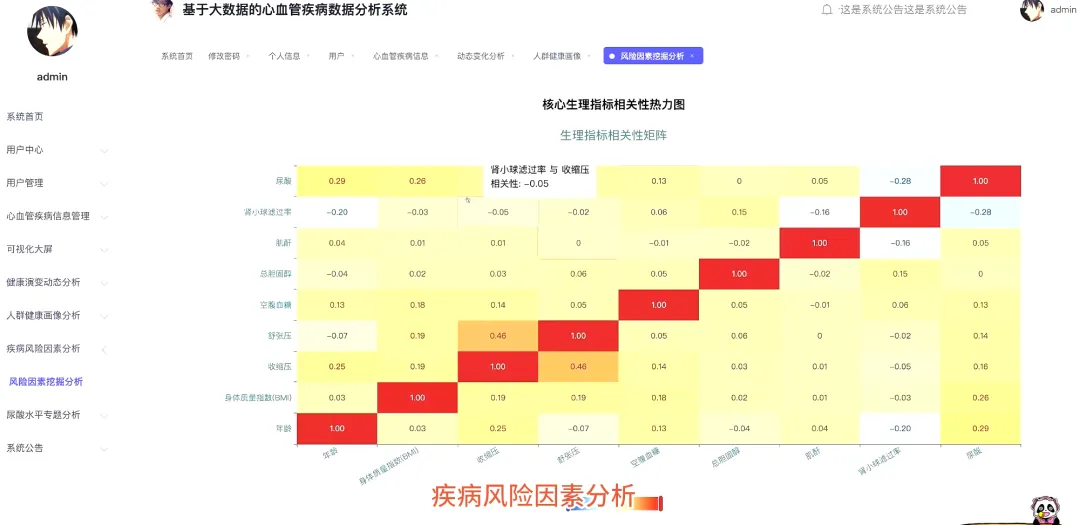
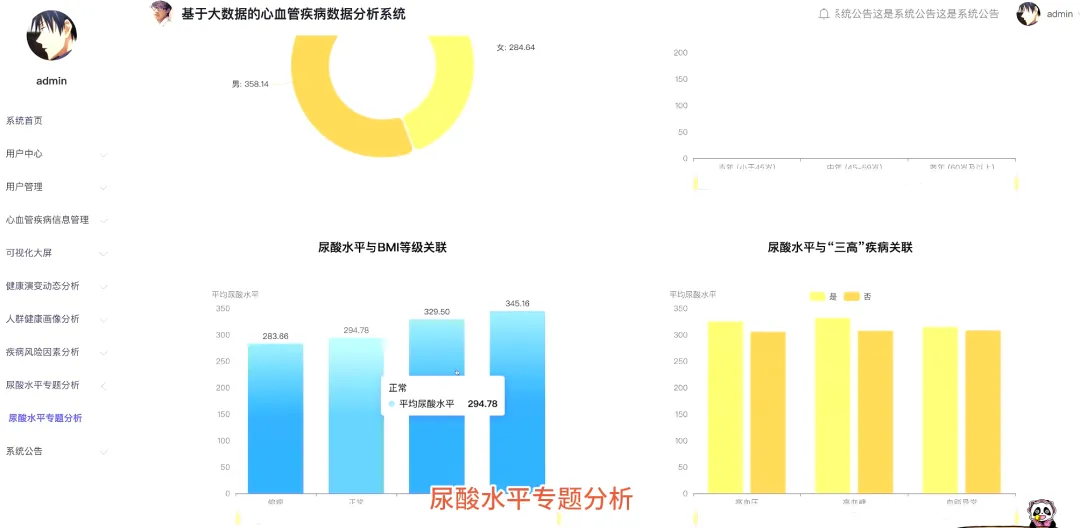
from pyspark.sql import SparkSession, functions as Ffrom pyspark.ml.feature import VectorAssemblerfrom pyspark.ml.stat import Correlationspark = SparkSession.builder.appName("CardiovascularAnalysis").getOrCreate()df = spark.read.csv("hdfs://path/to/data.csv", header=True, inferSchema=True)def calculate_three_highs_prevalence(data_frame): total_count = data_frame.count() hypertension_count = data_frame.filter(F.col('Hypertension') == 1).count() hyperglycemia_count = data_frame.filter(F.col('Hyperglycemia') == 1).count() dyslipidemia_count = data_frame.filter(F.col('Dyslipidemia') == 1).count() hypertension_rate = hypertension_count / total_count hyperglycemia_rate = hyperglycemia_count / total_count dyslipidemia_rate = dyslipidemia_count / total_count result_df = spark.createDataFrame([ ('高血压', hypertension_count, hypertension_rate), ('高血糖', hyperglycemia_count, hyperglycemia_rate), ('血脂异常', dyslipidemia_count, dyslipidemia_rate) ], ['Disease', 'Count', 'PrevalenceRate']) return result_dfdef analyze_uric_acid_by_gender(data_frame): gender_stats = data_frame.groupBy('Gender').agg( F.avg('Uric Acid').alias('AvgUricAcid'), F.stddev('Uric Acid').alias('StdDevUricAcid'), F.min('Uric Acid').alias('MinUricAcid'), F.max('Uric Acid').alias('MaxUricAcid'), F.count('Uric Acid').alias('Count') ).orderBy('Gender') return gender_statsdef calculate_correlation_matrix(data_frame): numeric_cols = ['Age', 'Body Mass Index', 'Systolic Blood Pressure', 'Diastolic Blood Pressure', 'Fasting Blood Glucose', 'Total Cholesterol', 'Uric Acid', 'Glomerular Filtration Rate'] assembler = VectorAssembler(inputCols=numeric_cols, outputCol="features") df_vector = assembler.transform(data_frame).select("features") matrix = Correlation.corr(df_vector, "features").collect()[0][0] corr_matrix = matrix.toArray().tolist() return corr_matrix
 10个月宝宝每天需要喝多少奶粉?