Python 回测不是终点:量化策略必须把绩效分析做完整
量化论文解读
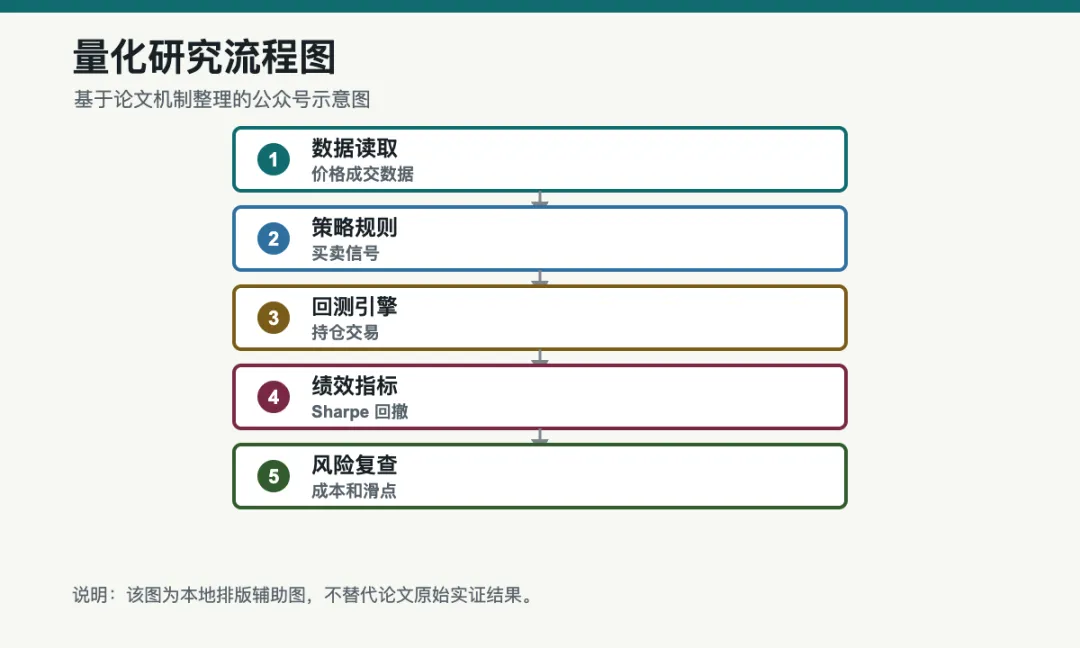 本图为基于论文机制整理的本地示意图,用于解释信号、模型、组合和风控之间的关系。
摘要
从策略规则、回测和风险指标看数据驱动交易流程。本文是量化论文解读,未运行作者代码,也不把论文结论包装成已经复现的实盘结果。重点看研究问题、方法结构、交易启示和复现边界。
正文
一、研究问题
这篇论文讨论用 Python 进行量化交易策略、回测和绩效分析。它的重点不是某个神奇模型,而是完整流程:数据处理、信号生成、仓位规则、回测执行和指标评估。
对量化研究来说,论文最有价值的地方不是模型名字,而是它能不能把信号、风险、组合和交易约束放到同一条链路里审查。只要少了时间切分、成本扣除和样本外检查,预测结果就不能直接等同于可交易收益。
二、方法结构
1. 数据读取 | 获取价格和成交数据
2. 策略规则 | 生成买卖信号
3. 回测引擎 | 模拟持仓和交易
4. 绩效指标 | 收益、Sharpe 和回撤
5. 风险复查 | 成本、滑点和稳健性
这套结构可以压缩成一个通用量化审查框架
公式
signal_t = Model(data_t, state_t)
公式
position_t = Portfolio(signal_t, risk_budget_t)
公式
pnl_{t+1} = position_t * return_{t+1} - cost_{t+1}
模型输出只是第一步,组合映射、成本约束和风险预算才决定它是否值得进入实盘候选池。
三、实验或理论设置
本文解读基于本地论文材料。严谨评估至少要看四件事:
1. 样本切分是否严格按时间顺序,避免未来信息泄漏。
2. 特征标准化、参数搜索和模型选择是否只使用训练窗口。
3. 指标是否同时覆盖预测误差、IC、分层收益、最大回撤、换手率和成本后收益。
4. 结论是否经过滚动样本外、不同市场状态和不同资产池检验。
四、关键结果或图表解读
这类论文的价值在于训练量化基本功。一个策略如果没有清晰回测框架,就无法判断收益来自信号、杠杆、样本选择还是成本忽略。
五、对量化交易和资产配置的启示
这篇论文的共同启示是:量化研究要从“预测更准”升级到“决策更稳”。一个信号如果不能改善组合权重,不能控制尾部风险,不能在成本后保留收益,就不能算完成策略验证。
对资产配置来说,关键不是单个模型多复杂,而是它能否在组合层面改善收益风险比。策略越复杂,越需要更严格的审计清单,包括数据泄漏、交易成本、换手率、仓位约束和极端行情表现。
六、公式和指标
公式
position_t = Strategy(signal_t)
公式
pnl_t = position_{t-1} * return_t - cost_t
公式
Sharpe = mean(pnl) / std(pnl)
这些公式的共同含义是:收益、风险、成本和稳定性必须同时进入评价。只优化单一预测分数,很容易得到训练集好看、实盘脆弱的策略。
七、方法优点
1. 研究问题落在波动率、DeFi、非平稳市场、日历异常、成交因子、动量、强化学习、对冲、回测或组合优化的核心环节。
2. 方法结构可以转化为可审查的研发流程。
3. 指标不只停留在模型误差,而是连接收益、风险、回撤或组合效率。
4. 对实盘团队有直接启发:先控制泄漏、成本和风险,再讨论模型复杂度。
八、明显边界
基础回测论文容易低估实盘细节。必须加入交易限制、成交冲击和样本外检验。
此外,论文报告结果不等于本地复现结果。没有重新运行代码、数据和回测脚本之前,不能把论文结论说成已经验证的交易策略。
九、是否可复现
本文仅做论文解读,未运行作者代码或独立复现实验。当前只能确认论文材料中的研究逻辑和报告结论,不能确认代码依赖、数据权限、随机种子、交易成本和全部参数设置是否足以复现。
小结
这篇论文值得量化研究者阅读,因为它把具体模型或因子问题推进到更完整的交易审查框架里。真正的量化研究不是追逐更复杂的模型名称,而是持续回答同一个问题:信号能否在样本外、扣成本、受风控约束的组合里稳定改善收益风险比。
想系统看 AI量化学习路径与更多量化技巧文章,可访问 AI量化学院。