【提要】
1.各类优化算法运行轨迹的背后原理;
2.动手从零构建对比Adam与AdamW差异的场景。
一、背景简介
1.目标函数: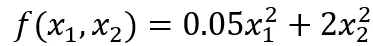
初始值:起点 (1.5, 0.8) 出发,学习率 。
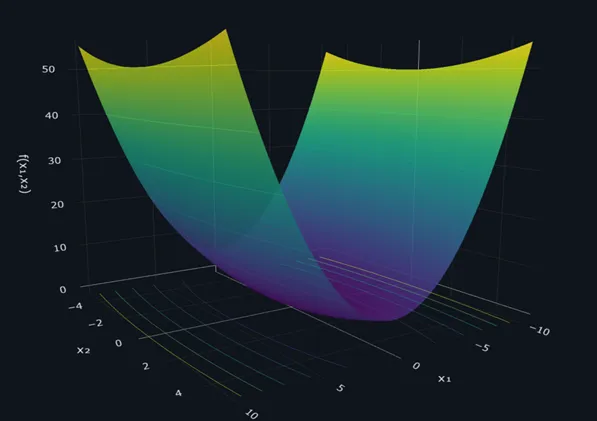
这个函数的形状很特别(如下图所示):全局最优点为(0,0),在 方向上非常平坦(像平缓的缓坡),在 方向上非常陡峭(像狭窄的陡坡)。这种“一边平一边陡”的形状,是导致不同算法表现差异的根本原因。
二、SGD算法为啥慢,甚至无法收敛?
1.SGD算法运行结果(起点:(1.5,0.8)学习率):
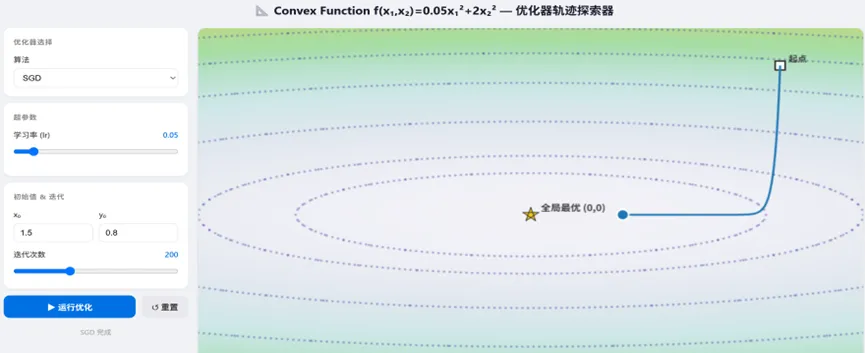
2.运行结果分析:
学习率(η)全局固定,对病态曲率(沟壑地形)敏感,会在峡谷中来回震荡,收敛慢,甚至无法收敛!
3.背后原理解析:
两个方向的更新规则推导
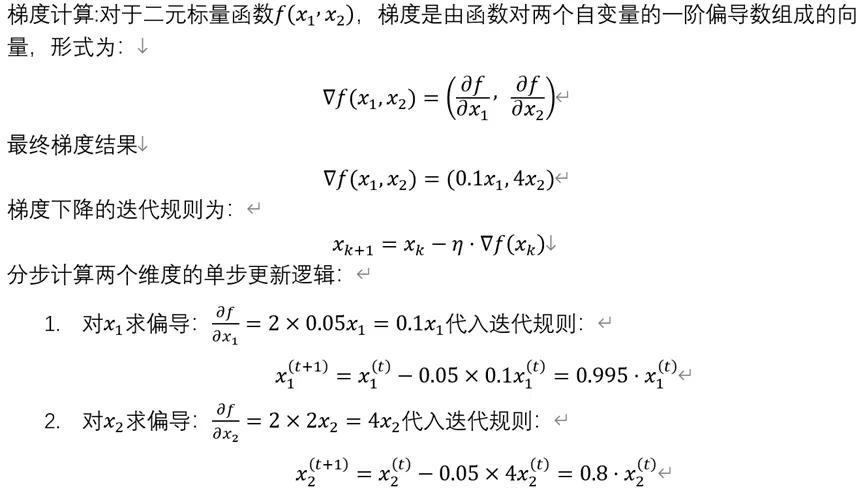
4. 为什么收敛越来越慢,甚至无法收敛?
如何改进SGD在平滑环境收敛慢的问题呢?
三、Momentum(动量法)--引入“惯性”
1.运行结果:
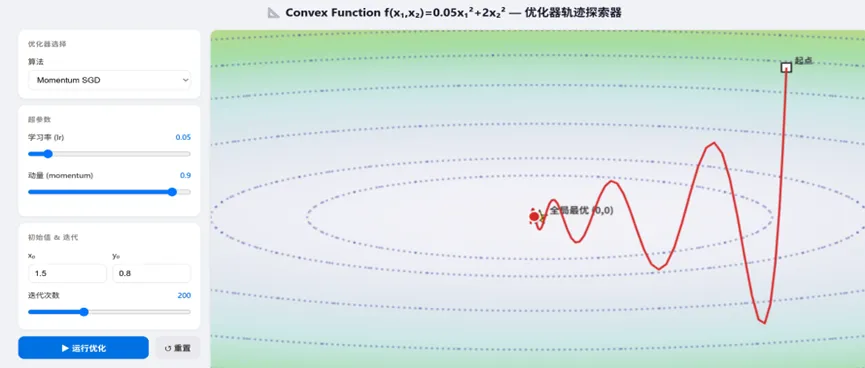
2.结果分析:
加速收敛.但震荡较大,在拐点处容易“冲过头”,缺乏减速机制。
3.算法核心思想:
- 加速收敛:在梯度方向一致的维度上叠加历史惯性,加快参数向最优值移动的速度。
- 跳出局部最优:借助累积的惯性冲量,帮助优化过程越过小的局部最优陷阱,更接近全局最优解。
4.伪代码:
v = 0
for each batch:
g = gradient(θ)
v = γ· v + η· g#累加历史梯度,更新速度方向
θ = θ– v#更新参数
如何解决动量算法容易“冲过头”,导致震荡剧烈的问题呢?
四、Nesterov 动量算法(NAG)—— 具备“前瞻”能力
1.运行结果:
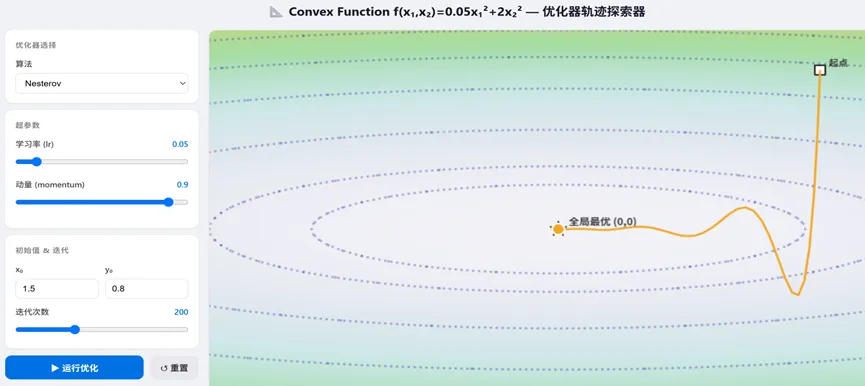
2.运行结果分析:
比标准动量更稳定,在凸优化中有理论保证,收敛更快。但轨迹还是存在震荡。
3.核心思想:
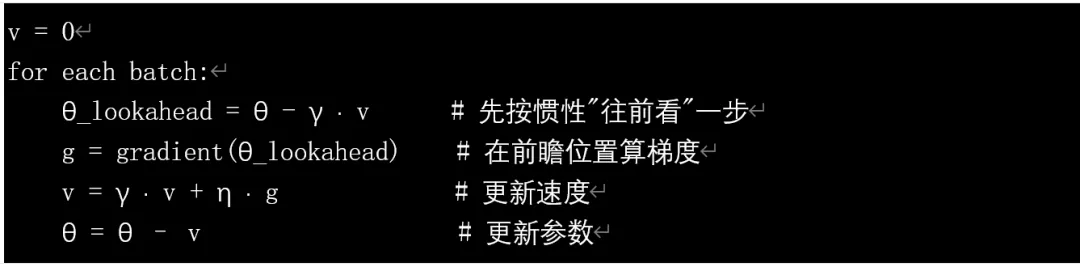
在普通动量的基础上,提前计算“向前一步”位置的梯度,让参数更新的预判性更强,既保留动量加速收敛、减少震荡的优势,又能在接近最优值时大幅降低过冲风险,收敛精度和稳定性都优于普通动量SGD。
4.伪代码:
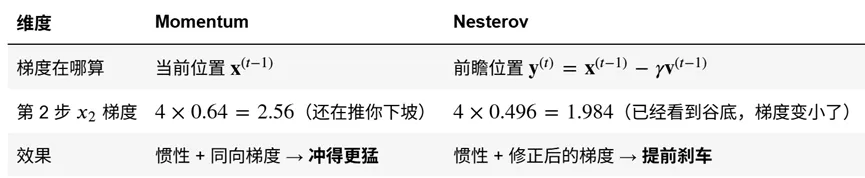
5.为什么 Nesterov 比Momentum振荡更小?
以上带动量的优化器,对不同坡度的梯度都使用同一个固定学习率,从而导致运行轨迹波动较大,如何解决这个问题?接下来我们将介绍各方向自适应学习率的几个优化器。
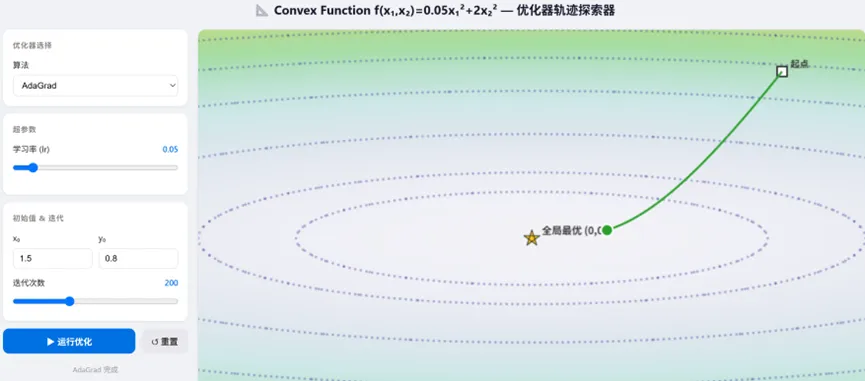
五、 AdaGrad(Adaptive Gradient)解决参数调参难、多维且各维坡度不同和稀疏特征等问题,为每个参数分配独立自适应的学习率。
1.运行结果
运行结果:
2.运行结果分析:
免调参(自适应),这是一个开创性工作,但这里训练后期提前停止(致命伤),未收敛。
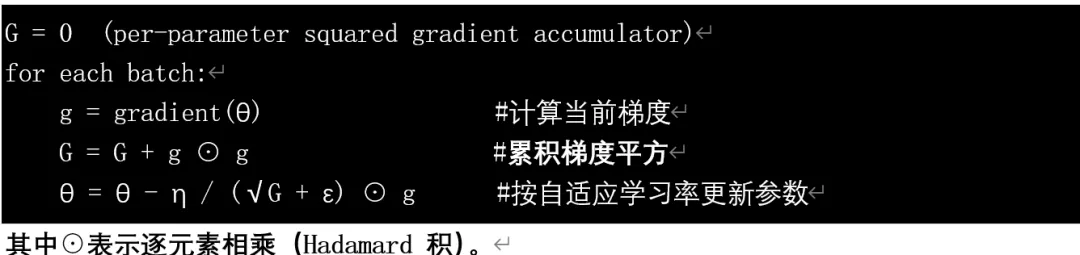
3.核心思想:
- 首个落地的自适应学习率优化算法,是自适应优化器的奠基性方案。
·每个坐标独立累积历史梯度的平方,用它对学习率"按坐标自适应缩放"——梯度大的方向(陡)被自动压小步子,梯度小的方向(平)相对走大一点。这是它与SGD/Momentum/Nesterov 最本质的区别。
·它通过累积梯度平方来实现这个"自适应"。
4.伪代码:
5. AdaGrad为何(在200步内)没有收敛?
AdaGrad 的"自适应"在初期很有效——它自动压制了 方向的大梯度,避免了像 Momentum 那样冲过头振荡;但累积梯度平方导致学习率不断衰减,到了中后期,两个方向的学习率都变得极小,优化器"跑不动了",最终卡在离最优解较远的位置。
如何解决AdaGrad后期跑不动这个问题呢?
引入了"遗忘机制"(采用指数衰减平均,而不是梯度平方的简单累积),不会让历史累积永远拖累当前的学习率。这正是RMSprop 和 Adam 采用的核心改进之一。
六、RMSProp(Root Mean Square Propagation)—— 引入指数衰减,解决学习率消亡。
1.运行结果
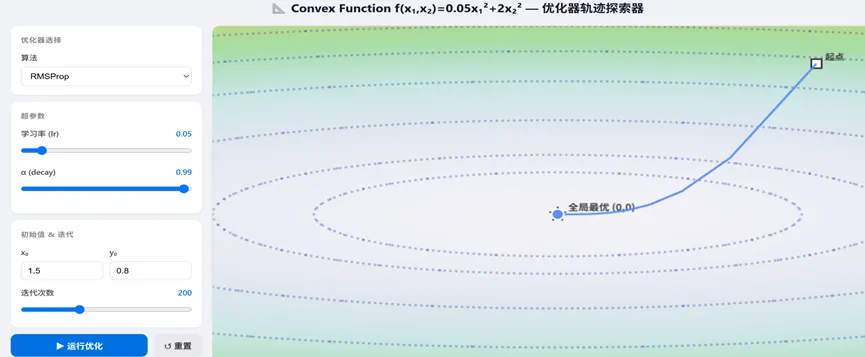
2.运行结果分析:
迭代12步就收敛了!解决了AdaGrad的消亡问题,不过,因没有引入动量,有时收敛不够快。
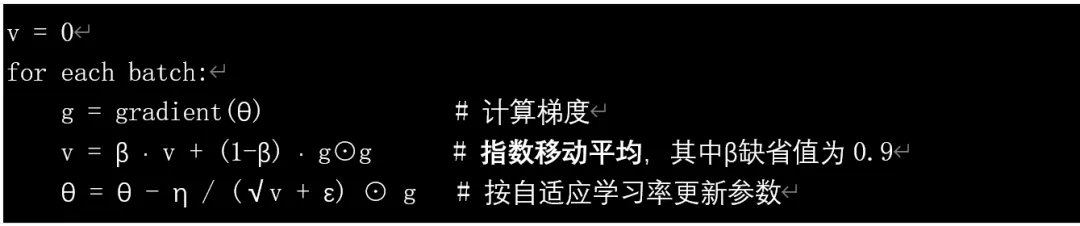
3.核心思想:用指数移动平均的滑动累积方式替代AdaGrad的全历史梯度平方累加,避免了训练后期学习率单调递减到趋近于零、训练提前停滞的问题,让自适应学习率的调整更平缓可控,是工业界早期广泛使用的实战级自适应优化器。
4.伪代码:
它把 AdaGrad 的"累加"改成"指数移动平均"——旧的梯度平方逐渐被遗忘,新的梯度平方占主导。
前面介绍的含动量的优化算法:收敛更快了,但不够稳定。
带学习率自适应的优化算法:收敛更稳定了,但收敛不够快。
如何把两者的优势有机结合起来,同时克服各自的不足?
介绍接下来介绍的集大成者(Adam 及其变体)。
七、Adam(Adaptive Moment Estimation) —— 动量 + RMSProp 的合体
1.运行结果
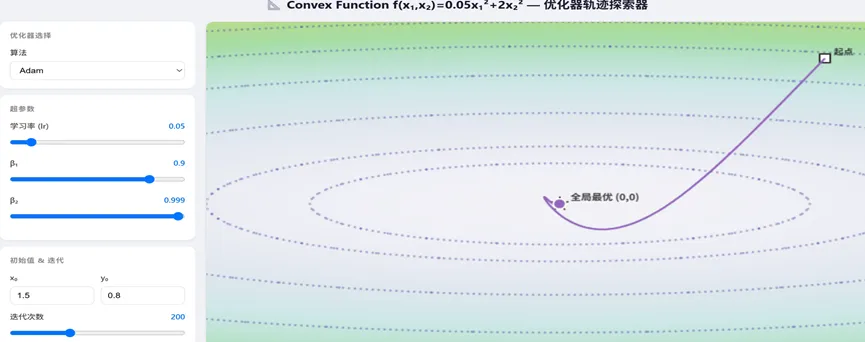
2.运行结果说明:
收敛快,运行69步收敛了!而且收敛更稳定,鲁棒性更了强,适用于大规模数据和各种非凸问题,是当前默认首选。
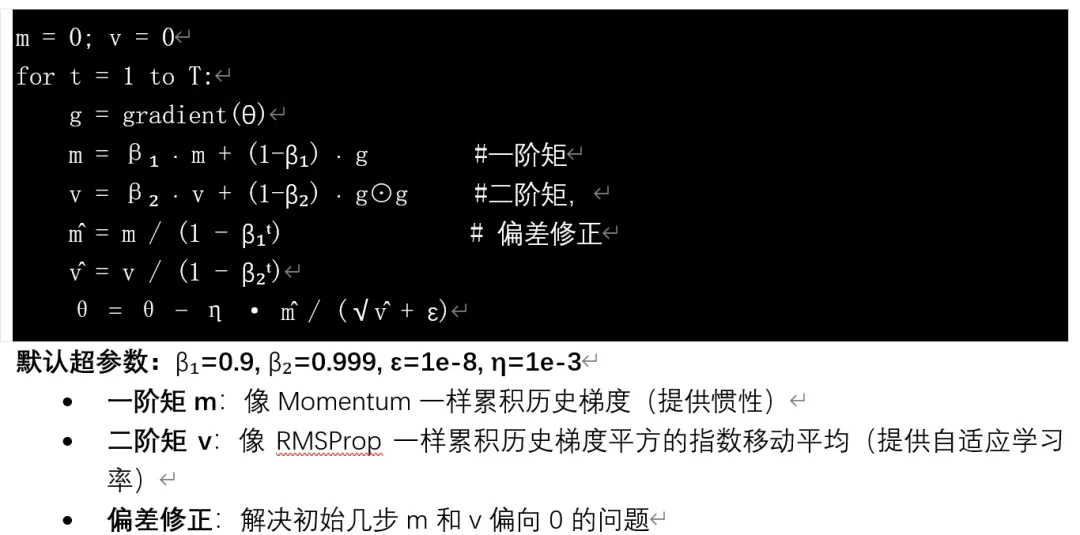
3.核心思想:Adam 可以看作是Momentum + RMSProp + 偏差修正 的三合一。
4.伪代码:
八、AdamW(Adam + Decoupled Weight Decay) —— 修复权重衰减(L2正则化)
1.运行结果
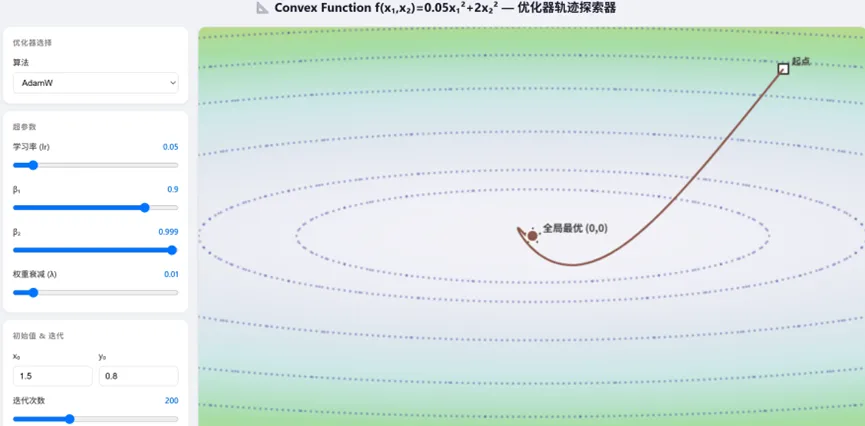
2.运行结果分析
运行轨迹与Adam几乎一致,但算法有一处改进。
3.改进的核心思想
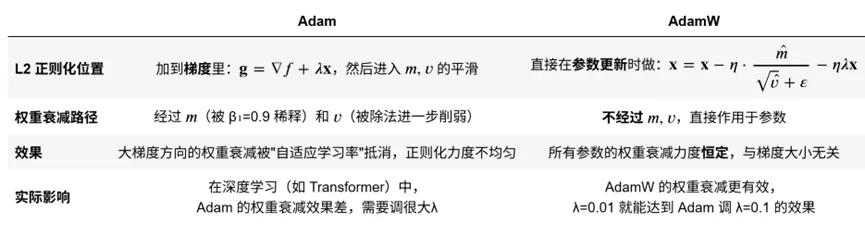
将“权重衰减”与“损失函数的梯度”解耦,直接在参数更新时减去 lr * weight_decay * θ,而不是加到梯度里。把权重衰减从梯度中解耦出来,直接对参数做衰减。
4.Adam和AdamW的主要区别
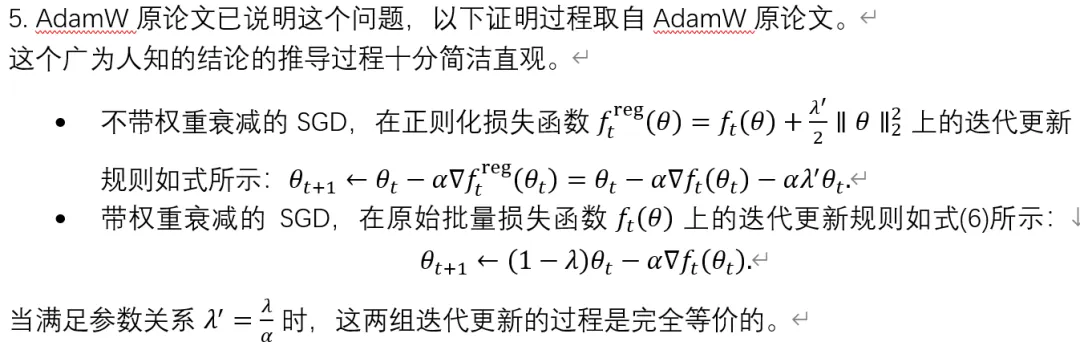
为何有很多参考文献经常提到Adam 的L2正则化耦合在梯度中,但我们却在Adam算法中没有显式看到的L2?
这就严格证明了标准训练流程中权重衰减操作和损失函数中添加L₂正则项的效果完全一致,仅需要按学习率比例调整正则项系数即可完成等价转换。
6.AdamW通过这一改进,显著提高了泛化能力,成为Transformer(如BERT、GPT)的标准配置。
如何通过实例来复现两种算法的差异呢?
九、动手从零构建对比Adam与AdamW差异的场景
1.实验设置
配置项 | 值 |
模型架构 | GPT-2 风格 Decoder-only Transformer |
层数 / 维度 / 头数 | 12 / 512 / 8(类似 GPT-2 结构,规模适配 CPU) |
参数量 | ~38M |
Tokenization | 字符级(输入文本共 23 个唯一字符) |
输入/输出 | "I am interested in deep learning, please recommend some reference materials for me, thank you!" |
训练步数 | 30 次迭代 |
学习率 | 1e-4 |
Weight Decay | 0.01 |
优化器 | torch.optim.Adam vs torch.optim.AdamW |
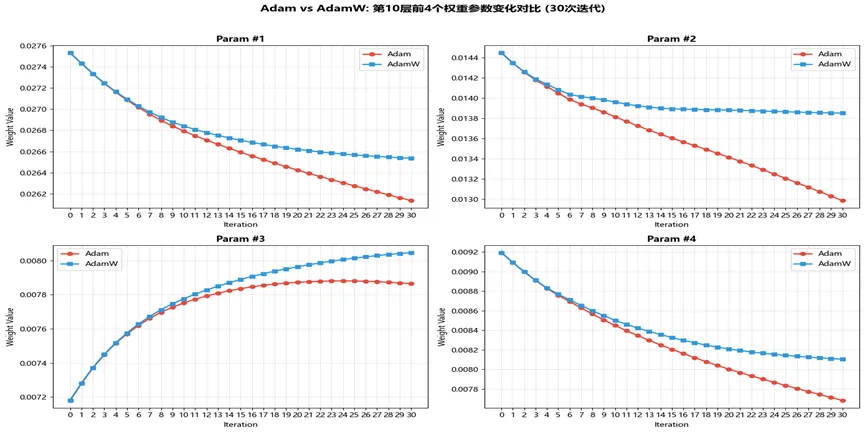
记录目标 | 第 10 层 (h.9) 的 attn.c_attn.weight 前 4 个参数 |
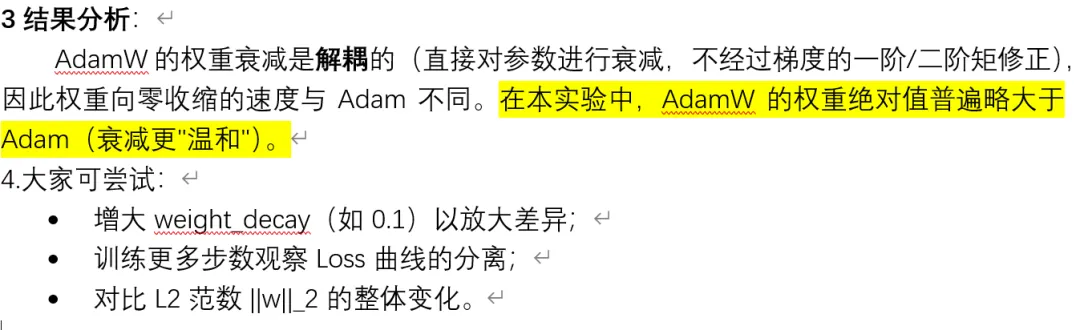
2.运行结果
十、小结与展望
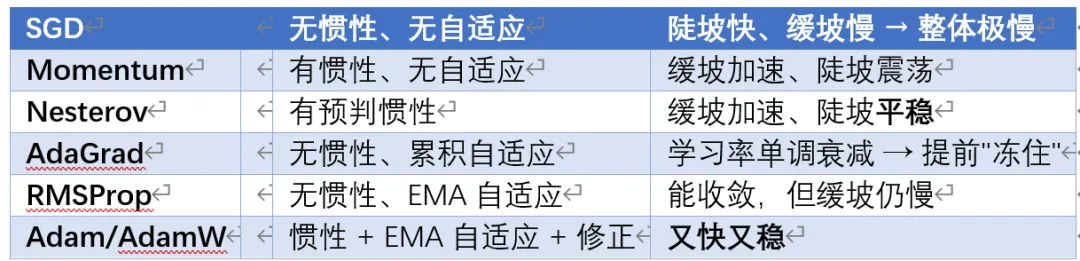
1.各算法小结
2.优化算法展望
除 AdamW 之外,当前深度学习领域(尤其是大语言模型预训练)最受关注、最具前沿性的优化算法主要集中在以下几个方向:矩阵感知/谱优化(Muon 家族)、符号动量(Lion)、轻量级二阶方法(Sophia)、无调度优化(Schedule-Free)以及结构化预条件(SOAP 等)。
其中Muon 的正交化更新仅适用于2D 权重矩阵(如 Linear、Conv2d 层)。对于Embedding、LayerNorm/RMSNorm、bias 等非 2D 参数,仍需搭配其他优化器(通常为 AdamW 或 SGD-Momentum)进行混合优化。这种混合策略是 Muon 的标准用法,已在 Kimi K2 、GLM-5、DeepSeek-V4等大规模训练中验证有效。
视频连接:
抖音账号:84911487035
B 站主页:https://space.bilibili.com/391424656
获取电子文档及PyTorch、html等代码:
微信公众号:大模型大智慧
附录:动手从零构建对比Adam与AdamW差异的场景的具体代码
<!-- /* Font Definitions */ @font-face {font-family:宋体; panose-1:2 1 6 0 3 1 1 1 1 1; mso-font-alt:SimSun; mso-font-charset:134; mso-generic-font-family:auto; mso-font-pitch:variable; mso-font-signature:515 680460288 22 0 262145 0;}@font-face {font-family:"Cambria Math"; panose-1:2 4 5 3 5 4 6 3 2 4; mso-font-charset:0; mso-generic-font-family:roman; mso-font-pitch:variable; mso-font-signature:-536869121 1107305727 33554432 0 415 0;}@font-face {font-family:等线; panose-1:2 1 6 0 3 1 1 1 1 1; mso-font-alt:DengXian; mso-font-charset:134; mso-generic-font-family:auto; mso-font-pitch:variable; mso-font-signature:-1610612033 953122042 22 0 262159 0;}@font-face {font-family:"\@等线"; panose-1:2 1 6 0 3 1 1 1 1 1; mso-font-charset:134; mso-generic-font-family:auto; mso-font-pitch:variable; mso-font-signature:-1610612033 953122042 22 0 262159 0;}@font-face {font-family:"\@宋体"; panose-1:2 1 6 0 3 1 1 1 1 1; mso-font-charset:134; mso-generic-font-family:auto; mso-font-pitch:variable; mso-font-signature:515 680460288 22 0 262145 0;} /* Style Definitions */ p.MsoNormal, li.MsoNormal, div.MsoNormal {mso-style-unhide:no; mso-style-qformat:yes; mso-style-parent:""; margin:0cm; text-align:justify; text-justify:inter-ideograph; mso-pagination:none; font-size:10.5pt; mso-bidi-font-size:11.0pt; font-family:等线; mso-ascii-font-family:等线; mso-ascii-theme-font:minor-latin; mso-fareast-font-family:等线; mso-fareast-theme-font:minor-fareast; mso-hansi-font-family:等线; mso-hansi-theme-font:minor-latin; mso-bidi-font-family:"Times New Roman"; mso-bidi-theme-font:minor-bidi; mso-font-kerning:1.0pt; mso-ligatures:standardcontextual;}.MsoChpDefault {mso-style-type:export-only; mso-default-props:yes; font-size:10.5pt; mso-ansi-font-size:10.5pt; mso-bidi-font-size:11.0pt; font-family:等线; mso-bidi-font-family:"Times New Roman"; mso-bidi-theme-font:minor-bidi;} /* Page Definitions */ @page {mso-page-border-surround-header:no; mso-page-border-surround-footer:no;}@page WordSection1 {size:612.0pt 792.0pt; margin:72.0pt 90.0pt 72.0pt 90.0pt; mso-header-margin:36.0pt; mso-footer-margin:36.0pt; mso-paper-source:0;}div.WordSection1 {page:WordSection1;}-->import torchimport torch.nn as nnimporttorch.nn.functional as Fimport matplotlib.pyplotas pltimport numpy as np# 使plt支持中文和负号plt.rcParams['font.family']= 'Microsoft YaHei'plt.rcParams['axes.unicode_minus']= Falseprint(f"PyTorchversion: {torch.__version__}")# ==================== 1.配置 ====================class GPT2Config: def __init__(self): self.vocab_size = 256 self.n_positions = 512 self.n_embd = 512 self.n_layer = 12 self.n_head = 8 self.n_inner = 2048 self.dropout = 0.0 self.layer_norm_epsilon = 1e-5config = GPT2Config()# ==================== 2.模型构建 ====================class Conv1D(nn.Module): def __init__(self, nf, nx): super().__init__() self.nf = nf self.weight =nn.Parameter(torch.empty(nx, nf)) self.bias =nn.Parameter(torch.zeros(nf)) nn.init.normal_(self.weight, std=0.02) def forward(self, x): size_out = x.size()[:-1] + (self.nf,) x = torch.addmm(self.bias, x.view(-1,x.size(-1)), self.weight) return x.view(size_out)classGPT2Attention(nn.Module): def __init__(self, config): super().__init__() self.n_head = config.n_head self.n_embd = config.n_embd self.head_dim = self.n_embd //self.n_head self.c_attn = Conv1D(3 * config.n_embd,config.n_embd) self.c_proj = Conv1D(config.n_embd,config.n_embd) def forward(self, x): bsz, seq_len, _ = x.size() qkv = self.c_attn(x) q, k, v = qkv.split(self.n_embd, dim=2) q = q.view(bsz, seq_len, self.n_head,self.head_dim).transpose(1, 2) k = k.view(bsz, seq_len, self.n_head,self.head_dim).transpose(1, 2) v = v.view(bsz, seq_len, self.n_head,self.head_dim).transpose(1, 2) attn = torch.matmul(q, k.transpose(-1,-2)) / (self.head_dim ** 0.5) mask = torch.triu(torch.ones(seq_len,seq_len, device=x.device), diagonal=1).bool() attn = attn.masked_fill(mask,float('-inf')) attn = F.softmax(attn, dim=-1) out = torch.matmul(attn, v) out = out.transpose(1,2).contiguous().view(bsz, seq_len, self.n_embd) return self.c_proj(out)class GPT2MLP(nn.Module): def __init__(self, config): super().__init__() self.c_fc = Conv1D(config.n_inner,config.n_embd) self.c_proj = Conv1D(config.n_embd,config.n_inner) def forward(self, x): returnself.c_proj(F.gelu(self.c_fc(x)))classGPT2Block(nn.Module): def __init__(self, config): super().__init__() self.ln_1 = nn.LayerNorm(config.n_embd,eps=config.layer_norm_epsilon) self.attn = GPT2Attention(config) self.ln_2 = nn.LayerNorm(config.n_embd,eps=config.layer_norm_epsilon) self.mlp = GPT2MLP(config) def forward(self, x): x = x + self.attn(self.ln_1(x)) x = x + self.mlp(self.ln_2(x)) return xclassGPT2Model(nn.Module): def __init__(self, config): super().__init__() self.wte =nn.Embedding(config.vocab_size, config.n_embd) self.wpe =nn.Embedding(config.n_positions, config.n_embd) self.drop = nn.Dropout(config.dropout) self.h =nn.ModuleList([GPT2Block(config) for _ in range(config.n_layer)]) self.ln_f = nn.LayerNorm(config.n_embd,eps=config.layer_norm_epsilon) self.lm_head = nn.Linear(config.n_embd,config.vocab_size, bias=False) self.lm_head.weight =self.wte.weight # 权重绑定 def forward(self, input_ids): bsz, seq_len = input_ids.size() pos = torch.arange(0, seq_len,dtype=torch.long, device=input_ids.device).unsqueeze(0) hidden = self.wte(input_ids) +self.wpe(pos) hidden = self.drop(hidden) for block in self.h: hidden = block(hidden) hidden = self.ln_f(hidden) return self.lm_head(hidden)# ==================== 3.数据准备 ====================text = "I aminterested in deep learning, please recommend some reference materials for me,thank you!"chars =sorted(list(set(text)))char_to_id = {ch: i fori, ch in enumerate(chars)}input_ids =torch.tensor([char_to_id[ch] for ch in text], dtype=torch.long)target_ids =input_ids.clone()print(f"文本: {text}")print(f"文本长度: {len(text)}, 词汇表大小: {len(chars)}")# ==================== 4.训练对比 ====================seed = 42torch.manual_seed(seed)# 确保两个模型初始权重完全一致model_ref =GPT2Model(config)initial_state = model_ref.state_dict()model_adam =GPT2Model(config)model_adam.load_state_dict(initial_state)model_adamw =GPT2Model(config)model_adamw.load_state_dict(initial_state)# 优化器lr = 1e-4weight_decay = 0.01optimizer_adam =torch.optim.Adam(model_adam.parameters(), lr=lr, weight_decay=weight_decay)optimizer_adamw =torch.optim.AdamW(model_adamw.parameters(), lr=lr, weight_decay=weight_decay)criterion =nn.CrossEntropyLoss()num_iterations = 30# 记录第10层 (index=9) 的 c_attn.weight 前4个值layer_idx = 9# 【关键修复 #1】初始值使用 .clone() 确保独立adam_weights = [model_adam.h[layer_idx].attn.c_attn.weight.flatten()[:4].detach().clone().cpu().numpy()]adamw_weights = [model_adamw.h[layer_idx].attn.c_attn.weight.flatten()[:4].detach().clone().cpu().numpy()]adam_losses, adamw_losses= [], []for iteration in range(1,num_iterations + 1): # --- Adam --- model_adam.train() optimizer_adam.zero_grad() logits = model_adam(input_ids.unsqueeze(0)) loss = criterion( logits[:, :-1, :].contiguous().view(-1,config.vocab_size), target_ids[1:].contiguous().view(-1) ) loss.backward() optimizer_adam.step() adam_losses.append(loss.item()) # 【关键修复 #2】.cpu().numpy().copy()创建独立副本,避免共享内存 w_adam =model_adam.h[layer_idx].attn.c_attn.weight.flatten()[:4].detach().cpu().numpy().copy() adam_weights.append(w_adam) # --- AdamW --- model_adamw.train() optimizer_adamw.zero_grad() logits =model_adamw(input_ids.unsqueeze(0)) loss = criterion( logits[:, :-1, :].contiguous().view(-1,config.vocab_size), target_ids[1:].contiguous().view(-1) ) loss.backward() optimizer_adamw.step() adamw_losses.append(loss.item()) # 【关键修复 #3】同上 w_adamw =model_adamw.h[layer_idx].attn.c_attn.weight.flatten()[:4].detach().cpu().numpy().copy() adamw_weights.append(w_adamw) print(f"Iter {iteration:2d} | AdamLoss: {adam_losses[-1]:.6f} | AdamW Loss: {adamw_losses[-1]:.6f}")# ==================== 5.数值结果 ====================print("\n" +"=" * 70)print("第10层 (h.9.attn.c_attn.weight)前4个权重参数的变化结果")print("=" * 70)print(f"\n初始值 (Iteration 0):")print(f" Adam : {adam_weights[0].tolist()}")print(f" AdamW: {adamw_weights[0].tolist()}")print(f"\n第10次迭代后 (Iteration 10):")print(f" Adam : {adam_weights[10].tolist()}")print(f" AdamW: {adamw_weights[10].tolist()}")print(f"\n变化量 (Iteration 10 -Iteration 0):")adam_delta =adam_weights[10] - adam_weights[0]adamw_delta =adamw_weights[10] - adamw_weights[0]print(f" Adam : {adam_delta.tolist()}")print(f" AdamW: {adamw_delta.tolist()}")print(f"\n变化量差异 (AdamW_delta -Adam_delta):")print(f" {(adamw_delta - adam_delta).tolist()}")# ==================== 6.可视化 ====================adam_weights_arr =np.array(adam_weights)adamw_weights_arr =np.array(adamw_weights)iterations =np.arange(31)fig, axes =plt.subplots(2, 2, figsize=(14, 10))fig.suptitle('Adam vsAdamW: 第10层前4个权重参数变化对比 (30次迭代)', fontsize=14,fontweight='bold')for idx, ax inenumerate(axes.flat): ax.plot(iterations, adam_weights_arr[:,idx], 'o-', color='#e74c3c', label='Adam', linewidth=2, markersize=6) ax.plot(iterations, adamw_weights_arr[:,idx], 's-', color='#3498db', label='AdamW', linewidth=2, markersize=6) ax.set_title(f'Param #{idx+1}',fontsize=12, fontweight='bold') ax.set_xlabel('Iteration', fontsize=10) ax.set_ylabel('Weight Value', fontsize=10) ax.legend(loc='best') ax.grid(True, alpha=0.3) ax.set_xticks(iterations)plt.tight_layout(rect=[0,0, 1, 0.96])plt.savefig('adam_vs_adamw_weights.png',dpi=150, bbox_inches='tight')plt.show()
 10个月宝宝每天需要喝多少奶粉?