UXMT | 从代码到显存:一行Python命令,在DeepSeek的GPU里经历了什么?
- 2026-09-02 16:04:06
UXMT | 从代码到显存:一行Python命令,在DeepSeek的GPU里经历了什么?体验咨询 | 技术服务 | 品牌宣传 用户研究 | 产品测评 | 舆情监测 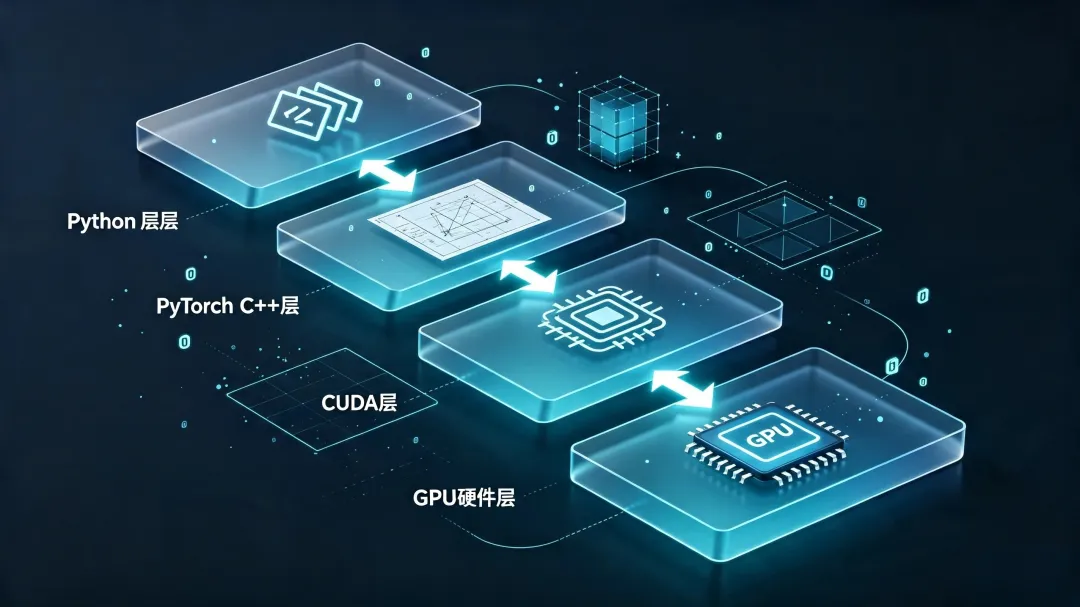
Python→C++→CUDA→GPU完整调用链路首次深度拆解
你有没有想过:
当你在DeepSeek对话框里按下回车,那一行Python代码 ——output = model.generate(input_ids) ——到底是怎么变成显卡里那一串串0和1的?
Python是解释型语言,慢得要命; GPU是并行计算怪兽,快得飞起。 中间隔着一道天堑。
今天,我们就拆开这道天堑,看看一行Python命令从键盘到显存的完整“西天取经”之路。
一、Python层:那个“发号施令”的接线员
你写的所有代码,第一站都是Python解释器。
```
output = model.generate(input_ids)
```
这行代码看起来简单,但Python根本不负责计算。 它只做一件事:传话。
Python解释器读到这行,把input_ids(一串数字)打包好,喊了一声: “PyTorch,帮我把这个矩阵乘一下!”
此时,Python就像一个接线员 ——接到客户电话(你的指令),转给后台工程师(PyTorch的C++内核),自己并不动手修电脑。
在DeepSeek的工程实践中,为了提高这层的通信效率。 团队用Cython替代了传统的ctypes来做Python与C++的交互,性能提升了约100倍,CPU开销大幅降低。
一句话: Python是“指挥官”,只动嘴,不动手。
二、C++/PyTorch层:那个“编织图纸”的总工程师
Python把任务丢给PyTorch后,真正的“体力活”从这里开始。
PyTorch的核心是一个叫ATen(A Tensor Library) 的C++库。 实现了约2000种张量操作(加法、矩阵乘、卷积、Softmax……)。 每种都有CPU和CUDA两个后端。
当你的Python代码调用torch.matmul时,实际上触发了一套极其复杂的C++调度机制:
第一步:类型转换
Python传入的整数、浮点数、列表,会被转换成C++能懂的数据结构。 这一步由自动生成的“THP”方法完成 ——把Python对象“翻译”成C++对象。
第二步:分发器(Dispatcher)路由
PyTorch有一个中央分发器,根据三个因素决定把任务送到哪里:
· 硬件:CPU还是CUDA?
· 数据类型:float还是int?
· 张量布局:连续内存还是稀疏?
第三步:打包/解包(Boxing/Unboxing)
为了通过统一的分发器接口 C++参数被装进一个叫IValue的“通用集装箱”(打包) 到达目的地后再还原成具体的C++类型(解包)。
第四步:自动微分检查
如果是训练模式,系统还会检查输入张量是否需要计算梯度。 如果需要,就创建一个反向梯度节点 ——这是训练时“反向传播”的预埋钩子。
DeepSeek的推理系统采用分层架构: 硬件抽象层通过统一的CUDA/ROCm接口兼容NVIDIA与AMD GPU; 计算内核层实现动态张量并行,在注意力层采用列并行、在FFN层切换为行并行,单卡内存占用降低40%,同时保持98%以上的计算效率。
一句话: C++层是“总工程师”,把Python的指令编织成一张精密的“施工图纸”。
三、CUDA层:那个“翻译官”和“包工头”
图纸画好了,但GPU听不懂C++ ——它只听得懂自己的语言。
CUDA就是那个翻译官: 把C++编译好的计算图,翻译成GPU能执行的PTX(并行线程执行汇编)或二进制机器码(SASS)。
CUDA干的三件核心事:
第一,分配地盘。 告诉显卡: “在显存(HBM)的0x7fff地址给你划出1GB空间,用来放KV Cache。”
第二,切分任务。 把C++传来的大矩阵乘法任务,切成几百万个小块。 因为GPU有几千个核心,必须把任务拆得足够碎,每个核心才有活干。
第三,加载内核。 把DeepSeek团队手写的CUDA内核(Kernel)加载到GPU上。 这些内核就是那5%的代码,决定了95%的性能。
DeepSeek在这层做了大量极致优化。 以FlashMLA为例 ——这是DeepSeek开源的高效注意力内核库,支撑着DeepSeek-V3和V3.2-Exp模型:
· 密集MLA解码内核在H800 SXM5上达到3000 GB/s的内存带宽和660 TFLOPS的计算性能
· 稀疏MLA解码内核(使用FP8 KV Cache,矩阵乘法用bfloat16)达到410 TFLOPS
· MLA预填充稀疏内核达到640 TFLOPS
在Hopper架构上,大部分计算内核使用wgmma.mma_async指令——将4个warp(128个线程)组织成一个warpgroup进行集体矩阵乘加运算,实现最优性能。
DeepSeek还实现了Token级别的稀疏注意力,在几乎不影响模型输出效果的前提下,大幅提升了长文本训练和推理效率。
一句话: CUDA层是“翻译官+包工头”, 把C++的图纸翻译成GPU能懂的指令,再把任务切成碎片分发给几千个核心。
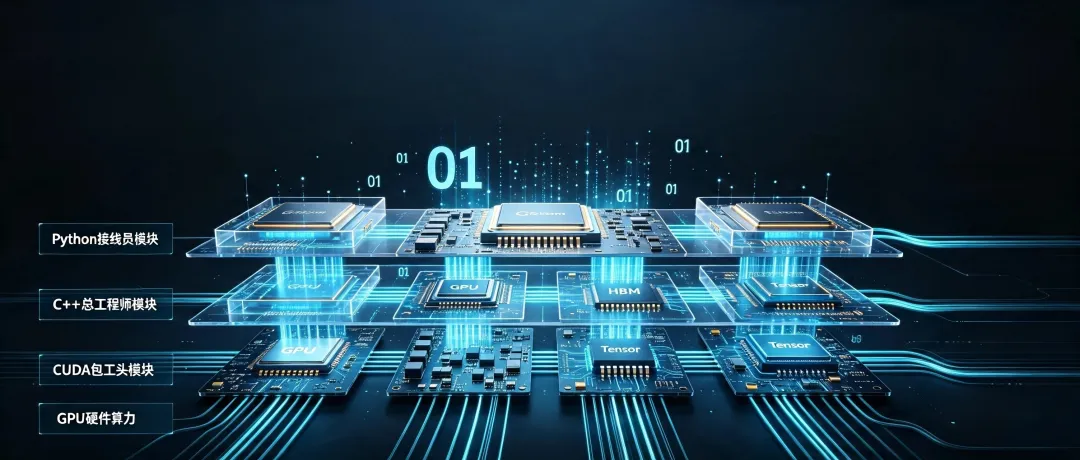
最后,显卡里的Tensor Core(张量核心)开始干活了。
显存(HBM):数据的“仓库”
671B参数、KV Cache、你的输入和输出——所有数据都存放在显卡的HBM(高带宽显存)里。 H800的单卡显存是80GB,但671B参数需要约1.3TB ——所以必须用多卡分布式部署,每张卡只存一部分参数。
SRAM:计算的“工作台”
数据从HBM被搬运到计算核心内部的SRAM(高速缓存)里,算完结果再搬回去。
手写CUDA的精髓,就是控制这个“搬运”的节奏 ——让计算核心永远不停下来等数据。 FlashMLA通过共享内存Swizzling等优化技术,把L2缓存的利用率压榨到极限。
Tensor Core:真正的“肌肉”
NVIDIA GPU里的Tensor Core是专门为矩阵乘法设计的硬件单元。 一次wgmma.mma_async指令,就能在一个时钟周期内完成一组小矩阵的乘法累加 ——这就是大模型“快”的物理基础。
DeepSeek-V3.2引入的DSA(DeepSeek Sparse Attention)首次实现了细粒度稀疏注意力,在几乎不影响模型输出效果的前提下,大幅提升了长文本训练和推理效率。
一句话: GPU是“体力劳动者”,在Tensor Core里疯狂做矩阵乘法,在HBM和SRAM之间疯狂搬运数据。
五、完整调用链路全景图
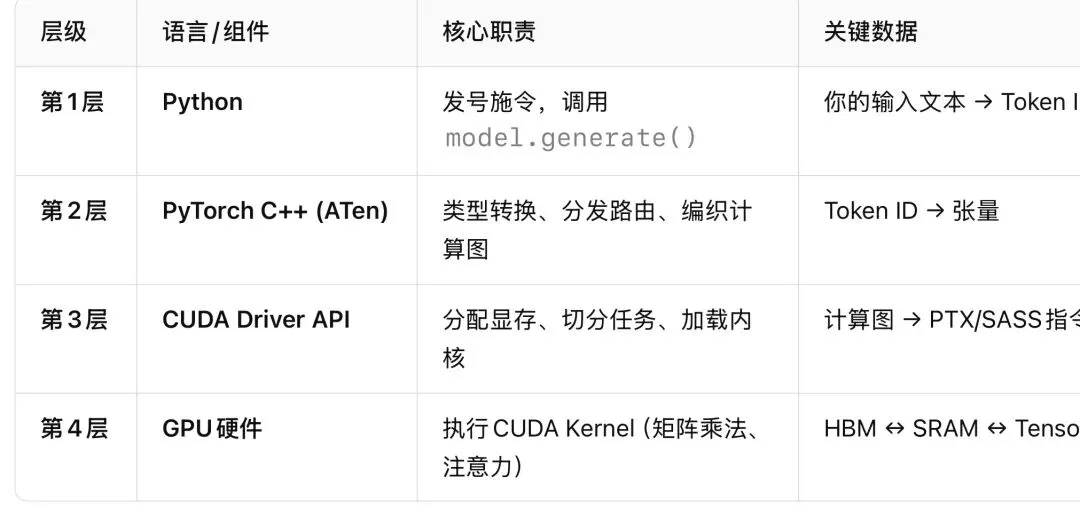
第1层 Python 发号施令,调用model.generate() ,你的输入文本 → Token ID。
第2层 PyTorch C++ (ATen) ,类型转换、分发路由、编织计算图,Token ID → 张量。
第3层 CUDA Driver API ,分配显存、切分任务、加载内核 ,计算图 → PTX/SASS指令。
第4层 GPU硬件,执行CUDA Kernel(矩阵乘法、注意力), HBM ↔ SRAM ↔ Tensor Core。
六、DeepSeek在每一层的“独门绝技”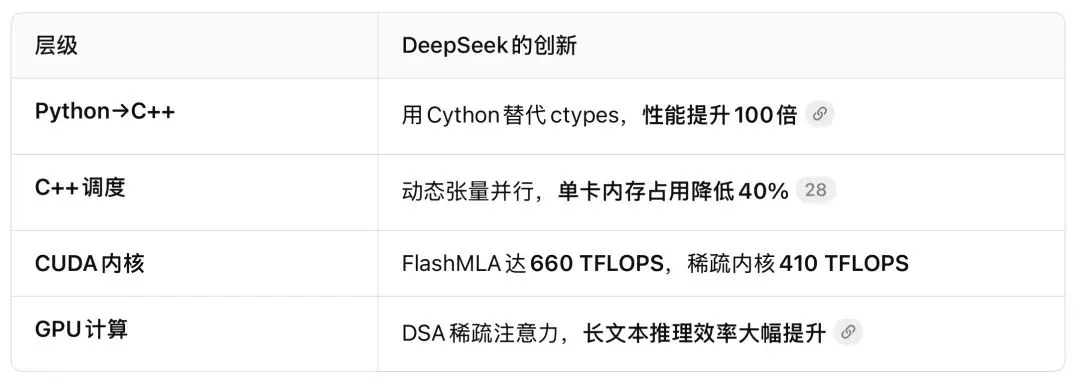
💎 写在最后
一行model.generate(input_ids),在Python层被“传话”,在C++层被“画图”,在CUDA层被“翻译+切碎”,最后在GPU的Tensor Core里被“疯狂计算”。
每一层都在做减法:Python把复杂度藏起来,C++把灵活性编成图,CUDA把图切成碎片,GPU把碎片算成结果。
而你感受到的,只是屏幕上那个一个字一个字往外蹦的答案。
671B参数、1M上下文、毫秒级响应 ——这背后,是四个层级、三种语言、数千张显卡、几千万行代码的精密协作。
下一次你按下回车的时候,可以想想: 你的一行Python,正在几千个GPU核心上掀起一场矩阵乘法的风暴。
---
觉得有用?点个「星标」让更多人看懂大模型背后的“代码长征”吧~ ▼ 往期精彩回顾 ▼ 体验经济如何改变我们的生活? 做私域,必知的4个「用户调研」方法! 《体验治要》目录解析! SAVE ELECTRICITY 
凌氡研究院 
Python→C++→CUDA→GPU
你有没有想过:
当你在DeepSeek对话框里按下回车,那一行Python代码
Python是解释型语言,慢得要命;
今天,我们就拆开这道天堑,看看一行Python命令从键盘到显存的完整“西天取经”之路。
一、Python层:那个“发号施令”的接线员
你写的所有代码,第一站都是Python解释器。
```
output = model.generate(input_ids)
```
这行代码看起来简单,但Python根本不负责计算。
Python解释器读到这行,把input_ids(一串数字)打包好,喊了一声:
此时,Python就像一个接线员
在DeepSeek的工程实践中,为了提高这层的通信效率。
一句话:
Python把任务丢给PyTorch后,真正的“体力活”从这里开始。
PyTorch的核心是一个叫ATen(A Tensor Library) 的C++库。
当你的Python代码调用torch.matmul时,实际上触发了一套极其复杂的C++调度机制:
第一步:类型转换
Python传入的整数、浮点数、列表,会被转换成C++能懂的数据结构。
第二步:分发器(Dispatcher)路由
PyTorch有一个中央分发器,根据三个因素决定把任务送到哪里:
· 硬件:CPU还是CUDA?
· 数据类型:float还是int?
· 张量布局:连续内存还是稀疏?
第三步:打包/解包(Boxing/Unboxing)
为了通过统一的分发器接口
第四步:自动微分检查
如果是训练模式,系统还会检查输入张量是否需要计算梯度。
DeepSeek的推理系统采用分层架构:
一句话:
三、CUDA层:那个“翻译官”和“包工头”
图纸画好了,但GPU听不懂C++
CUDA就是那个翻译官:
CUDA干的三件核心事:
第一,分配地盘。
第二,切分任务。
第三,加载内核。
DeepSeek在这层做了大量极致优化。
· 密集MLA解码内核在H800 SXM5上达到3000 GB/s的内存带宽和660 TFLOPS的计算性能
· 稀疏MLA解码内核(使用FP8 KV Cache,矩阵乘法用bfloat16)达到410 TFLOPS
· MLA预填充稀疏内核达到640 TFLOPS
在Hopper架构上,大部分计算内核使用wgmma.mma_async指令
DeepSeek还实现了Token级别的稀疏注意力,在几乎不影响模型输出效果的前提下,大幅提升了长文本训练和推理效率。
一句话:
最后,显卡里的Tensor Core(张量核心)开始干活了。
显存(HBM):数据的“仓库”
671B参数、KV Cache、你的输入和输出
SRAM:计算的“工作台”
数据从HBM被搬运到计算核心内部的SRAM(高速缓存)里,算完结果再搬回去。
手写CUDA的精髓,就是控制这个“搬运”的节奏
Tensor Core:真正的“肌肉”
NVIDIA GPU里的Tensor Core是专门为矩阵乘法设计的硬件单元。
DeepSeek-V3.2引入的DSA(DeepSeek Sparse Attention)首次实现了细粒度稀疏注意力,在几乎不影响模型输出效果的前提下,大幅提升了长文本训练和推理效率。
一句话:
五、完整调用链路全景图
第2层 PyTorch C++ (ATen) ,类型转换、分发路由、编织计算图,Token ID → 张量。
第3层 CUDA Driver API ,分配显存、切分任务、加载内核 ,计算图 → PTX/SASS指令。
第4层 GPU硬件,执行CUDA Kernel(矩阵乘法、注意力), HBM ↔ SRAM ↔ Tensor Core。
六、DeepSeek在每一层的“独门绝技”
💎 写在最后
一行model.generate(input_ids),在Python层被“传话”,在C++层被“画图”,在CUDA层被“翻译+切碎”,最后在GPU的Tensor Core里被“疯狂计算”。
每一层都在做减法:
而你感受到的,只是屏幕上那个一个字一个字往外蹦的答案。
671B参数、1M上下文、毫秒级响应
下一次你按下回车的时候,可以想想:
---
觉得有用?点个「星标」让更多人看懂大模型背后的“代码长征”吧~
(提供品牌正负舆情维护、渠道营销、百科创建等品牌营销解决方案)
研自有道,品必天成
共建极致用户体验!
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:596563534@qq.com 。
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- 从入门到贡献:MicroPython 内核开发的科普与入门路径
- 深度解析:树莓派Pico上MicroPython v1.23.0 到 v1.27.0 版本迭代差异
- 这6个Python代码专治各种不顺手
- 42个让你高效办公的Python自动化项目(附带案例)
- 计算机毕设选题:Python与Hadoop+Spark中医药数据系统源码 毕业设计 选题推荐 毕设选题 数据分析 机器学习 深度学习
- 《牛来》Python制作股票分析工作台
- 奉劝想自学 Python 的人,别再自我感动了
- 穷学生自学Python,真的骂醒一个是一个!!
- 领导就爱看大屏:一个Python脚本,把DRG结算数据变成运营驾驶舱
- 去tm的python教程,我玩星露谷去了!