- Python 的 re 模块是用于处理正则表达式的标准库模块。
- 通过 re 模块,可以在 Python 中使用正则表达式来处理字符串。
处理文本时,我们经常要搜寻特定格式内容、替换字符,像校验邮箱、提取网页链接、整理文本都属于这类场景。手动编写代码实现会十分麻烦,正则表达式就能简洁高效地完成这类工作。import relst = re.findall(r"\d+", "my munber is 10086,my friend number is 10010")print(lst)it =re.finditer(r"\d+", "my munber is 10086,my friend number is 10010")print(it)for i in it: print(i.group())s = re.search(r"\d+", "my munber is 10086,my friend number is 10010")print(s.group())s = re.match(r"\d+", "10086,10010")print(s.group())obj = re.compile(r"\d+")ret = obj.finditer("my number is 10086,my girlfriend number is 10010")print(ret)for i in ret: print(i.group()) s = """ <div class='jay'><span id='1'>郭麒麟</span></div> <div class='jj'><span id='2'>宋轶</span></div> <div class='jolin'><span id='3'>大聪明</span></div> <div class='tory'><span id='4'>范思哲</span></div> <div class='tory'><span id='5'>胡说八道</span></div> """obj = re.compile(r"<div class='.*?'><span id='.*?'>(?P<name>.*?)</span></div>",re.S)result = obj.finditer(s)for it in result: print(it.group("name"))
导入正则表达式模块,Python 正则全部依靠 re。lst = re.findall(r"\d+", "my munber is 10086,my friend number is 10010")
- 作用:找到字符串中所有匹配内容,直接封装成列表返回
it = re.finditer(r"\d+", "my munber is 10086,my friend number is 10010")
- 找到所有匹配项,返回迭代器,不是直接返回文本。迭代器里面存放的是匹配对象。
for i in it: print(i.group())
s = re.search(r"\d+", "my munber is 10086,my friend number is 10010")
- re.search():在整个字符串里找到第一个匹配内容,返回匹配对象。找到第一个就停止向后查找。
s = re.match(r"\d+", "10086,10010")
- re.compile():预编译正则表达式把正则模板提前编译成对象,适合一段正则反复多次使用,提升运行效率。
ret = obj.finditer("my number is 10086,my girlfriend number is 10010")
- 使用编译好的正则对象调用 finditer,效果等价 re.finditer(r"\d+",文本)
s = """ <div class='jay'><span id='1'>..."""
obj = re.compile(r"<div class='.*?'><span id='.*?'>(?P<name>.*?)</span></div>",re.S)
- (?P<name>.*?):命名分组,给分组起名字 name,方便后续通过名字取值
- re.S 等价 re.DOTALL:让 . 可以匹配换行符,否则无法跨行匹配
for it in result: print(it.group("name"))
.group("name"):根据分组名称,直接取出命名分组内捕获到的文本
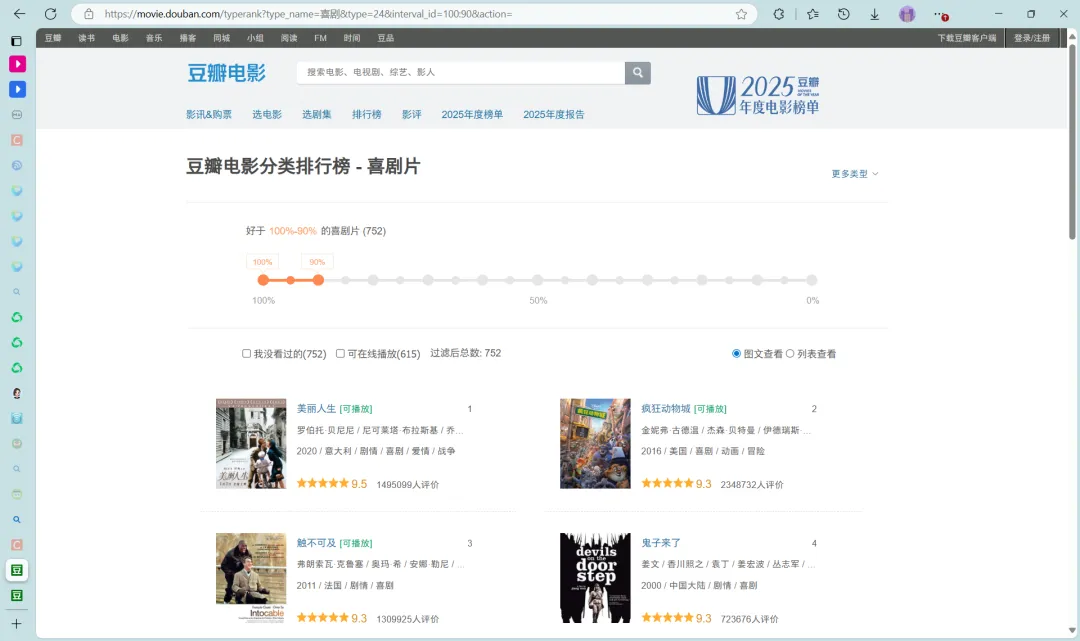
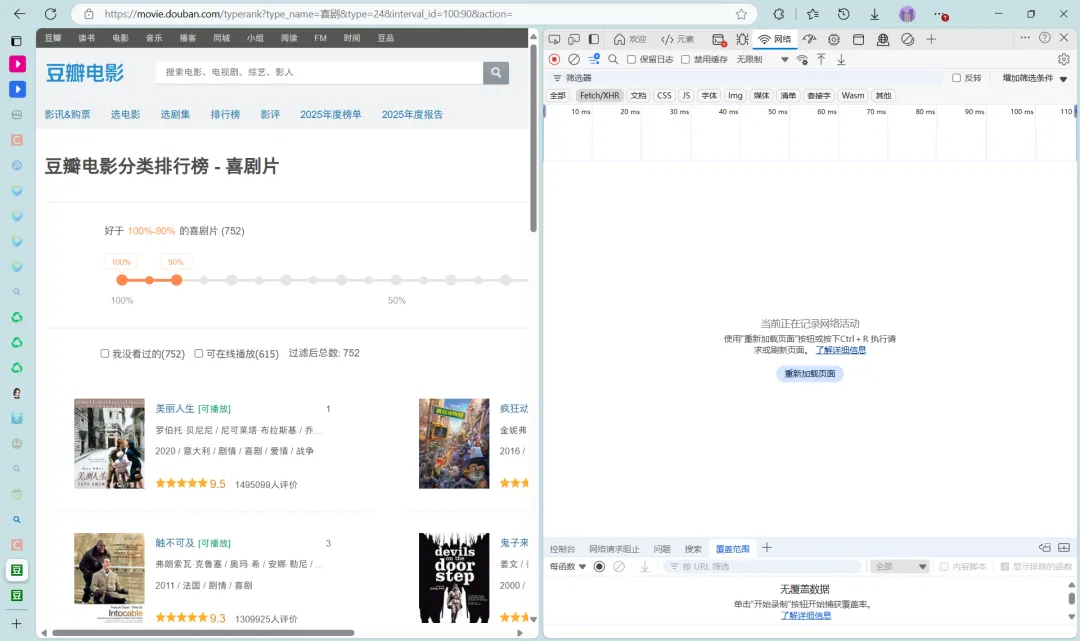
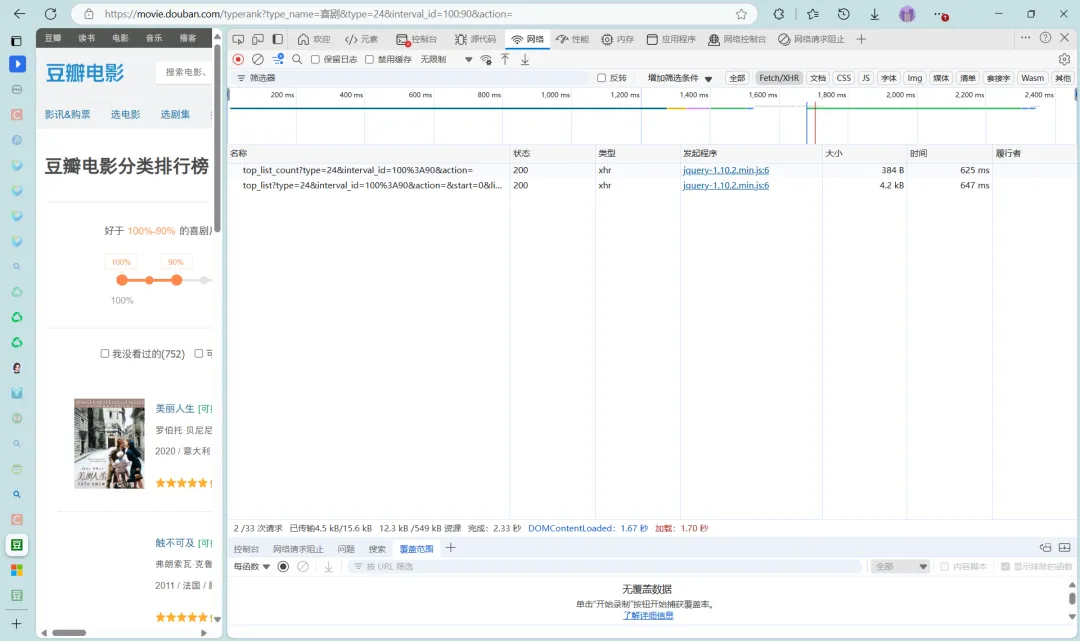
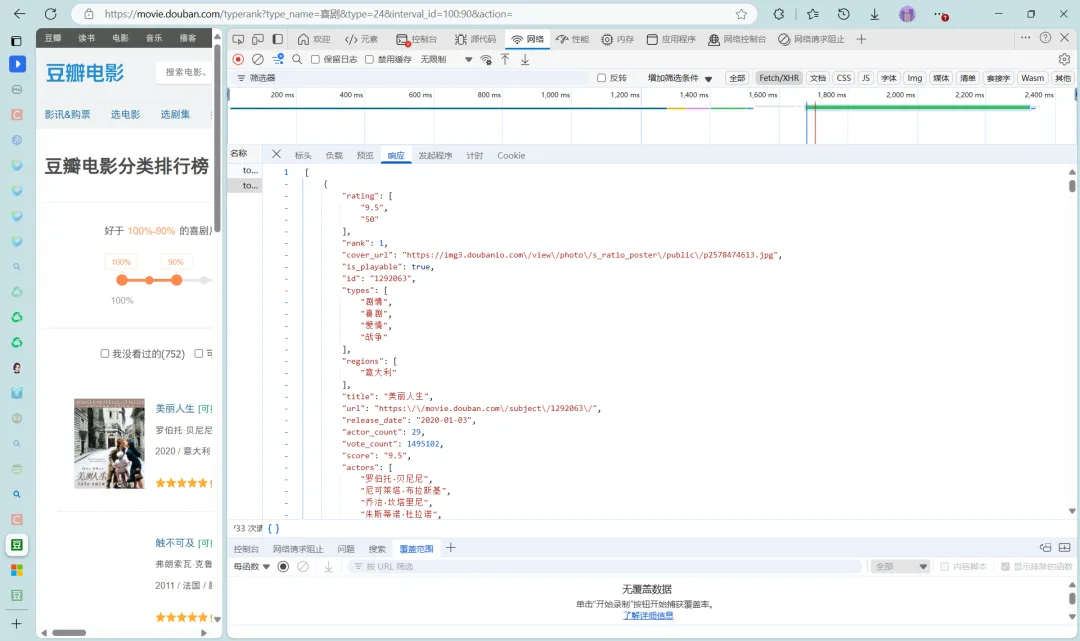
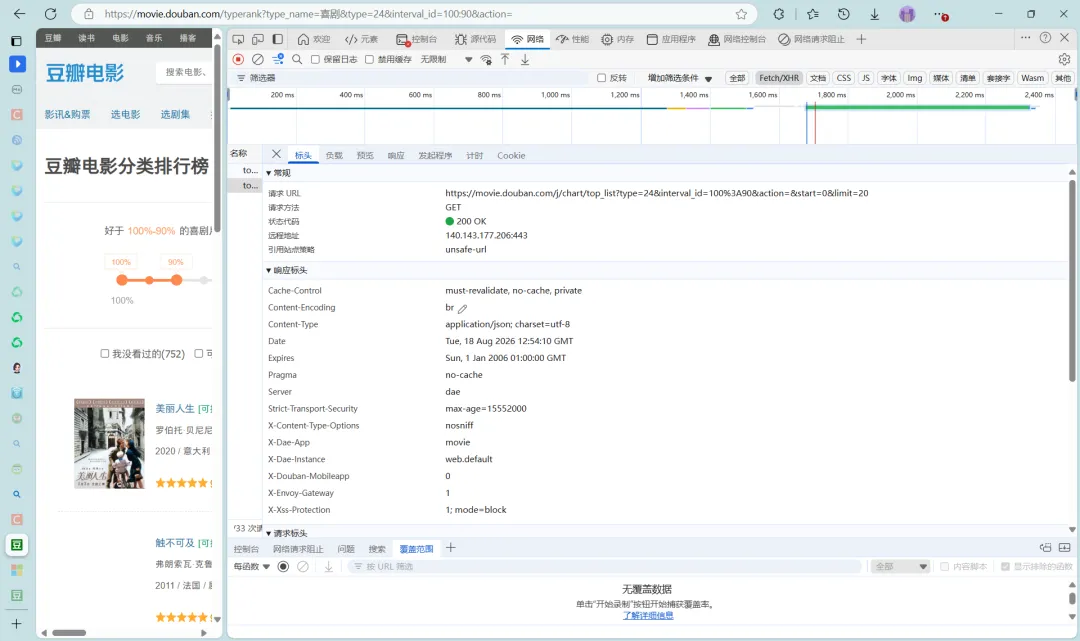
1. 我们可以在浏览器看到豆瓣的喜剧篇的排行榜,但是地址栏中的url并不是我们爬取的目标地址(不信可以试试),需要我们在浏览器中按下F12,找到网络,点击Fetch/XHR,可以看到里面并没有内容,我们现在按下ctrl+r,或者点击重新加载页面,因为我们在打开网页的时候浏览器并没有记录网络活动。2. 现在我们可以看到有两条记录,因为(懒)第二条中包含了榜单上的信息,所以我们点击第二条,可以看到在响应中确实包含了榜单中的信息。3. 我们再点击标头,可以看到我们真正的目标url是:https://movie.douban.com/j/chart/top_list
import requestsimport repage = 20url = "https://movie.douban.com/j/chart/top_list"for page in range(20,101,20): headers = {"user-agent":"Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/138.0.0.0 Safari/537.36 Edg/138.0.0.0"} param = { "type": "24", "interval_id": "100:90", "action": "", "start": "20", "limit": str(page) }resp = requests.get(url,headers=headers,params=param)obj = re.compile(r'"title"\s*:\s*"(?P<title>.*?)"', re.S)res = obj.finditer(resp.text)for it in res: print(it.group("title"))
由于篇幅限制(懒),就不一步一步写代码了。接下来解释一下以上代码:for page in range(20,101,20):
range(起始,终止,步长)循环取值:20、40、60、80、100param = { "type": "24", "interval_id": "100:90", "action": "", "start": "20", "limit": str(page)}
resp = requests.get(url, headers=headers, params=param)
发起 GET 请求,自动把 param 字典拼接在 url 后面,拿到接口返回数据。obj = re.compile(r'"title"\s*:\s*"(?P<title>.*?)"', re.S)
- "title"\s*:匹配任意数量空白(空格、制表符)
- (?P<title>.*?):命名分组,捕获电影名称,命名为
- title.*?:非贪婪匹配,防止一次性跨多条数据匹配
注意:网络爬虫有风险,网站可能封IP,还请遵守法律规范,控制爬取频率,以上代码仅供python学习,禁止利用爬虫绕过限制,攻击网站。