MCU上不敢malloc怕碎片,Linux上随便new不操心——MMU加三层分配器让物理碎片不再致命,本文从MCU到Linux理清四层内存架构。
一、MCU内存模型 物理地址的囚笼
MCU内存是编译时定死的硬平面图,每个地址都是真实物理地址:
0x08000000 ┌────────────┐ │ .text │ ← Flash:代码段(只读)0x08002000 ├────────────┤ │ .rodata │ ← Flash:只读数据(字符串常量)0x20000000 ├────────────┤ │ .data │ ← RAM:已初始化全局变量(启动代码从Flash搬过来)0x20001000 ├────────────┤ │ .bss │ ← RAM:未初始化全局变量(启动代码清零)0x20002000 ├────────────┤ │ heap │ → 往高地址长(malloc/free在这片区域)0x20008000 ├────────────┤ │ ...空闲...│0x20010000 ├────────────┤ │ stack │ ← 往低地址长(局部变量、函数调用)0x20018000 ├────────────┤ │ 外设寄存器 │ ← 内存映射I/O0x20020000 └────────────┘每个地址都是真实的物理地址
// MCU上malloc三宗罪// 宗罪一:外部碎片——分配和释放交替进行char *a = malloc(100); // 分配100字节在 heap 底部char *b = malloc(50); // 分配50字节紧挨着free(a); // 释放100字节 → heap中间有个100字节的洞char *c = malloc(80); // 要找 ≥80 的洞→100那个洞刚好→分裂成80+20空洞// 跑久了:heap里全是小空洞,找不到连续大块→malloc(1024)失败// 宗罪二:堆栈碰撞——heap往高长、stack往低长,撞上→互相踩数据→HardFault// 宗罪三:无保护——野指针踩别人内存,没有任何硬件机制阻止
物理地址空间平坦无保护——碎片不可逆转、溢出不可检测、越界不可阻止,这就是MCU上不敢用malloc的原因。
本节要点:MCU没有MMU,所有地址都是物理地址,malloc的碎片和越界没有任何硬件兜底。
二、RTOS过渡 heap_1到heap_5选型
FreeRTOS的heap_x.c决定堆行为,选对实现比写业务代码还重要:
| | | | |
|---|
| heap_1 | | | | |
| heap_2 | | | | |
| heap_3 | | | | |
| heap_4 | | | 首次适应+合并相邻空闲块 | |
| heap_5 | | | | |
heap_4维护按地址升序的空闲块链表,首次适应+合并相邻块。heap_5通过vPortDefineHeapRegions()注册多段物理内存:
HeapRegion_t xHeapRegions[] = { { (uint8_t *)0x20000000, 0x00010000 }, // 片内RAM 64KB { (uint8_t *)0xC0000000, 0x00800000 }, // 外部SDRAM 8MB { NULL, 0 } // 数组结束标记};vPortDefineHeapRegions(xHeapRegions);// xHeapRegions 必须按地址从低到高排序
即使有heap_4/heap_5,老司机仍优先静态分配——任务生命周期贯穿系统,动态分配风险高、收益低,map文件直接给出地址和大小,HardFault时一眼定位:
// 推荐:静态创建任务static StaticTask_t s_xTaskTcb;static StackType_t s_xTaskStack[256];TaskHandle_t xHandle = xTaskCreateStatic( vTaskCode, "task", 256, NULL, 1, s_xTaskStack, &s_xTaskTcb);
本节要点:FreeRTOS选heap_4最通用,但优先静态分配才是嵌入式正道。
三、MMU与Linux内核分配器
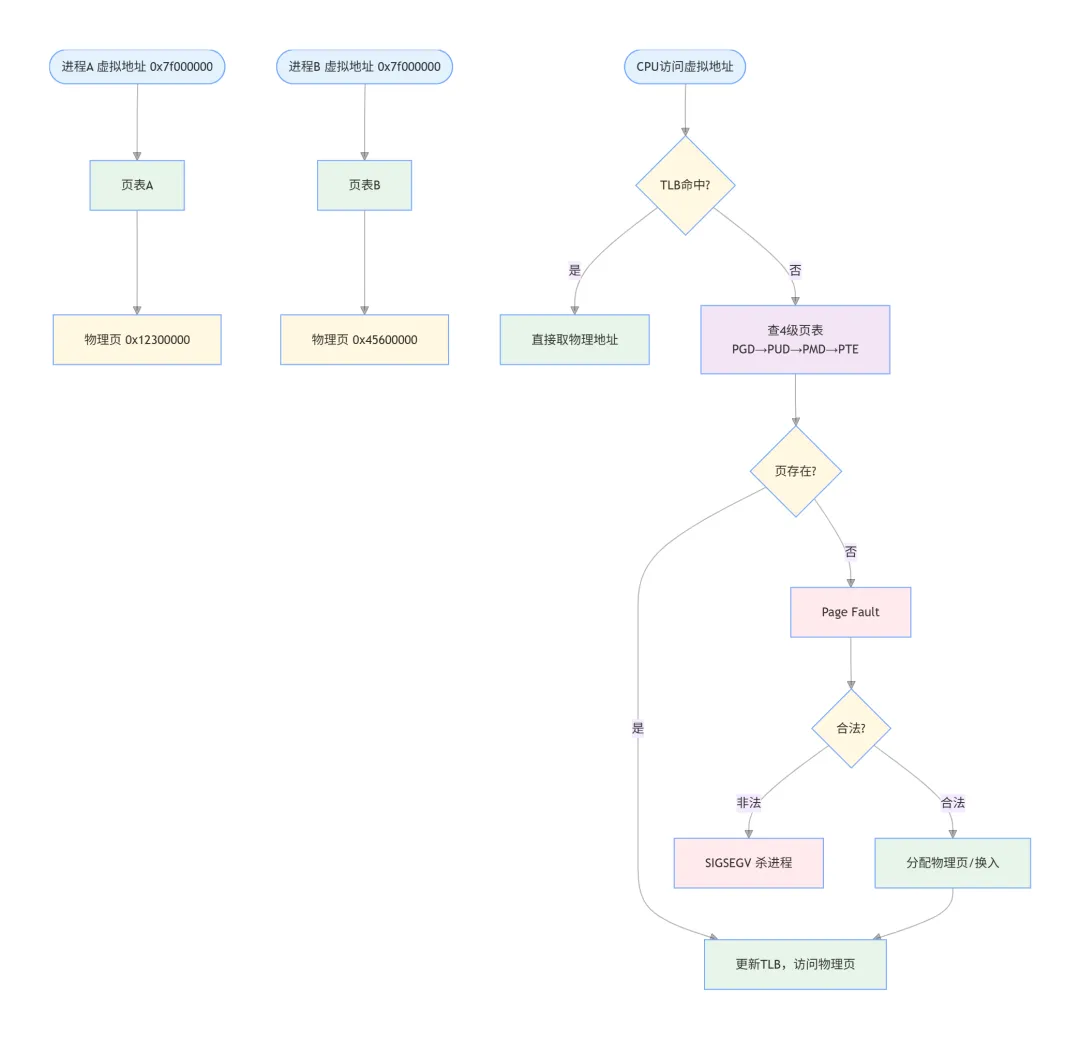
MMU在CPU和物理内存之间加了页表翻译——同一个虚拟地址在不同进程映射不同物理页,互不干扰:
x86_64用4级页表(PGD→PUD→PMD→PTE),每查一次4次内存访问,TLB缓存最近映射。缺页时CPU触发page fault——Major Fault从磁盘读,Minor Fault只改页表,非法访问发SIGSEGV杀进程:
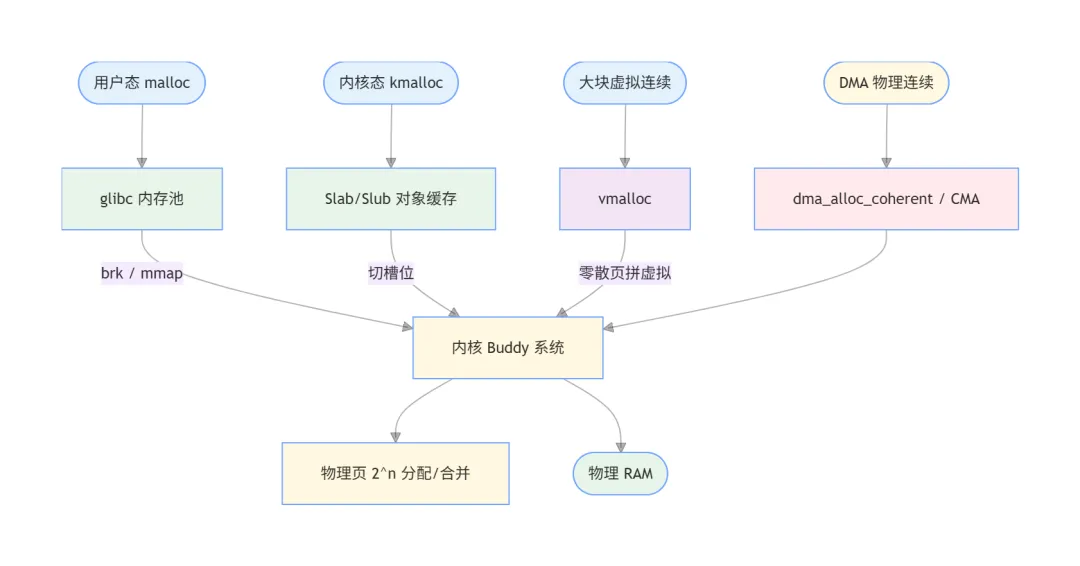
Buddy系统:内核物理页分配器,只分配2^n × 页大小的块,相邻空闲块自动合并。优点防外部碎片+O(log n),缺点内部碎片(申请8字节也分4KB页)。物理内存按Zone划分:ZONE_DMA(低16MB)、ZONE_DMA32(低4GB)、ZONE_NORMAL(内核直接映射)。嵌入式通常只有DMA32和NORMAL。
初始:256个连续空闲页(1MB) 分配100KB(需要32页:128KB的块): 256页块 → 拆:128页 + 128页 → 分配出去 释放这128页:相邻128页块也空闲?→ 合并为256页块cat /proc/buddyinfo# Node 0, zone Normal 1000 500 200 50 10 5 2 1 0 0 0# ↑1页 ↑2页 ↑4页 ↑8页 ↑16页...
Slab/Slub:从Buddy拿一页切成同大小槽位,按size class分配。kmalloc(10)走kmalloc-32。三种状态:FULL(从Buddy要新页)、PARTIAL(优先分配)、EMPTY(可还给Buddy):
cat /proc/slabinfo | head# slab_name active_objs num_objs objsize objperslab# task_struct 234 240 3264 10# kmalloc-32 1200 1280 32 128
vmalloc:物理碎片化时,在虚拟地址空间拼连续区域,零散4KB页通过页表映射成连续虚拟地址。代价:TLB条目多、访问慢、不能DMA。kmalloc给小内存(物理连续),vmalloc给大块(虚拟连续):
void *p = kmalloc(256, GFP_KERNEL); // 小内存,物理连续void *p = vmalloc(1024 * 1024); // 大内存,虚拟连续// insmod加载.ko模块就是vmalloc——不需要物理连续
DMA与CMA:DMA设备看物理地址,要求缓冲区物理连续。dma_alloc_coherent()分配uncached缓冲区长期持有(环形缓冲区、描述符环);dma_map_single()临时映射已有内存(网络skb、文件页缓存)。CMA启动时预留可迁移区域,平时借给普通页,驱动需要大连续物理内存时迁移走,兼顾日常利用率和DMA需求。
// 一致性DMAdma_addr_t dma_handle;void *cpu_addr = dma_alloc_coherent(dev, 4096, &dma_handle, GFP_KERNEL);// cpu_addr:CPU虚拟地址;dma_handle:DMA总线地址// 流式DMA映射dma_addr_t dma_handle = dma_map_single(dev, vaddr, size, DMA_TO_DEVICE);dma_unmap_single(dev, dma_handle, size, DMA_TO_DEVICE);
| dma_alloc_coherent | dma_map_single |
|---|
| | |
| | |
| | |
| | |
本节要点:MMU让虚拟地址掩盖物理碎片,Buddy管页、Slab管对象、vmalloc管大块、CMA管DMA,四层分工各管一摊。
四、用户态malloc glibc内存池
malloc(100)不走内核Buddy——先查glibc的freelist,有合适块直接返回不进内核。没有时:小内存(<128KB)走brk()扩展堆顶,大内存(≥128KB)走mmap()映射新区域,释放时munmap立刻还物理页:
// 小内存(< 128KB):用 brk()p = malloc(1024);// → brk 往上挪 → glibc切一块给p// 大内存(≥ 128KB):用 mmap()p = malloc(1024 * 1024);// → mmap 在虚拟地址空间找1MB空闲区域 → 映射物理页// 释放后 munmap 立刻还物理页给内核
glibc的freelist = 你手写内存池的next指针,只不过你的池从static uint8_t pool[SIZE]拿,glibc不够了找内核要。ASLR默认开启,每次启动地址随机偏移,阻止攻击者预测地址,调试需确定性时加nokaslr关闭。
本节要点:malloc先走用户态freelist,不够才进内核,glibc内存池本质就是你手写内存池的内核版。
五、全景对比与注意事项
| | | |
|---|
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
| | | dma_alloc_coherent |
| | | kmemleak, slub_debug, valgrind, ASan |
| | |
|---|
| kmalloc大块内存总失败 | | >128KB用vmalloc,或启动时预先kmalloc |
| 用户态free后还读 | | |
| 内核内存泄漏 | free_proc()忘匹配kfree,内存越用越少 | |
| OOM Killer乱杀进程 | | |
| vmalloc区域用完了 | | |
| GFP_ATOMIC失败率高 | | |
本节要点:三层系统各有软肋——MCU怕越界无感知,RTOS怕碎片化,Linux怕OOM和泄漏。
六、总结 四层塔的分工
- Linux内存管理是运行时基础设施,工具链完善但需理解层次
kmalloc跟malloc不比速度——一个走Slab/物理连续,一个走glibc/虚拟连续
MCU用脑子管内存,Linux用工具看内存——内存管理的本质没变,变的是谁来扛碎片、谁来挡越界。
 10个月宝宝每天需要喝多少奶粉?