一、真正的数据分析,不是先会很多库,而是先会提问题
很多人学完 Pandas 和 Matplotlib 之后,会进入一个很常见的阶段:
函数会一点 图也能画 表也能读 可真拿到一份数据,还是不知道从哪下手
这其实不是技术问题,而是分析思路还没建立起来。
因为真实的数据分析,不是把库的语法默写一遍,而是先想清楚:
这份数据里到底有什么 我最想看出什么 应该先做什么,再做什么 最后怎么把结果讲清楚
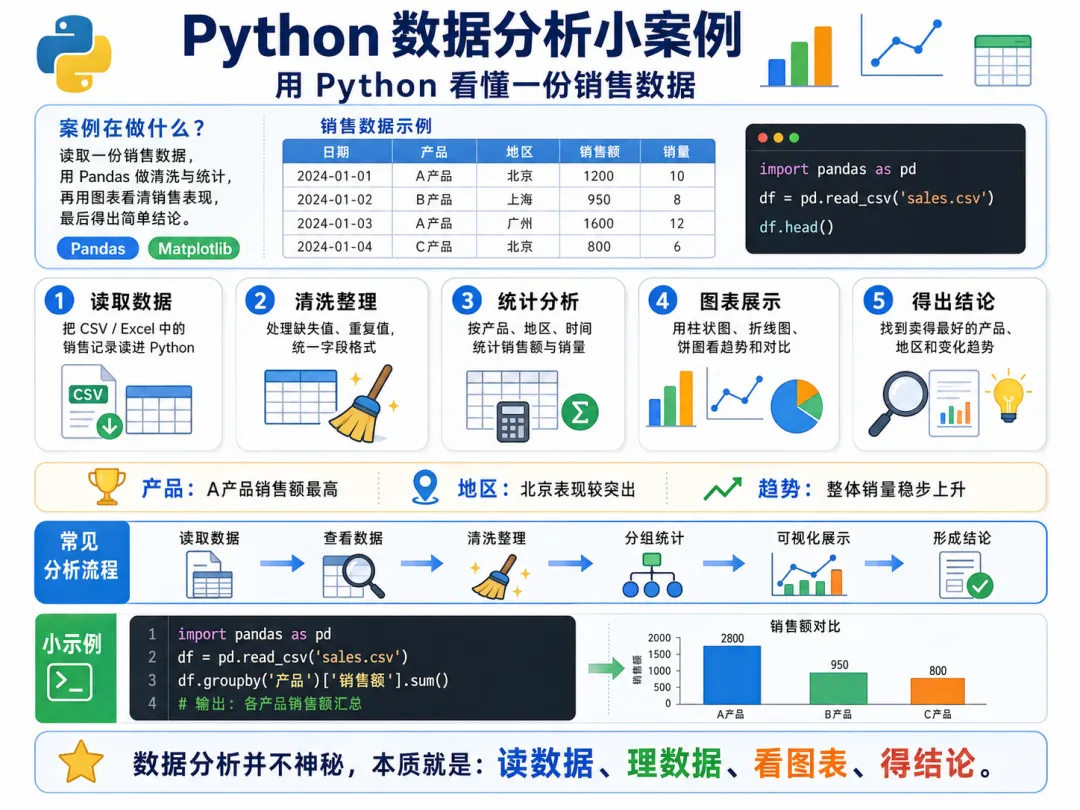
所以这一章我们不再零散练函数,而是做一个完整的小案例。 从读入数据,到清洗数据,再到统计分析、图表展示,完整走一遍。
你要学会的,不只是代码,而是一条很实用的分析路线。
二、先准备一份销售数据
假设我们现在有一份简单的销售表,字段包括:
日期 门店 商品 销量 单价
我们先手动构造一份数据,后面再一步步分析。
import pandas as pddata = {"日期": ["2025-01-01", "2025-01-01", "2025-01-02", "2025-01-02","2025-01-03", "2025-01-03", "2025-01-04", "2025-01-04","2025-01-05", "2025-01-05" ],"门店": ["北京", "上海", "北京", "广州","上海", "北京", "广州", "上海","北京", "广州" ],"商品": ["苹果", "苹果", "香蕉", "苹果","香蕉", "橙子", "橙子", "苹果","苹果", "香蕉" ],"销量": [120, 90, 150, 80, 130, 60, 95, 110, 140, 100],"单价": [5, 5, 3, 5, 3, 4, 4, 5, 5, 3]}df = pd.DataFrame(data)print(df)
输出大致会是这样:
日期 门店 商品 销量 单价02025-01-01 北京 苹果 120512025-01-01 上海 苹果 90522025-01-02 北京 香蕉 150332025-01-02 广州 苹果 80542025-01-03 上海 香蕉 130352025-01-03 北京 橙子 60462025-01-04 广州 橙子 95472025-01-04 上海 苹果 110582025-01-05 北京 苹果 140592025-01-05 广州 香蕉 1003
别急着分析,先养成一个好习惯: 每拿到一份数据,先看清楚它长什么样。
三、第一步不是分析,是先认识数据
先看前几行:
print(df.head())
看整体信息:
print(df.info())
看数值列的基本统计:
print(df.describe())
这三步非常重要。 因为你必须先知道:
有多少行 有多少列 每列是什么类型 数值范围大概怎样 有没有空值 有没有明显异常
如果一上来就开始画图、做分组,很容易分析错方向。
比如 日期 明明还是字符串,你却以为已经是时间类型。 比如 销量 这一列混进了空值或者字符串,你却直接拿去统计。 这些问题在真实数据里非常常见。
所以数据分析第一原则是:
先认识数据,再解释数据。
四、先补上一列最关键的数据:销售额
原表里只有销量和单价,但分析销售数据时,最核心的指标之一通常是销售额。
计算方式很简单:
销售额 = 销量 × 单价
直接新增一列:
df["销售额"] = df["销量"] * df["单价"]print(df)
这一步做完后,表会变成:
日期 门店 商品 销量 单价 销售额02025-01-01 北京 苹果 120560012025-01-01 上海 苹果 90545022025-01-02 北京 香蕉 150345032025-01-02 广州 苹果 80540042025-01-03 上海 香蕉 130339052025-01-03 北京 橙子 60424062025-01-04 广州 橙子 95438072025-01-04 上海 苹果 110555082025-01-05 北京 苹果 140570092025-01-05 广州 香蕉 1003300
这一步其实不只是“加一列”,而是在建立分析核心指标。
以后你做订单分析、运营分析、商品分析时,会经常遇到这种情况:
原始数据里不一定直接给你核心指标 但你可以根据现有字段自己推导出来
这也是数据分析里很常见的一种能力。
五、第二步:先看整体,而不是一上来盯细节
很多人分析数据时,一开始就去看某个门店、某个商品。 其实更稳妥的做法是,先看整体轮廓。
比如先回答几个最基础的问题:
总销量是多少 总销售额是多少 平均每条记录卖了多少 最高销量是多少 最低销量是多少
代码很简单:
print("总销量:", df["销量"].sum())print("总销售额:", df["销售额"].sum())print("平均销量:", df["销量"].mean())print("最高销量:", df["销量"].max())print("最低销量:", df["销量"].min())
如果结果是:
总销量: 1075总销售额: 4460平均销量: 107.5最高销量: 150最低销量: 60
那你脑子里就开始有整体感觉了。 这一步虽然不复杂,但很重要,因为它是在先建立“全局印象”。
真实分析里,很多误判都来自于上来就钻局部。
六、第三步:按门店看,先看谁卖得更好
当你对整体有了感觉后,下一步通常就是拆维度。 销售数据最常见的维度之一,就是门店。
我们想回答的问题可能是:
哪家门店销量最高 哪家门店销售额最高 不同门店的平均单次销售表现如何
这时就可以按门店分组:
store_summary = df.groupby("门店")[["销量", "销售额"]].sum()print(store_summary)
结果大致会是:
销量 销售额门店北京 4701990上海 3301390广州 2751080
这时候你就能得到一个非常直观的结论:
北京门店整体表现最好 上海其次 广州目前最弱
但注意,分析不能只停留在“谁高谁低”。 你还要继续想:
为什么北京高 是因为苹果卖得特别好 还是因为订单数量更多 还是因为商品结构不同
这时就需要继续往下拆。
七、第四步:按商品看,找出真正的主力商品
很多时候,门店的强弱,背后其实是商品结构在起作用。 所以接下来最常见的动作就是按商品分组。
product_summary = df.groupby("商品")[["销量", "销售额"]].sum()print(product_summary)
结果大致会是:
销量 销售额商品苹果 5402700香蕉 3801140橙子 155620
你会立刻发现:
苹果是绝对主力 香蕉也不差 橙子贡献最弱
这时候你就可以形成第二层理解:
北京门店为什么强,可能和苹果销售表现好有关 整体销售额为什么高,和苹果单价高也有关系
数据分析里特别重要的一点是: 别只停留在结论表面,要继续往后追原因。
八、第五步:交叉分析门店和商品,才开始接近真实业务判断
前面按门店看、按商品看,其实都还是单维度。 但真实业务里,往往更有价值的是交叉分析。
比如:
北京门店到底靠什么商品卖得好 上海门店的苹果是不是特别强 广州门店是不是橙子卖得还行,但苹果一般
这时就要按“门店 + 商品”一起分组:
store_product_summary = df.groupby(["门店", "商品"], as_index=False)[["销量", "销售额"]].sum()print(store_product_summary)
结果大致会是:
门店 商品 销量 销售额0 北京 苹果 26013001 北京 香蕉 1504502 北京 橙子 602403 上海 苹果 20010004 上海 香蕉 1303905 广州 苹果 804006 广州 香蕉 1003007 广州 橙子 95380
这张表很有价值,因为它已经开始回答业务层面的问题了。
比如你能看出:
北京的苹果最强 上海的苹果也不错 广州的苹果相对偏弱 广州的橙子反而不算太差
这就比单纯看总销量更像真正的分析。
九、第六步:按日期看趋势,别只看汇总
汇总数据很重要,但如果只看总和,你会忽略趋势。
比如你还想知道:
销售额是不是每天都在涨 有没有哪一天突然特别高 某些波动是偶然还是趋势
这时候应该按日期聚合:
daily_summary = df.groupby("日期")[["销量", "销售额"]].sum().reset_index()print(daily_summary)
结果大致会是:
日期 销量 销售额02025-01-01210105012025-01-0223085022025-01-0319063032025-01-0420593042025-01-052401000
从这个结果你就能看出:
1月3日整体偏弱 1月5日销量最高 销售额并不完全跟销量同步,因为还受到商品单价影响
这一步特别重要,因为趋势分析和结构分析往往要结合起来看。 只看总量,你很容易错过一些变化节奏。
十、第七步:把趋势画出来,很多问题一眼就明白了
表格能看出信息,但图表更适合看趋势。
我们用 Matplotlib 画一张每日销售额折线图:
import matplotlib.pyplot as pltplt.rcParams["font.sans-serif"] = ["SimHei"]plt.rcParams["axes.unicode_minus"] = Falseplt.plot(daily_summary["日期"], daily_summary["销售额"], marker="o")plt.title("每日销售额趋势")plt.xlabel("日期")plt.ylabel("销售额")plt.grid(True)plt.show()
图一出来,你会发现很多表格里不够直观的东西,一下变得很明显:
哪天高 哪天低 波动大不大 整体有没有上升趋势
这也是为什么真正的数据分析,往往是“表 + 图”一起看。 表适合精确读数,图适合快速看结构和趋势。
十一、第八步:做一个门店销售额柱状图,看看差异到底有多大
前面我们已经按门店汇总过了。 接下来把门店销售额画成柱状图:
store_summary = df.groupby("门店")["销售额"].sum().reset_index()plt.bar(store_summary["门店"], store_summary["销售额"])plt.title("各门店销售额对比")plt.xlabel("门店")plt.ylabel("销售额")plt.show()
柱状图特别适合比较类别差异。
这张图一出来,北京和上海、广州之间的差距就比表格更直观了。
很多管理汇报、业务分析报告里,最常见的图其实就是这种。 因为它能非常直接地回答:
谁做得更好 差多少 谁需要重点关注
十二、第九步:别只会看总额,也要看平均值
很多人做销售分析时,只盯总销量和总销售额。 这当然重要,但还不够。
因为总量高,不一定说明“单次表现好”。 有时只是记录更多、订单更多、样本更大。
所以你还要看平均值。
比如看各门店平均销售额:
store_avg = df.groupby("门店")["销售额"].mean().reset_index()print(store_avg)
结果大致会是:
门店 销售额0 北京 497.5000001 上海 463.3333332 广州 360.000000
这说明:
北京不只是总量高,单条记录平均贡献也更强 广州不只是总量弱,平均表现也偏弱
所以平均值的意义在于:
帮你判断“质量”而不只是“规模”
这在真实分析里非常重要。
十三、第十步:排序,把重点直接排出来
有些分析结果一出来,最好不要让别人自己慢慢找。 你应该主动把重点排在前面。
比如按商品销售额降序:
product_summary = df.groupby("商品", as_index=False)[["销量", "销售额"]].sum()product_summary = product_summary.sort_values("销售额", ascending=False)print(product_summary)
结果会自动把最重要的商品放在前面。
按门店销售额降序:
store_summary = df.groupby("门店", as_index=False)[["销量", "销售额"]].sum()store_summary = store_summary.sort_values("销售额", ascending=False)print(store_summary)
排序这个动作看起来简单,但特别重要。 因为分析结果不是只给自己看,往往还要给别人看。 排序能让信息重心更明确。
十四、第十一步:筛出关键记录,而不是一直看全表
分析时还有一个非常高频的动作,就是只看关键记录。
比如我们只想看销售额大于 500 的记录:
high_sales = df[df["销售额"] > 500]print(high_sales)
只看苹果商品:
apple_df = df[df["商品"] == "苹果"]print(apple_df)
只看北京门店的苹果:
bj_apple = df[(df["门店"] == "北京") & (df["商品"] == "苹果")]print(bj_apple)
这种筛选的意义在于:
把“大海捞针”变成“精准看重点”
真实工作里,很多时候你不是在分析所有数据,而是在聚焦:
高价值客户 高销售商品 低表现门店 异常日期 重点渠道
所以筛选能力,永远是分析基本功。
十五、第十二步:分析异常值和异常点,是很有价值的一步
很多初学者做分析时,只会算平均值、总和。 但真实业务里,异常点经常比平均值更值得看。
比如这份数据里,销量最高的是哪条:
max_sales_row = df[df["销量"] == df["销量"].max()]print(max_sales_row)
销售额最高的是哪条:
max_amount_row = df[df["销售额"] == df["销售额"].max()]print(max_amount_row)
这种分析的意义在于:
找到“最突出”的记录 看看它为什么突出 这种突出是正常规律,还是偶发异常
比如你发现某天销售额特别高,可能是:
活动促销 新品上线 节假日影响 某个门店突然爆单
这时数据分析就开始从“做表格题”往“做业务判断”走了。
十六、第十三步:做分析时,尽量把结论写成业务语言
很多人写分析,只写代码和结果数字。 但真正有价值的是,你能把数字翻译成业务语言。
比如刚才这份销售数据,如果你只写:
北京销售额 1990 上海销售额 1390 广州销售额 1080
这当然没错,但还不够像分析。
更像分析的表达会是:
北京门店当前整体表现最好,销售额明显领先 苹果是当前最核心的销售主力,对总销售额贡献最大 广州门店整体偏弱,后续可以重点观察苹果品类是否存在提升空间 从按日趋势来看,1月3日销售额明显回落,值得进一步排查当天商品结构或客流变化
你看,同样是数据,翻译成业务语言后,价值一下就不一样了。
所以做数据分析时,千万别只满足于“算出来了”。 还要问一句:
这组结果说明了什么。
十七、第十四步:把分析过程写成固定套路,后面就会越来越顺
很多新手一遇到新数据就发懵,本质上不是能力不够,而是没有固定分析框架。
你完全可以给自己建立一套通用流程:
先读数据 再看结构 补核心指标 看整体概况 按关键维度拆分 看趋势 看对比 筛重点 找异常 最后总结结论
你会发现,绝大多数表格型分析,其实都能往这套流程里套。
比如换成订单数据,也一样:
先看订单总量 再看销售额 再按城市拆 按渠道拆 按日期看 再找异常订单和高价值订单
只要分析框架建立起来,你面对新数据时就不会那么乱。
十八、第十五步:一个更完整的分析脚本示例
下面我们把前面这些动作串成一个稍完整的脚本。
import pandas as pdimport matplotlib.pyplot as pltplt.rcParams["font.sans-serif"] = ["SimHei"]plt.rcParams["axes.unicode_minus"] = Falsedata = {"日期": ["2025-01-01", "2025-01-01", "2025-01-02", "2025-01-02","2025-01-03", "2025-01-03", "2025-01-04", "2025-01-04","2025-01-05", "2025-01-05" ],"门店": ["北京", "上海", "北京", "广州","上海", "北京", "广州", "上海","北京", "广州" ],"商品": ["苹果", "苹果", "香蕉", "苹果","香蕉", "橙子", "橙子", "苹果","苹果", "香蕉" ],"销量": [120, 90, 150, 80, 130, 60, 95, 110, 140, 100],"单价": [5, 5, 3, 5, 3, 4, 4, 5, 5, 3]}df = pd.DataFrame(data)df["销售额"] = df["销量"] * df["单价"]print("数据预览:")print(df.head())print("\n整体概况:")print("总销量:", df["销量"].sum())print("总销售额:", df["销售额"].sum())print("\n按门店汇总:")store_summary = df.groupby("门店", as_index=False)[["销量", "销售额"]].sum()print(store_summary)print("\n按商品汇总:")product_summary = df.groupby("商品", as_index=False)[["销量", "销售额"]].sum()print(product_summary)print("\n按日期汇总:")daily_summary = df.groupby("日期", as_index=False)[["销量", "销售额"]].sum()print(daily_summary)plt.figure(figsize=(10, 4))plt.plot(daily_summary["日期"], daily_summary["销售额"], marker="o")plt.title("每日销售额趋势")plt.xlabel("日期")plt.ylabel("销售额")plt.grid(True)plt.show()plt.figure(figsize=(6, 4))plt.bar(store_summary["门店"], store_summary["销售额"])plt.title("各门店销售额对比")plt.xlabel("门店")plt.ylabel("销售额")plt.show()
这段代码不复杂,但已经具备了一个小分析脚本的基本结构。 以后你再分析其他表格数据,完全可以按这个思路去改。
十九、第十六步:如果数据来自 CSV 或 Excel,该怎么改
刚才的数据是我们手动造的。 真实项目里,数据通常来自文件。
如果是 CSV:
df = pd.read_csv("sales.csv")
如果是 Excel:
df = pd.read_excel("sales.xlsx")
之后的流程其实几乎不变:
补指标 看概况 做分组 做图表 写结论
这也是为什么说,学会一个小案例,比背很多碎片知识更值钱。 因为你以后面对真实文件时,只是在替换“数据来源”,分析套路并没有变。
二十、第十七步:这类小案例里,最容易犯的几个错误
1. 一上来就分组,没先看数据结构
这样很容易对错列、空值、类型问题毫无察觉。
2. 只看总量,不看平均值和结构
总销售额高,不代表商品结构健康。 总销量高,也不代表单次表现强。
3. 只看汇总,不看趋势
趋势能帮助你看到波动和变化节奏。
4. 只会给数字,不会写结论
这会让分析停留在“计算”层面,没有真正进入“判断”层面。
5. 图能画出来,但图选错了
趋势看折线 类别对比看柱状 变量关系看散点 这一点要慢慢建立直觉
二十一、这一章真正想让你学会的,不只是一个案例
你表面上学的是一份销售数据怎么分析。 但更深一层,你其实是在学一种通用套路:
看到表格数据后,怎么一步步拆开看 怎么从明细走向汇总 怎么从数字走向图表 怎么从结果走向结论
以后你拿到成绩表、库存表、订单表、用户表,甚至爬虫抓下来的结果表,思路都可以复用。
这才是小案例真正的价值。
二十二、本章要点整理
销售数据分析的基本流程通常是:读数据、看结构、补指标、看整体、按维度拆分、看趋势、画图、写结论。 新增核心指标是很常见的动作,比如用销量和单价计算销售额。 整体统计能帮助你快速建立全局印象。 按门店、按商品、按日期分组,是销售分析里最常见的拆分方式。 折线图适合看趋势,柱状图适合看对比。 分析时不能只停留在数字本身,还要把结果翻译成业务语言。 真正重要的,不是会不会某一个函数,而是能不能建立稳定的数据分析套路。
 10个月宝宝每天需要喝多少奶粉?