其实这是一个简版的Python Tool Pro for Petrel™(关于PTP,参见:https://www.slb.com/zh-cn/products-and-services/delivering-digital-at-scale/software/delfi/openness/python-tool-pro-for-petrel-subsurface-software
以下是该网页的机器翻译内容:
概述
Python Tool Pro 将 Petrel™ 地下软件与 Python 连接,实现自动化、机器学习与可扩展性,助力地下团队在无需离开 Petrel 软件环境的前提下加速工作流并获取更深层次的洞察。
通过将 Python 直接集成至 Petrel™ 地下软件,充分释放地下数据的更多价值。
SLB 与合作伙伴 Cegal 协作,通过 Python Tool Pro 进一步拓展了可扩展性,简化了工作流自动化,支持在 Petrel 软件项目中开展高级分析并加速创新。
随着数据量持续增长、工作流日益复杂,效率低下会削弱生产力并延缓决策进程。手动数据传输与数据重复使得数据科学工具难以在地质科学与工程工作流中实现规模化与全面集成。
我们正在弥合这一鸿沟,将 Petrel 软件与 Python 生态系统无缝连接,从而为地下解释与工程工作带来更具灵活性、可扩展性的解决方案。
工作原理
将 Python 驱动的自动化与分析能力直接引入 Petrel 软件
Petrel 地下软件的 Python Tool Pro 支持用户直接在 Petrel 软件数据上运行 Python 工作流,实现解释自动化、应用机器学习,并在同一环境中回写结果。
由此构建从数据访问到洞察生成的端到端无缝工作流。
优势
加速解释、自动化工作流、发掘全新洞察
- 减少手动解释时间通过脚本化数据预处理、质量控制与解释工作流,实现重复性流程的自动化。
- 扩展机器学习工作流利用 Python 库,直接在 Petrel 软件数据上运行聚类、地震数据预处理与预测模型。
- 消除数据传输瓶颈直接在 Petrel 软件环境中作业,无需导出或重新导入数据集。
- 贯通地下生态系统通过 Python API 将 Petrel 软件与外部工具、数据库及地理空间平台连接。
应用场景
在 Petrel 软件内部将 Python 应用于真实地下工作流。
Python Tool Pro 支持广泛的地质科学与工程应用,助您:
- 构建定制化仪表盘,对 Petrel 软件数据进行交互式探查与分析。
- 使用自定义脚本或调用强大的 Python 库,实现动态数据可视化。
功能特性
面向 Petrel 软件工作流的灵活、可扩展 Python 集成
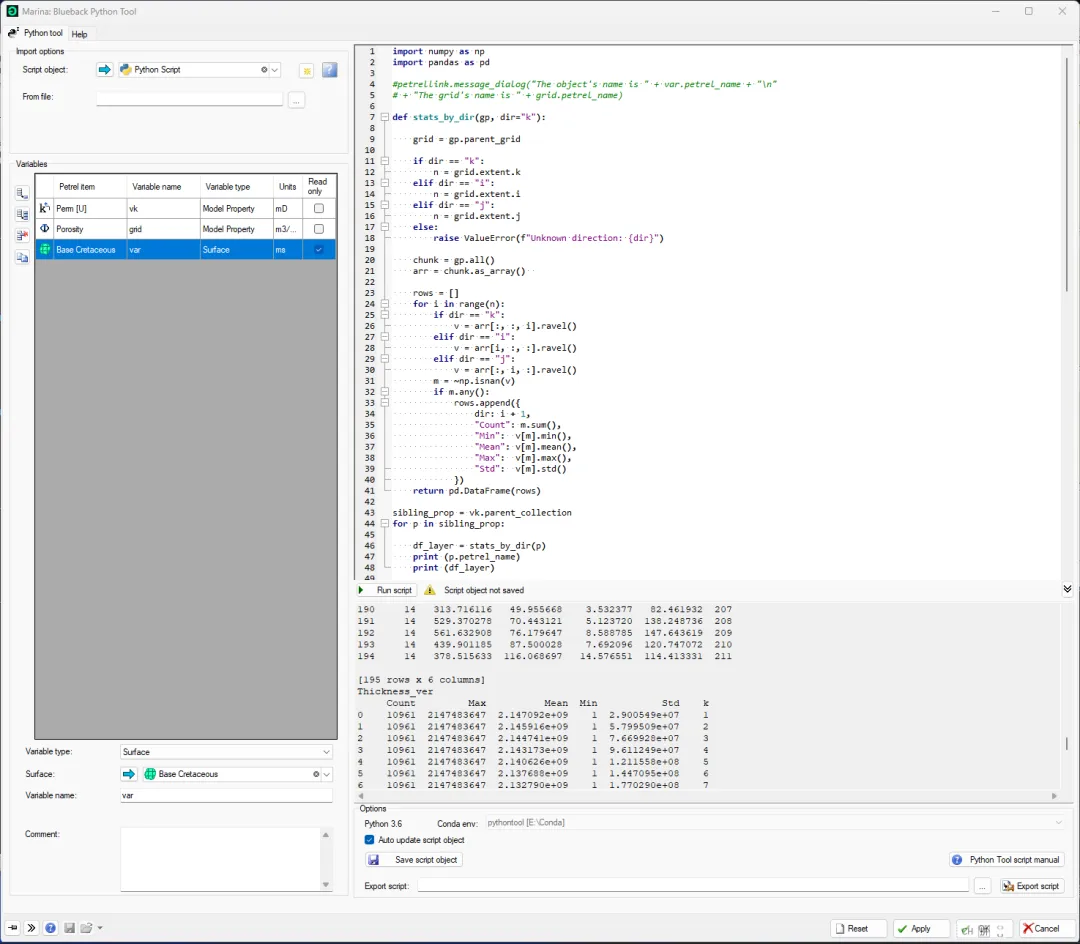
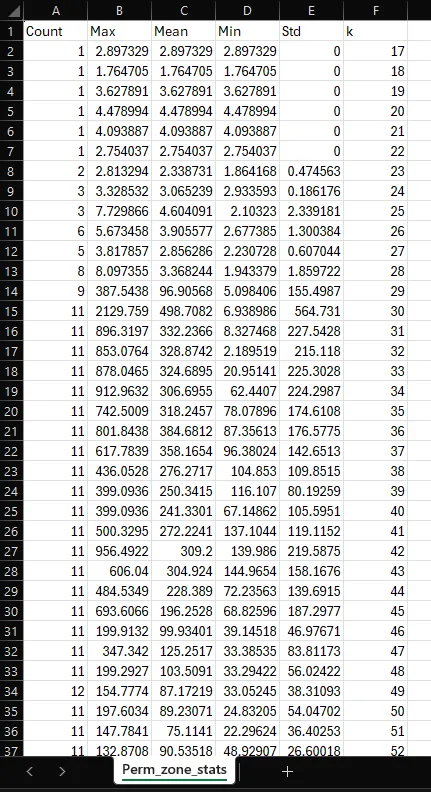
Petrel 软件内直接 Python 脚本编写:以编程方式访问各类 Petrel 软件对象,包括井、测井、地震数据体、曲面、网格、解释成果等。Python 计算结果自动转换并写回 Petrel 软件,仅需一行代码即可实现无缝的端到端工作流集成。借助丰富的 Python 库生态,加速自动化、高级分析与自定义工具开发。Python Tool Pro 用户可直接在 Petrel 软件数据上应用复杂的机器学习算法。而Blueback Python tool,目前仍然是Cegal(原Blueback reservoir)的Blueback Toolbox:它很快就教会了我写好一个按layer统计数据的脚本:import numpy as npimport pandas as pd#petrellink.message_dialog("The object's name is " + var.petrel_name + "\n"# + "The grid's name is " + grid.petrel_name)def stats_by_dir(gp, dir="k"): grid = gp.parent_grid if dir == "k": n = grid.extent.k elif dir == "i": n = grid.extent.i elif dir == "j": n = grid.extent.j else: raise ValueError(f"Unknown direction: {dir}") chunk = gp.all() arr = chunk.as_array() rows = [] for i in range(n): if dir == "k": v = arr[:, :, i].ravel() elif dir == "i": v = arr[i, :, :].ravel() elif dir == "j": v = arr[:, i, :].ravel() m = ~np.isnan(v) if m.any(): rows.append({ dir: i + 1, "Count": m.sum(), "Min": v[m].min(), "Mean": v[m].mean(), "Max": v[m].max(), "Std": v[m].std() }) return pd.DataFrame(rows)sibling_prop = vk.parent_collectionfor p in sibling_prop: df_layer = stats_by_dir(p) print (p.petrel_name) print (df_layer)
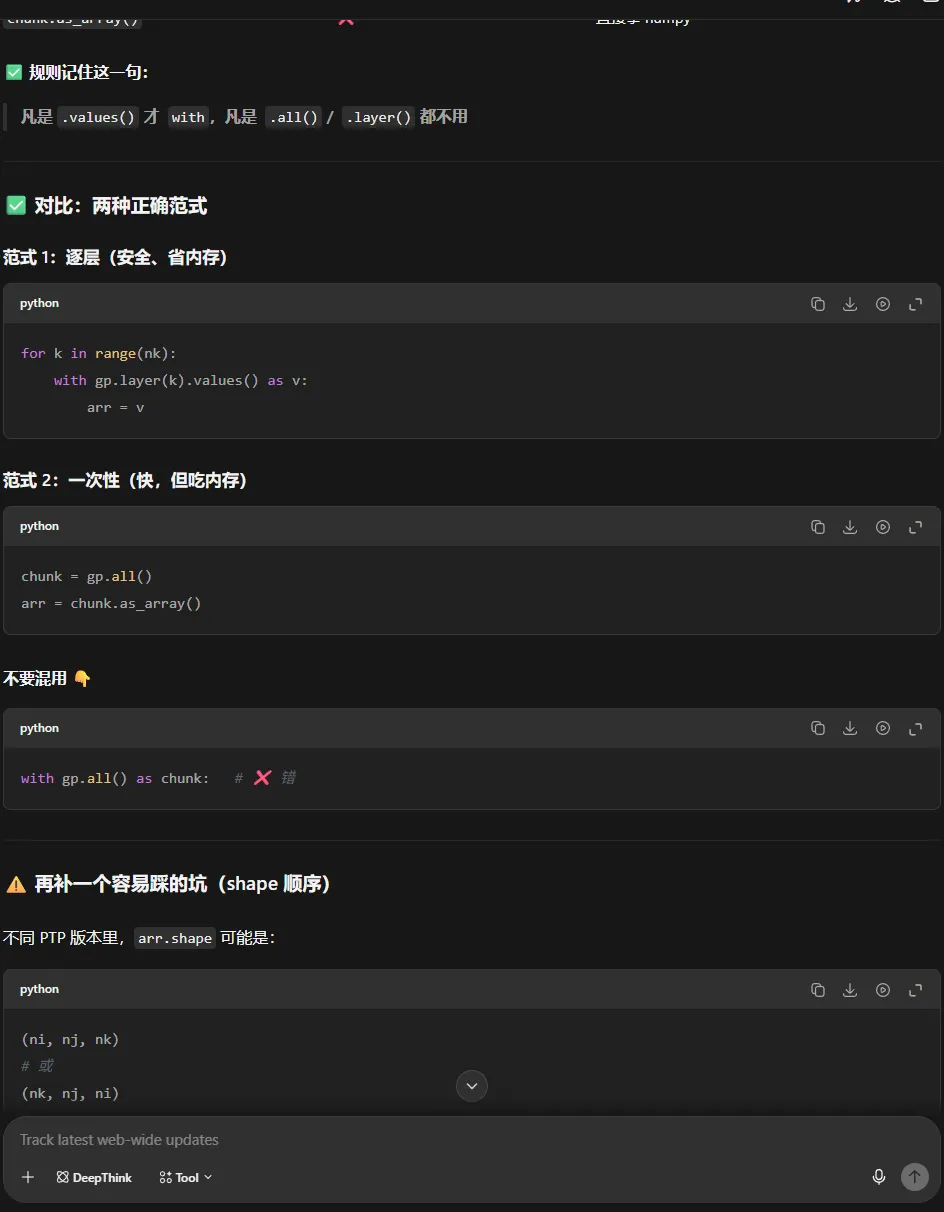
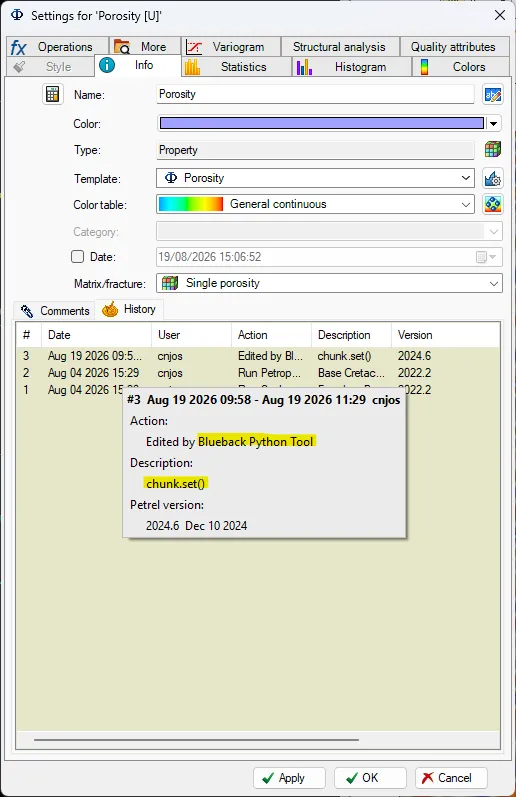
甚至还可以利用Python的csv输出直接写成我们需要的内容:跟Petrel的workflow比较起来,——虽然Python tool目前能够直接调用的objects不多,objects的对应attributes也比较少,——更大的优势还是在代码执行效率方面。在没有使用该插件之前,我感觉Calculator遍历I、J、K方向的操作也没有很惨,可能只是需要每处理一条线就临时生成一个temp属性而已。最初以为Python是脚本型语言,它的效率还要牵扯到Petrel自身的效率作叠加,肯定是很难有特别优异的成绩。但是,chunk机制的设置,和np、pd现成函数的调用都让我对这款小插件的效能刮目相看。目前我还没有ML或DL方向的能力,一下子也不会把学习牵扯到那么远。先知道如何形成循环,如何调用基础的统计函数,就已经非常开心。再加上试验过chunk.set()函数的写入,真的是一闪念之间就完成了全部操作。如果二十多年前,我们可以这样方便的调用LLM学习Petrel或者其它专业软件,我虽然可能更少概率入职Schlumberger,卻一定可以更快脱离软件去思考自己职业发展与人生规划。快乐何止加倍!
 10个月宝宝每天需要喝多少奶粉?