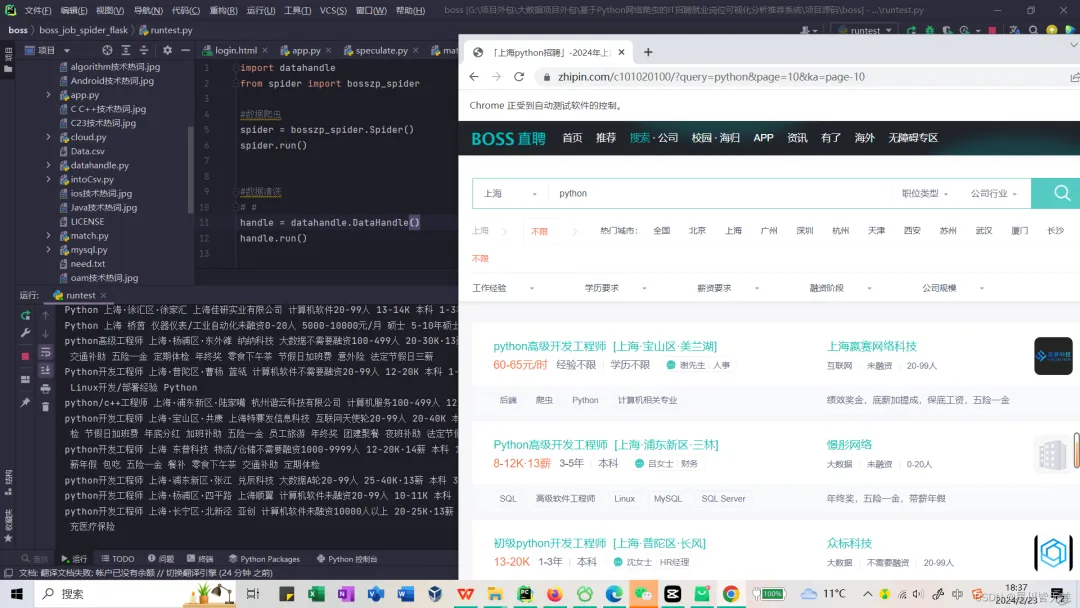
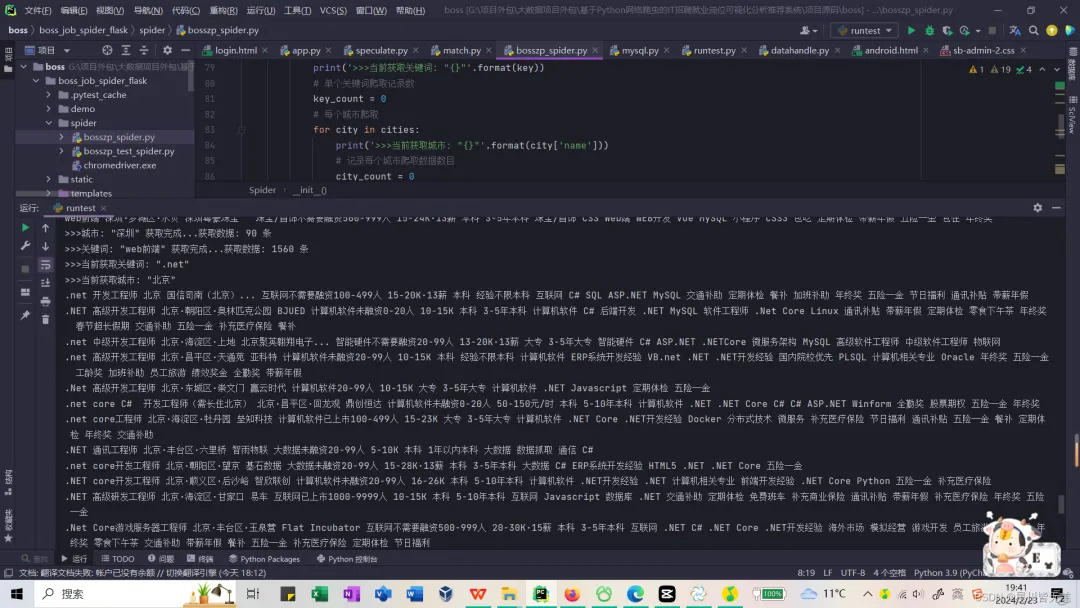
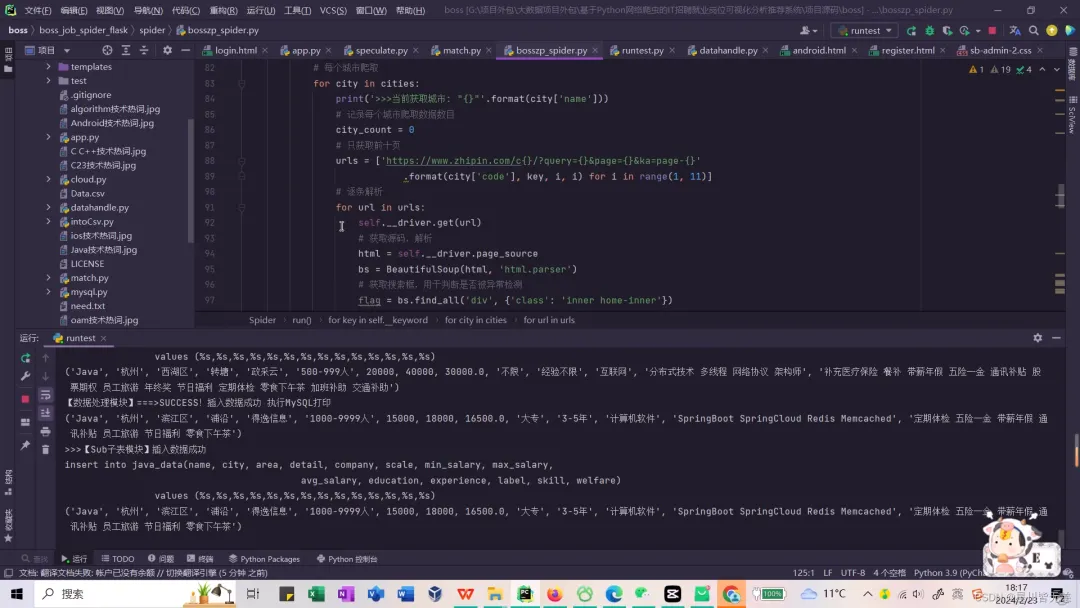
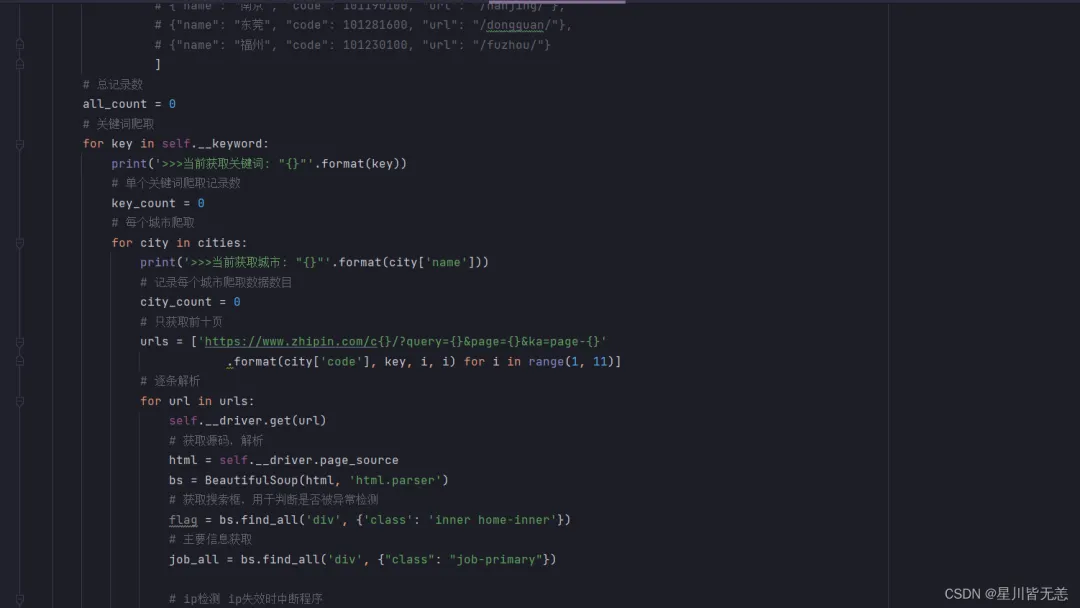
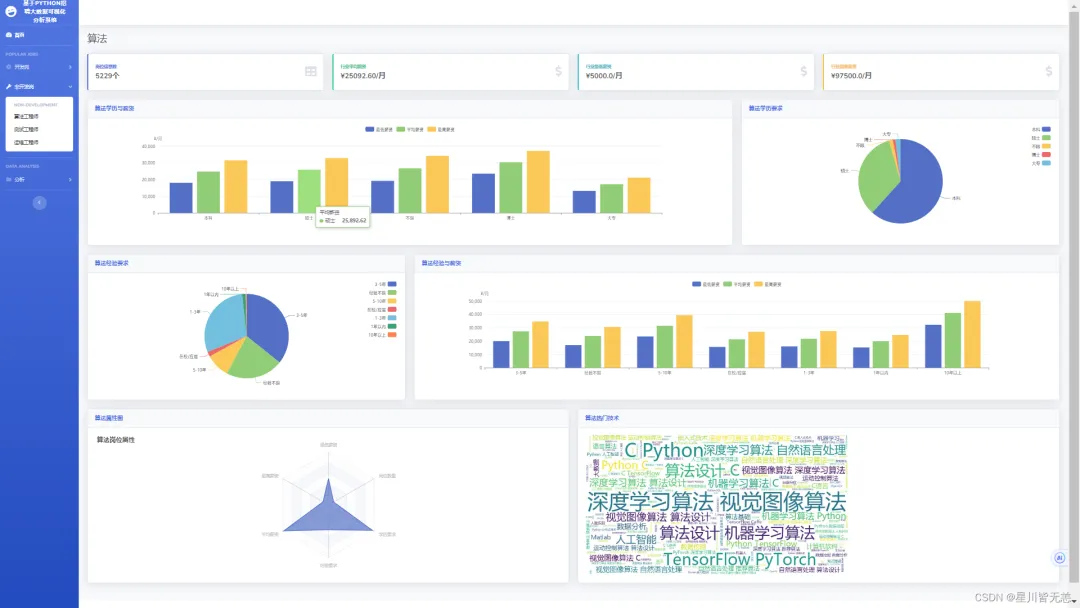
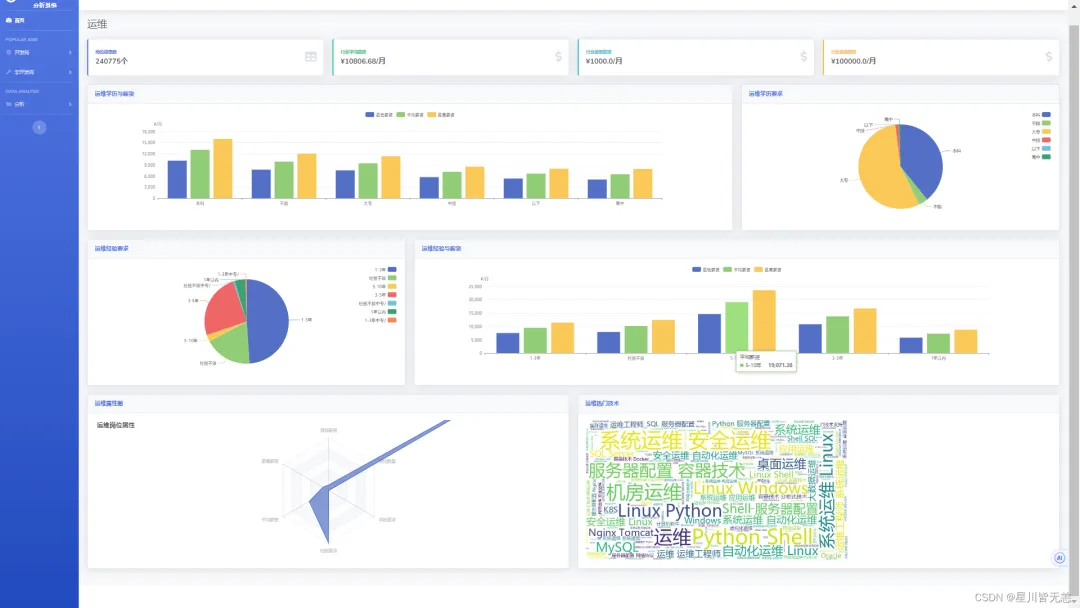
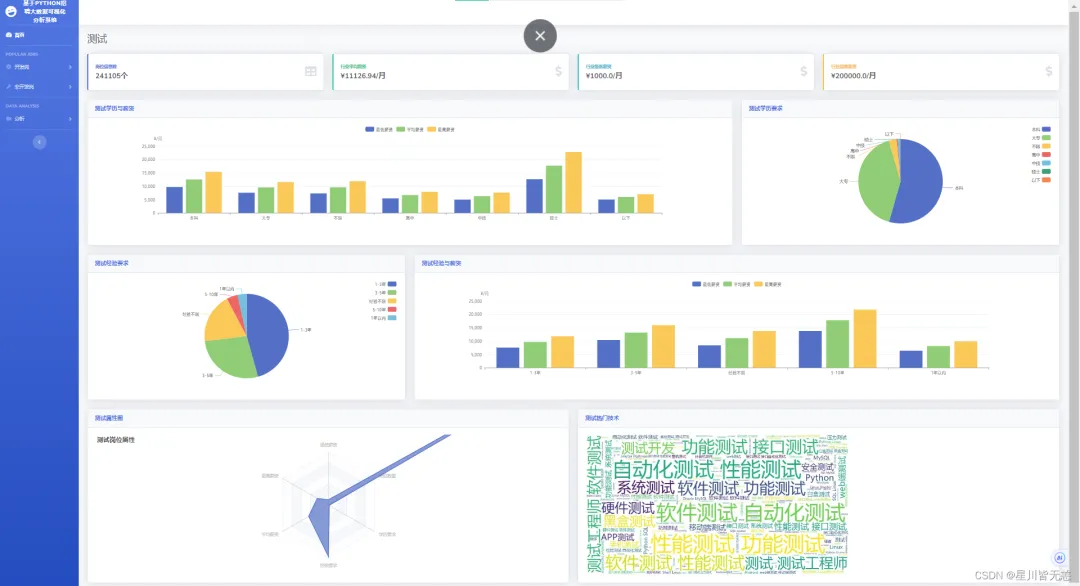
from selenium import webdriverfrom bs4 import BeautifulSoupimport mysqlclass Spider(object): def __init__(self): # 创建数据库对象 self.__sql = mysql.MySql() # 无头浏览器开启 self.__driver = webdriver.Chrome('spider/chromedriver.exe') # 隐式等待 self.__driver.implicitly_wait(20) # 设置需要爬取的 【关键词】 self.__keyword = ['c', 'java', 'python', 'web前端', '.net', 'u3d', 'c#', 'c++', '算法', 'ios', 'Android'] #self.__keyword = ['.net', 'u3d', 'c#', 'c++', '算法', 'ios', 'Android'] #self.__keyword = ['测试', '运维','算法', 'ios', 'Android'] # self.__keyword = ['python'] # self.__keyword = ['python', '算法', '测试'] # self.__keyword = ['Android'] def __del__(self): # 关闭无头浏览器,减少内存损耗 self.__driver.quit() # 设置爬取关键词 def setKeyword(self, keyword): self.__keyword = [] if isinstance(keyword, list): self.__keyword = keyword else: var = str(keyword) var.strip() if " " in var: keyword_list = var.split(' ') self.__keyword = keyword_list else: self.__keyword.append(var) # 获取所有关键词 def getKeyword(self): return self.__keyword # 爬虫方法 def run(self): print(">>>开始获取...") # 城市json # 在下方设置需要爬取的【城市】 cities = [{"name": "北京", "code": 101010100, "url": "/beijing/"}, {"name": "上海", "code": 101020100, "url": "/shanghai/"}, {"name": "广州", "code": 101280100, "url": "/guangzhou/"}, {"name": "深圳", "code": 101280600, "url": "/shenzhen/"}, # {"name": "杭州", "code": 101210100, "url": "/hangzhou/"}, # {"name": "天津", "code": 101030100, "url": "/tianjin/"}, # {"name": "西安", "code": 101110100, "url": "/xian/"}, # {"name": "苏州", "code": 101190400, "url": "/suzhou/"}, # {"name": "武汉", "code": 101200100, "url": "/wuhan/"}, # {"name": "厦门", "code": 101230200, "url": "/xiamen/"}, # {"name": "长沙", "code": 101250100, "url": "/changsha/"}, # {"name": "成都", "code": 101270100, "url": "/chengdu/"}, # {"name": "郑州", "code": 101180100, "url": "/zhengzhou/"}, # {"name": "重庆", "code": 101040100, "url": "/chongqing/"}, # {"name": "佛山", "code": 101280800, "url": "/foshan/"}, # {"name": "合肥", "code": 101220100, "url": "/hefei/"}, # {"name": "济南", "code": 101120100, "url": "/jinan/"}, # {"name": "青岛", "code": 101120200, "url": "/qingdao/"}, # {"name": "南京", "code": 101190100, "url": "/nanjing/"}, # {"name": "东莞", "code": 101281600, "url": "/dongguan/"}, # {"name": "福州", "code": 101230100, "url": "/fuzhou/"} .............................................. ] # 总记录数 all_count = 0 # 关键词爬取 for key in self.__keyword: print('>>>当前获取关键词: "{}"'.format(key)) # 单个关键词爬取记录数 key_count = 0 # 每个城市爬取 for city in cities: print('>>>当前获取城市: "{}"'.format(city['name'])) # 记录每个城市爬取数据数目 city_count = 0 # 只获取前十页 urls = ['https://www.zhipin.com/c{}/?query={}&page={}&ka=page-{}' .format(city['code'], key, i, i) for i in range(1, 11)] # 逐条解析 for url in urls: self.__driver.get(url) # 获取源码,解析 html = self.__driver.page_source bs = BeautifulSoup(html, 'html.parser') # 获取搜索框,用于判断是否被异常检测 flag = bs.find_all('div', {'class': 'inner home-inner'}) # 主要信息获取 job_all = bs.find_all('div', {"class": "job-primary"}) # 解析页面 for job in job_all: # 工作名称 job_name = job.find('span', {"class": "job-name"}).get_text() # 工作地点 job_place = job.find('span', {'class': "job-area"}).get_text() # 工作公司 job_company = job.find('div', {'class': 'company-text'}).find('h3', {'class': "name"}).get_text() # 公司规模 job_scale = job.find('div', {'class': 'company-text'}).find('p').get_text() # 工作薪资 job_salary = job.find('span', {'class': 'red'}).get_text() # 工作学历 job_education = job.find('div', {'class': 'job-limit'}).find('p').get_text()[-2:] # 工作经验 job_experience = job.find('div', {'class': 'job-limit'}).find('p').get_text() # 工作标签 job_label = job.find('a', {'class': 'false-link'}).get_text() # 技能要求 job_skill = job.find('div', {'class': 'tags'}).get_text().replace("\n", " ").strip() # 福利 job_welfare = job.find('div', {'class': 'info-desc'}).get_text().replace(",", " ").strip() #职位类型 追加 type=key # 数据存储 self.__sql.saveData(job_name, job_place, job_company, job_scale, job_salary, job_education, job_experience, job_label, job_skill, job_welfare,type) .......
 10个月宝宝每天需要喝多少奶粉?