Python爬取淘宝商品列表:绕过滑块验证,ChromiumPage精准提取标题/价格/销量
- 2026-09-09 12:13:26
Python爬取淘宝商品列表:绕过滑块验证,ChromiumPage精准提取标题/价格/销量做Python爬虫和电商竞品分析的朋友,对淘宝搜索页一定又爱又恨。 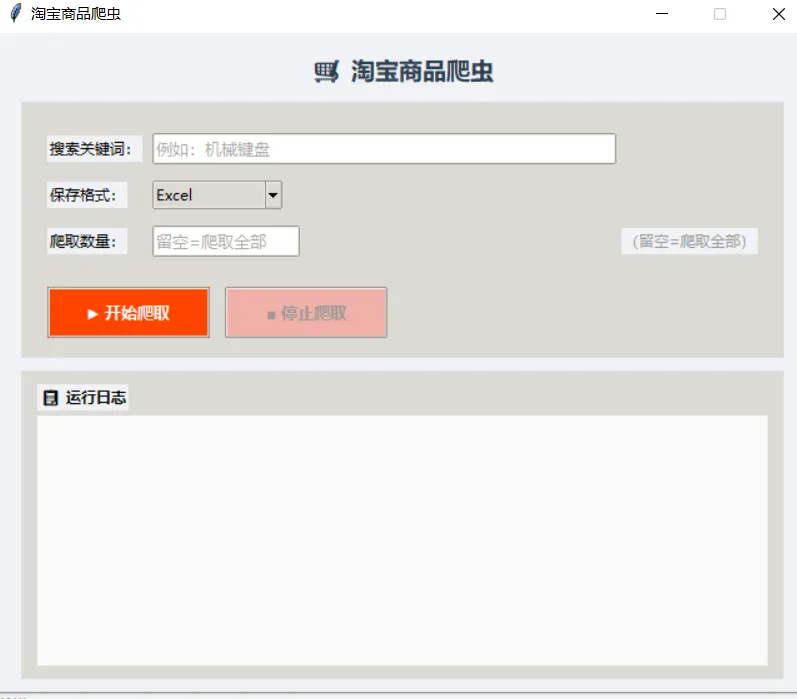
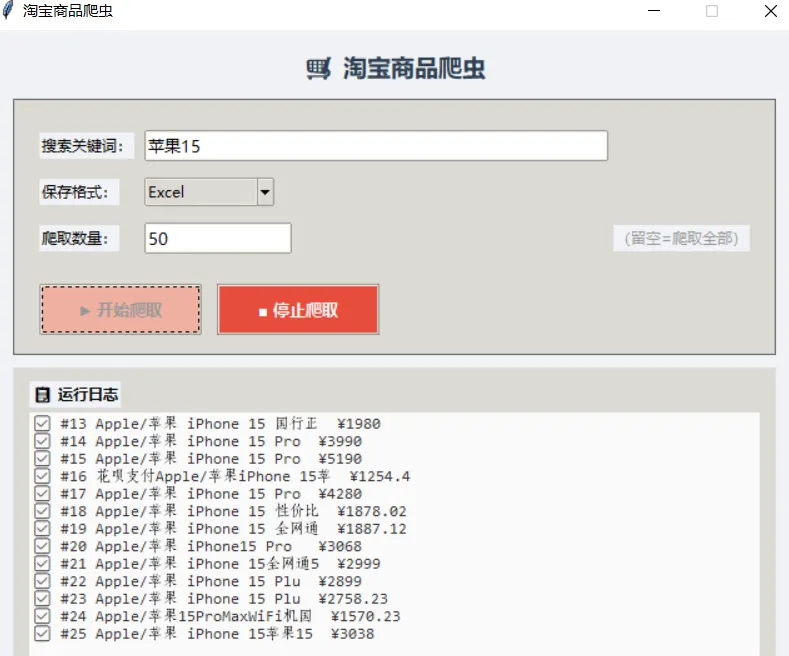
爱的是数据极全:标题、价格、销量、地区、店铺名、主图,几乎覆盖了一个商品的所有核心维度;恨的是反爬极严——不登录不给看、滑块验证码拦路、class 名动态混淆、翻页靠 JS 渲染。 绝大多数教程要么教你用接口逆向(需要解 sign 签名,门槛极高),要么教你用纯 requests(十有八九被 302 到登录页)。今天这篇,我走的是中间路线:用DrissionPage 启动真实 Chromium 浏览器,手动完成登录后,精准解析动态 class 的商品卡片 DOM,把数据稳定落盘。 核心架构思路全讲,但卡片解析的具体正则与 CSS 选择器逻辑、登录态 cookie 校验的完整封装,我只给设计思路,不贴关键代码——毕竟能稳定跑过滑块、不被 ban 的脚本,和跑一次就 403 的 Demo,完全是两个东西。
👉 一份 CSV,直接能做出“某关键词下价格-销量散点图”或“地区产业带热力图”。
✅为什么用手动登录? 淘宝滑块验证码目前没有稳定免费的自动过法 手动登录一次,cookie 有效数小时,够跑完一个关键词 检测 tracknick / cookie2 / unb 三个关键 cookie 判断登录态 ⚠️坑位: 不检测 cookie 直接跳搜索页 → 被踢回登录页 等待超时后不保存 debug 页面 → 出问题无法排查
✅关键点: 用 quote(KEY) 处理中文关键词(如"蓝牙耳机") 等待#content_items_wrapper 出现,而不是 time.sleep(10) 超时后保存 debug_page.html,方便排查是反爬还是选择器问题 ⚠️坑位: 不等待直接取卡片 → 拿到空列表 不保存 debug 页面 → 线上报错两眼一抹黑
✅设计思路(只讲不贴): 商品ID 优先从卡片 id="item_id_xxxx" 属性取,比从 URL 解析更稳 价格被拆成 priceInt(整数)+ priceDec(小数),需拼接 销量、地区、店铺名分别藏在不同层级的动态 class里 主图需排除 shopTag / shopIcon / p4p 等干扰节点 ⚠️坑位(只列不拆): class 名每次刷新都会变(如 doubleCardWrapper___abc123),必须用 *= 模糊匹配 主图有 data-src 懒加载,直接取 src 可能拿到占位图 卡片去重必须靠 item_id,不能用标题(标题会重复) 👉这部分是全文最核心的解析逻辑,我故意不展开——能自己写出来的人,才配跑通淘宝。
✅对抗要点: text=下一页 比 CSS 选择器更稳定(淘宝翻页按钮 class 也动态) 滚动到可见再点击,避免元素被遮挡 随机延迟 1.5~2.5 秒 ,模拟真人翻页节奏 每 10 条 f.flush() 刷磁盘,防止中途崩溃丢数据
竞品监控 :跟踪同类商品的价格变化和销量趋势 产业带分析 :按地区聚合,找出某品类的核心货源地 选品参考 :高销量 + 低竞争的关键词蓝海 视觉对标 :下载主图做竞品详情页分析
爬虫不难,难的是在淘宝这种"反爬天花板"面前,用最朴素的方式把数据啃下来。 这篇是《Python 商业数据源实战》的"电商竞品篇",也是目前系列里对抗反爬等级最高的一篇。 完整源码(含卡片解析全链路、主图兜底、登录态续期)在圈子里,后台回 淘宝 看入口。
Python爬取淘宝搜索页 · 核心架构拆解
技术栈:
DrissionPage + ChromiumPage手动登录 + 动态class DOM解析 + 翻页容错
一、为什么淘宝数据值得爬?
字段 | 竞品分析价值 |
|---|---|
商品ID / 标题 | 唯一标识 + 关键词覆盖分析 |
价格(整数+小数分离) | 价格带分布、促销力度 |
销量 | 爆款识别、转化基准 |
地区 | 产业带分布(义乌/广州/杭州) |
店铺名 | 自营 vs 分销 vs 品牌旗舰店 |
主图 | 视觉竞品对比 |
二、第 1 步:手动登录 + Cookie 检测(对抗滑块)
dp.get('https://www.taobao.com/')等待用户手动完成滑块/扫码登录for _ inrange(60): time.sleep(1) if any(c.get('name') in ('tracknick', 'cookie2', 'unb') for c in dp.cookies()): has_login = True; break
三、第 2 步:跳转搜索页 + 容器等待
search_url = f'https://s.taobao.com/search?q={quote(KEY)}'dp.get(search_url)dp.wait.ele_displayed('#content_items_wrapper', timeout=15)
四、第 3 步:卡片解析(关键逻辑不展开)
✅ 关键点:用quote(KEY) 处理中文关键词(如"蓝牙耳机")等待#content_items_wrapper 出现,而不是time.sleep(10)超时后保存debug_page.html,方便排查是反爬还是选择器问题⚠️ 坑位:不等待直接取卡片 → 拿到空列表不保存 debug 页面 → 线上报错两眼一抹黑四、第 3 步:卡片解析(关键逻辑不展开)
五、翻页:文本定位 + disabled 判断 + 随机延迟
nxt = dp.ele('text=下一页', timeout=3)if 'disabled' in (nxt.attr('class') or ''):breakdp.scroll.to_see(nxt)time.sleep(random.uniform(1.5, 2.5))nxt.click()
六、我故意不展开的三处(付费级)
卡片解析的完整 CSS 模糊匹配链 :[class*="priceInt"]、[class*="realSales"] 等动态 class 的 fallback 顺序 主图 URL 的懒加载兜底逻辑 :src → data-src → data-lazy-src 的优先级判断 登录态自动续期 :检测 302 到登录页时自动弹窗提醒用户重新扫码
七、这套数据能干什么?
八、结尾软广
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:596563534@qq.com 。
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- 赛博电报 | 苹果M3杀入Linux内核,豆包PC端颠覆AI办公,800亿网游代练黑幕大曝光
- 学编程总觉得枯燥?《Python计算与编程实践:多媒体方法》这本书用处理图片和音乐的方式,让我动了手
- python数据分析零基础入门必备的核心
- 【技术推荐】Linux文件权限(三):ACL 访问控制列表
- 网络安全入门必备:Linux 高频命令全套汇总
- 如果你能避开这5个坑,你的Python功底至少能超越市面上80%的初学者
- AI-Python前沿深度学习核心架构与科学计算实战——PINN正反问题求解、Transformer多领域建模、图神经网络时空推理、深度强化学习
- 夯爆了!字节跳动都在用的《Python知识手册》整理出来了!
- 开学领先全班!一份 Python 速查背诵手册送给新生
- 零基础也能上手!6步用Python爬虫抓取网页数据,直接导出Excel!