从一个真实的问题说起
你有没有过这样的经历:想学数据分析,结果买了本厚厚的 Python 教材,啃到第三章”面向对象编程”就放弃了?说实话,这事真不怪你。教材是给程序员写的,而你要做的是数据分析。两者的关系有点像:你想学会开车去上班,结果驾校非要先教你造发动机。这一篇,我们只挑数据分析里真正高频用到的语法来讲:变量与数据类型、列表、字典、for 循环、if 判断、函数。学完这一篇,你就能读懂后面 NumPy 和 Pandas 教程里 90% 的代码了。至于类、装饰器、生成器这些,等真正需要时再补也不迟。打开你的 Jupyter Notebook,我们边敲边学。一、变量与数据类型:给数据贴个标签
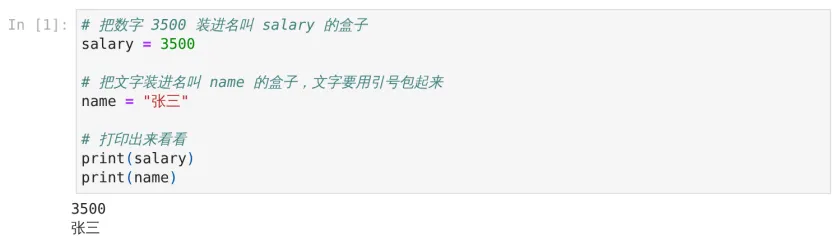
#把数字3500装进名叫salary的盒子salary=3500#把文字装进名叫name的盒子,文字要用引号包起来name="张三"#打印出来看看print(salary)print(name)
在 Jupyter Notebook 里运行这段代码,结果如下:- 小数(float):比如单价 9.9、转化率 0.032
- 字符串(str):带引号的文字,比如城市名“北京”
- 布尔值(bool):只有两个取值 True 和 False,后面做筛选时天天见
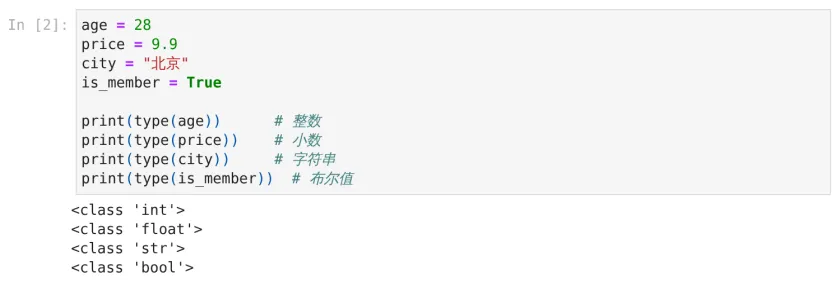
age=28price=9.9city="北京"is_member=Trueprint(type(age))#整数print(type(price))#小数print(type(city))#字符串print(type(is_member))#布尔值
在 Jupyter Notebook 里运行这段代码,结果如下:数据分析里什么时候用到?读进来的销售数据里,“销量”列应该是数字,结果混进了文字”缺货”,这时你就得检查类型、做转换。类型不对,计算直接报错,这是新手最常踩的坑。二、列表:一列数据的雏形
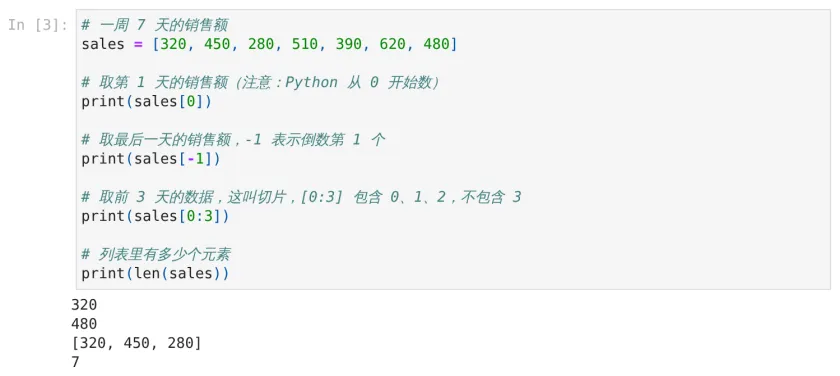
列表就是一串按顺序排好的数据,用方括号[]包起来,元素之间用逗号隔开。#一周7天的销售额sales=[320,450,280,510,390,620,480]#取第1天的销售额(注意:Python从0开始数)print(sales[0])#取最后一天的销售额,-1表示倒数第1个print(sales[-1])#取前3天的数据,这叫切片,[0:3]包含0、1、2,不包含3print(sales[0:3])#列表里有多少个元素print(len(sales))
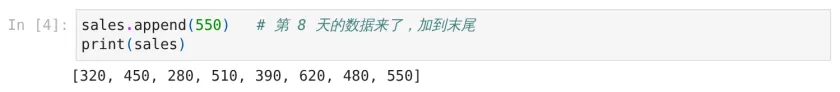
在 Jupyter Notebook 里运行这段代码,结果如下:sales.append(550)#第8天的数据来了,加到末尾print(sales)
数据分析里什么时候用到?列表是最基础的数据容器。以后你会发现,Pandas 里选多列时写 df[["姓名", "工资"]],这个方括号里装的就是一个列表。理解了列表,你就理解了后面一半的语法。三、字典:带名字的表格行
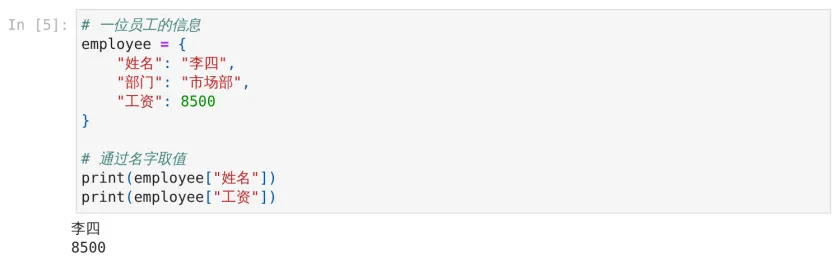
列表里的数据靠位置找,字典里的数据靠名字找。字典用大括号{},每一项是”键: 值”的组合。#一位员工的信息employee={"姓名":"李四","部门":"市场部","工资":8500}#通过名字取值print(employee["姓名"])print(employee["工资"])
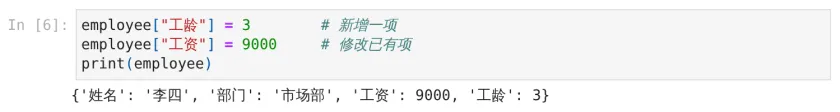
在 Jupyter Notebook 里运行这段代码,结果如下:employee["工龄"]=3 #新增一项employee["工资"]=9000 #修改已有项print(employee)
在 Jupyter Notebook 里运行这段代码,结果如下:数据分析里什么时候用到?用字典创建 DataFrame 是 Pandas 里最常见的操作之一:pd.DataFrame({"姓名": [...], "工资": [...]})。到时候你会觉得无比眼熟。四、for 循环:重复的事情交给它
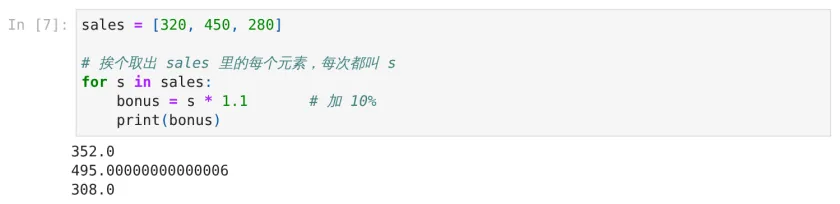
假设你要给每个销售额加上 10% 的奖金,7 个数字挨个算,手写太蠢了。for 循环就是干这个的:sales=[320,450,280]#挨个取出sales里的每个元素,每次都叫sfor s in sales: bonus=s*1.1 # 加10%print(bonus)
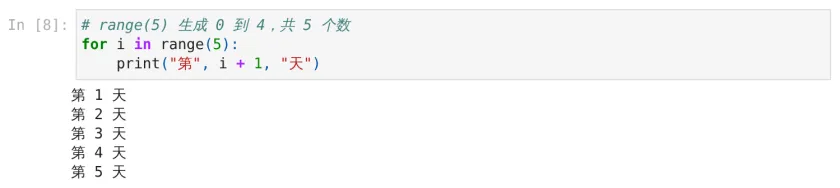
在 Jupyter Notebook 里运行这段代码,结果如下:(第二个数字出现一长串小数,是计算机存储小数的正常误差,不影响理解。)注意两个细节:for那一行末尾有冒号,下面要执行的代码必须缩进 4 个空格(Jupyter 里按 Tab 就行)。缩进是 Python 的语法规则,写错了会直接报错。#range(5)生成0到4,共5个数for i in range(5): print("第", i+1,"天")
在 Jupyter Notebook 里运行这段代码,结果如下:数据分析里什么时候用到?批量处理文件、批量清洗多列数据时会用到。不过先剧透一下:学了 NumPy 之后你会发现,很多循环其实可以被更快的写法替代,但理解循环是理解一切的基础。五、if 判断:让代码学会分情况
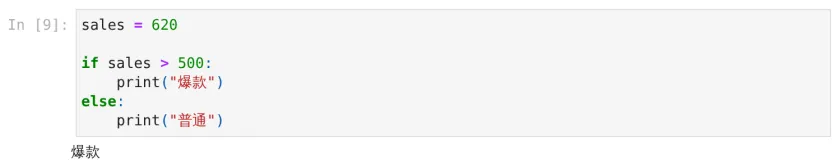
数据分析里经常要”分类”:销售额超过 500 的标记为”爆款”,否则标记为”普通”。if 判断就是干这个的:sales = 620if sales > 500: print("爆款")else: print("普通")
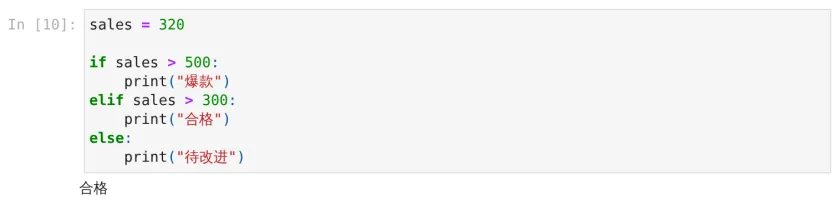
在 Jupyter Notebook 里运行这段代码,结果如下:sales = 320if sales > 500: print("爆款")elif sales > 300: print("合格")else: print("待改进")
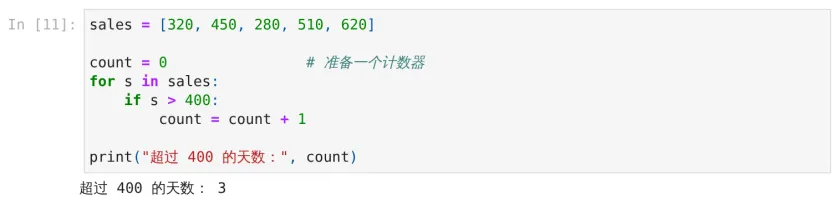
在 Jupyter Notebook 里运行这段代码,结果如下:sales = [320, 450, 280, 510, 620]count = 0 #准备一个计数器for s in sales: if s > 400: count = count + 1print("超过400的天数:", count)
在 Jupyter Notebook 里运行这段代码,结果如下:数据分析里什么时候用到?这段代码其实就是 Pandas 里”布尔筛选 + 计数”的朴素版本。以后你写 df[df["销量"] > 400].shape[0]一行就能搞定,但背后的逻辑一模一样。六、函数:把常用的步骤打包
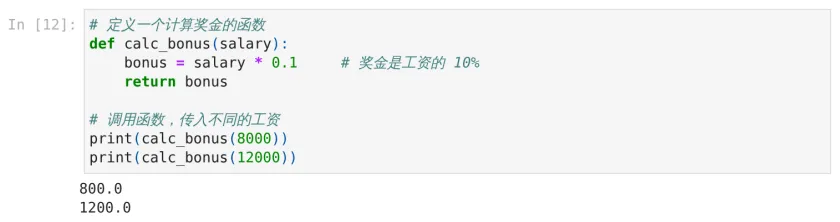
函数就是把一段代码打包,起个名字,以后随叫随到。用def定义,用return返回结果:#定义一个计算奖金的函数def calc_bonus(salary): bonus = salary * 0.1 #奖金是工资的10% return bonus#调用函数,传入不同的工资print (calc_bonus(8000))print (calc_bonus(12000))
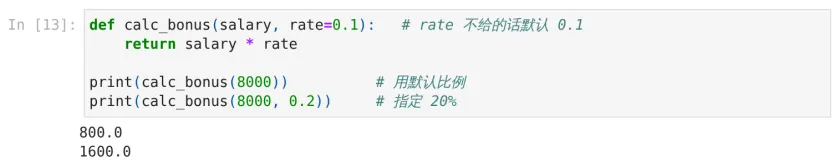
在 Jupyter Notebook 里运行这段代码,结果如下:def calc_bonus(salary, rate=0.1): #rate不给的话默认0.1 return salary * rateprint(calc_bonus(8000)) #用默认比例print(calc_bonus(8000,0.2)) #指定20%
在 Jupyter Notebook 里运行这段代码,结果如下:数据分析里什么时候用到?你其实已经在用函数了:print()、len()、type()都是函数。以后 Pandas 里的 df.head()、df.groupby()本质上也一样,都是”传入数据,返回结果”。学着自己写函数,是为了看懂报错信息、也为了把重复的清洗步骤封装起来复用。本篇小结
语法 | 一句话理解 | 数据分析里的用途 |
变量与数据类型 | 给数据贴标签 | 检查列类型、做类型转换 |
列表 | 一串有顺序的数据 | 选多列、存一组数据 |
字典 | 靠名字找数据 | 创建 DataFrame |
for 循环 | 重复执行 | 批量处理 |
if 判断 | 分情况处理 | 数据分类、打标签 |
函数 | 把步骤打包 | 复用清洗逻辑 |
这些就够了吗?对入门阶段来说,真的够了。数据分析的主力工具是 NumPy 和 Pandas,它们把绝大部分底层操作都封装好了,你的任务是理解逻辑、调对方法,而不是手写复杂算法。小练习
某店铺 5 天的营业额分别是:1200、860、1500、980、2100 元。请写代码完成:- 用 for 循环和 if 判断,统计营业额超过 1000 元的有几天;
- 写一个函数judge(amount),营业额超过 1000 返回 “达标”,否则返回 “未达标”,并对第 1 天调用一次。
下一篇预告
下一篇我们正式进入数据分析的第一个核心工具:《NumPy 入门:为什么数据分析离不开数组》。你会看到一个有趣的现象:同样计算 100 万个数字的平均值,用 Python 循环和用 NumPy 数组,速度能差出几十倍。这背后的原因,就是 NumPy 存在的意义。觉得有用的话,欢迎关注我的公众号,系列教程会持续更新,下一篇 NumPy 不见不散!