大家好,我是大禾。
每天进步一点点
今天介绍RCU锁。
在Linux内核的并发编程世界里,读写锁(RW Lock)曾是保护共享数据的“主力军”。但随着多核CPU的普及,一个令人头疼的问题浮出水面:当“读”远多于“写”时,读写锁本身的维护开销(缓存抖动、原子操作)成了性能瓶颈。
怎么办?内核开发者祭出了一把“屠龙刀”——RCU(Read-Copy-Update,读-拷贝-更新)。
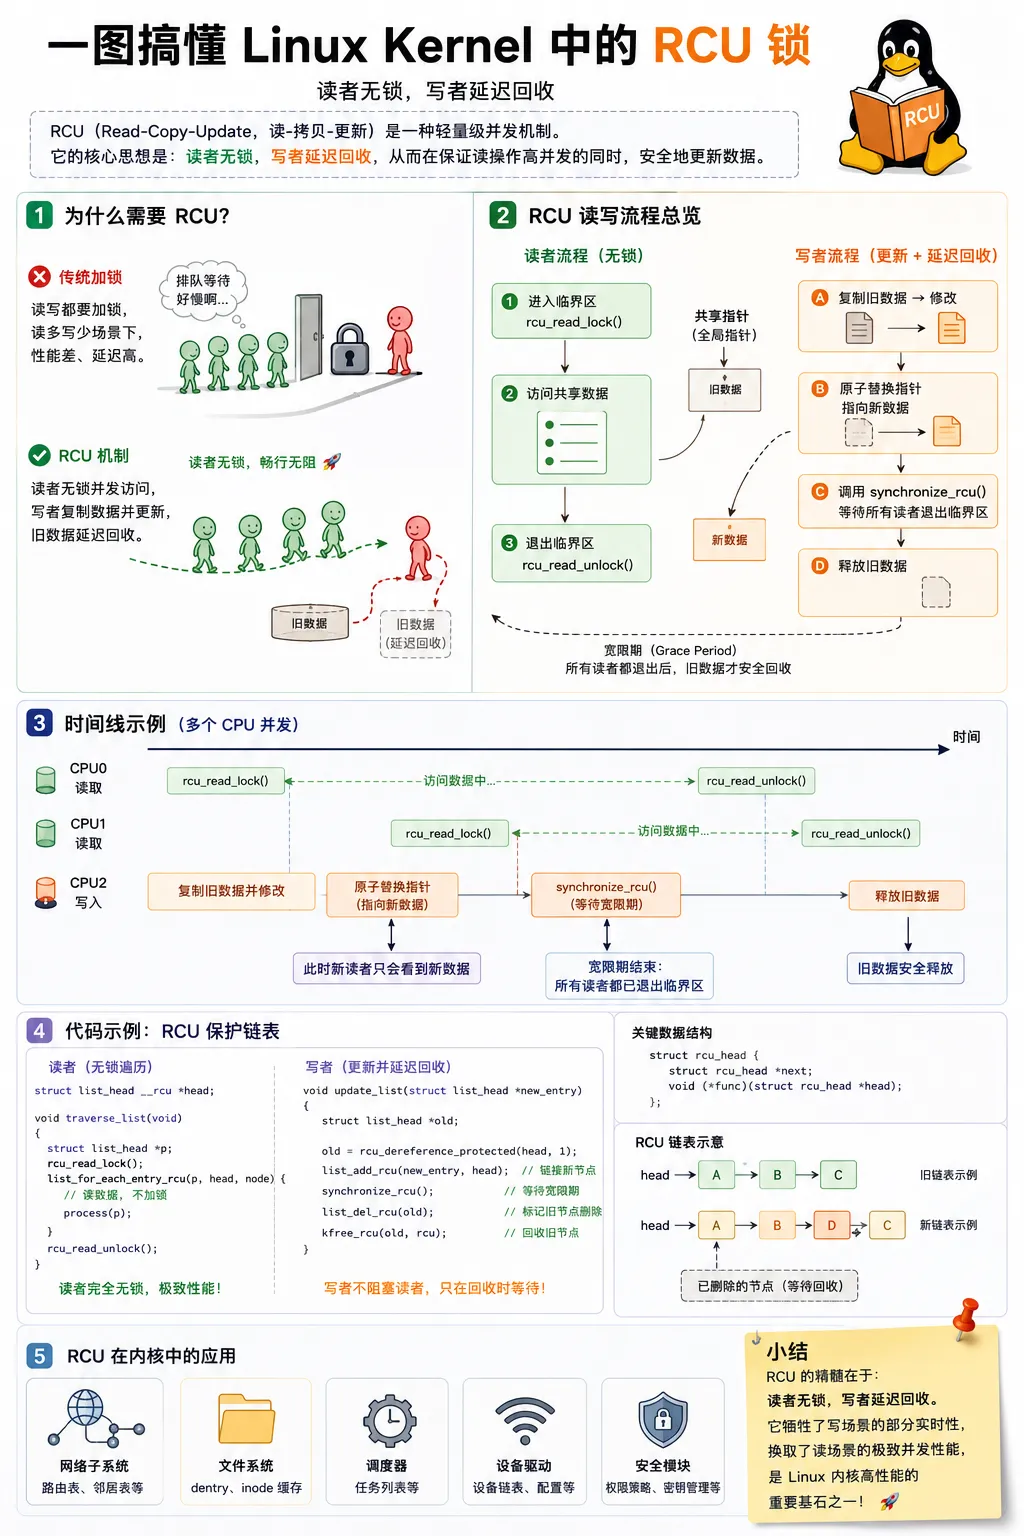
今天,我们就用一张思维导图的脉络,带你一图搞懂RCU的核心精髓。
一、为什么需要RCU?传统锁的痛点
想象一下图书馆的登记册(共享数据):
RCU的革命性在于:让读者(Reader)彻底摆脱锁的束缚,畅行无阻;而写者(Writer)则悄悄复制修改,等没人用了再销毁旧数据。
二、RCU核心思想:读者无锁,写者“借尸还魂”
RCU的精髓可以总结为两个字:等待。
它不是通过锁来阻止并发,而是通过等待所有正在进行的读操作完成,来安全地回收旧数据。
三、时间线图解:多CPU并发下的“时空交错”
假设有三个CPU同时在干活:
时间线推演:
写入时刻:CPU2 复制旧数据 -> 修改完成 -> 原子替换全局指针。
关键分水岭:
静默期(Grace Period):CPU2 调用 synchronize_rcu() 进入休眠。内核会监测 CPU0 和 CPU1 是否退出了读临界区。
回收时刻:当 CPU0 和 CPU1 都执行完 rcu_read_unlock() 后,内核唤醒 CPU2。此时,CPU2 知道全世界已经没有人在看旧数据了,于是放心地释放(free)旧内存。
四、代码实战:RCU保护链表操作
理论说再多,不如看代码。以下是RCU保护链表的典型写法:
1. 读者(无锁畅游)
struct list_head __rcu *head;void traverse_list(void){ struct list_head *p; // 1. 标记进入RCU读临界区(仅仅是禁止抢占,不是加锁) rcu_read_lock(); // 2. 遍历链表,注意使用 _rcu 版本的遍历宏 // 这里面不会加任何锁,并发读性能极高 list_for_each_entry_rcu(p, head, node) { process(p); // 读取数据 } // 3. 退出临界区 rcu_read_unlock();}
2. 写者(更新 + 延迟回收)
voidupdate_list(struct list_head *new_entry){ struct list_head *old; // 1. 获取旧的链表头(受保护的数据) old = rcu_dereference_protected(head, 1); // 2. 原子地添加新节点到链表头部(更新指针) list_add_rcu(new_entry, head); // 3. 等待所有的读者离开临界区(阻塞等待) // 这是RCU最核心的“延迟”所在 synchronize_rcu(); // 4. 静默期已过,安全地删除并回收旧节点 list_del_rcu(old); // kfree_rcu 是 synchronize_rcu + kfree 的异步合并版本 kfree_rcu(old, rcu); }
五、关键数据结构:rcu_head 无处不在
你可能注意到了代码里的 kfree_rcu(old, rcu)。它之所以能延迟回收,是因为数据结构里内嵌了一个struct rcu_head。
struct rcu_head { struct rcu_head *next; void (*func)(struct rcu_head *head);};
当你调用
六、RCU链表示意图(脑补画面)
想象一条双向链表(A <-> B <-> C):
Head 指向节点 A。
写者要删除节点 B:
把 B 的 next 和 prev 指针断开,绕过 B,将 A 和 C 连起来(Update)。
调用 synchronize_rcu()。
此时,B 依然存在于内存中,物理上并未被释放。如果有读者正在遍历,它依然能通过 B 的指针走下去(因为断开指针是原子的,读者要么看到旧的 B,要么看到新的 C,绝不会看到中间态)。
等所有读者离开,B 才被加入“垃圾回收”队列。
七、小结:RCU 的取舍与辉煌
RCU 并非银弹,它是一种取舍的智慧:
正是这种“读者无锁,写者延迟”的设计哲学,让 RCU 成为 Linux 内核中 路由表查找、文件系统目录缓存、进程管理 等高频读场景的基石。
一句话总结:RCU 让读者跑得像脱缰的野马,让写者学会在寂静中等待,最终在无人察觉时完成新老交替。
参考:本文参考自 Linux 内核源码 Documentaion/RCU 及 Paul E. McKenney 经典著作。
 10个月宝宝每天需要喝多少奶粉?