用 Pandas 做数据分析的人,多半都撞过同一堵墙:一个几 GB 的 CSV,read_csv 一跑,内存条先飙满;或者好容易读进来,一个 groupby 单线程磨上两三分钟。Pandas 要把整个文件读进内存、默认单线程算,数据量一上去这两块短板同时暴露。
DuckDB 的解法很轻:一条命令装完,import 即用,而且你熟悉的 DataFrame 照样能接着干活。
pip install duckdb
再看同一个分组统计任务。这是素材里的一组社区实战经验值,不是官方基准:5GB 的 CSV,Pandas 常 OOM 或要 3 分钟左右;DuckDB 用流式 + 列式 + 多线程跑,同任务大约 8 秒,快了一个量级。
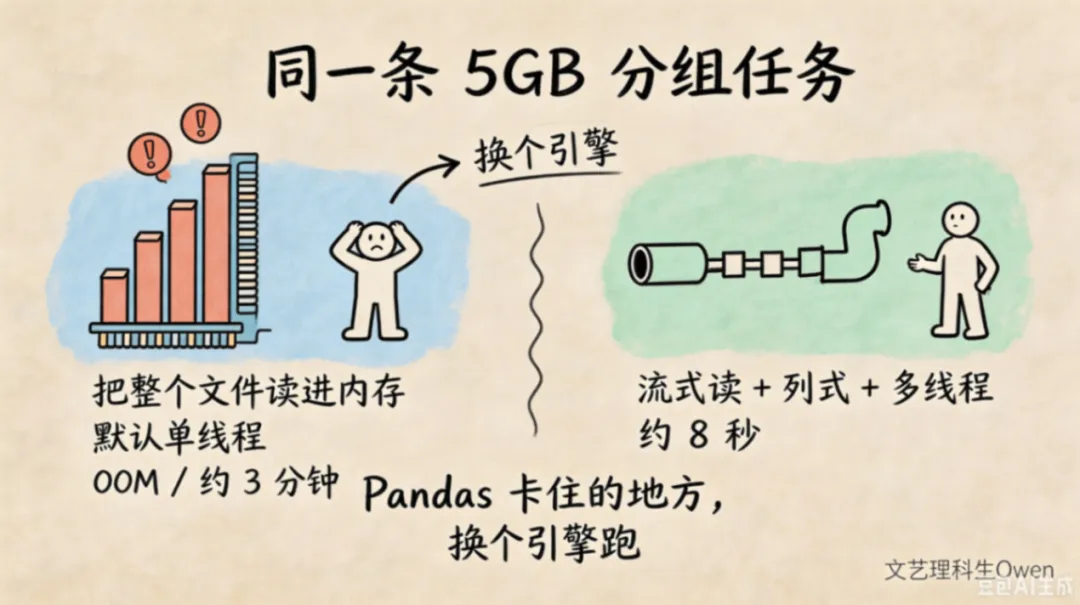 Pandas 与 DuckDB 处理同一条 5GB 分组任务
装完怎么连:三种打开方式
下面三行是三种彼此独立的打开方式,区别只在"库存在哪、数据活多久"。
| | | |
|---|
duckdb.sql("...") | | | |
duckdb.connect() | | | |
duckdb.connect("file.db") | | 保留 | |
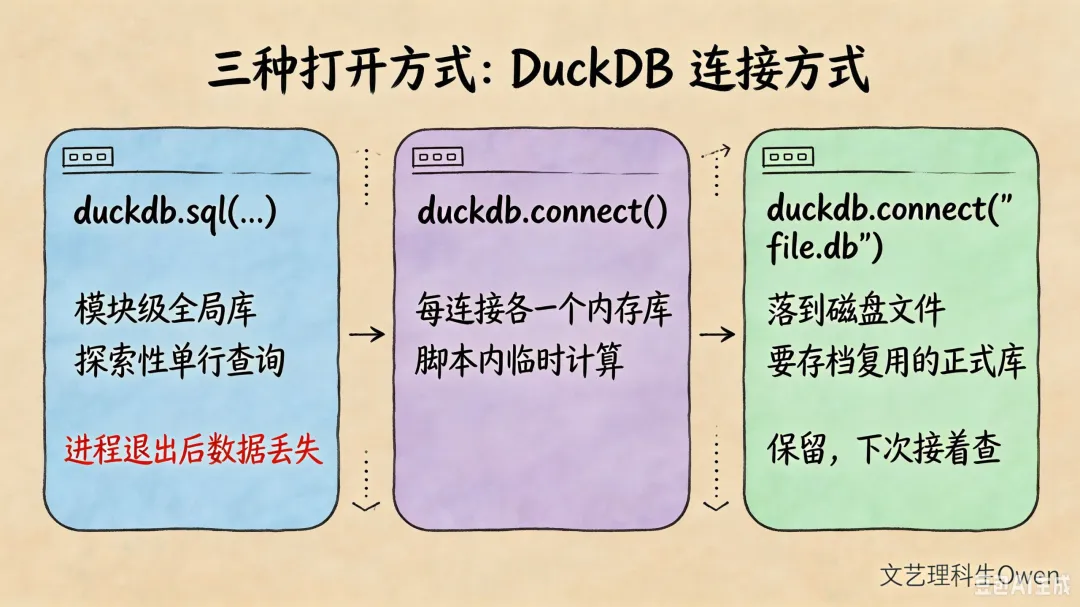 三种打开方式的差异对照:duckdb.sql(全局内存库/探索性查询/退出数据丢失)、duckdb.connect()(每连接一个内存库/临时计算/退出数据丢失)、duckdb.connect("file.db")(落盘文件/存档复用/退出保留)
方式一:duckdb.sql(...)——模块级全局内存库,随手跑单行查询
不开显式连接,直接拿模块名调用。它背后是 DuckDB 隐式维护的一个"全局内存库",适合写探索性的单行 SQL,跑完即弃:
import duckdbprint(duckdb.sql("SELECT 42").fetchall()) # [(42,)]:SQL 有结果,但要 fetchall() 才看得见
注意:整段脚本共用的是同一个隐式全局库,且这个全局连接非线程安全,多线程并发时不要共用它。
方式二:duckdb.connect()——每次新建一个独立的内存连接
每次调用返回一个全新的内存库,各连各的、互不干扰,适合在同一脚本里临时开算、算完即弃:
import duckdbcon = duckdb.connect() # 新建一个独立的内存连接con.execute("CREATE TABLE t (id INT, name VARCHAR)")con.execute("INSERT INTO t VALUES (1, 'Alice'), (2, 'Bob')")print(con.execute("SELECT * FROM t").fetchall()) # [(1, 'Alice'), (2, 'Bob')]con.close() # 进程退出,数据随之消失
方式三:duckdb.connect("file.db")——落盘到文件,进程退出后数据还在
比方式二多写一个文件名,库就落到磁盘文件上,进程退出、下次用同一路径重连,数据仍在。要长时间复用的库用这个:
import duckdbcon = duckdb.connect("my_data.db") # 在磁盘创建/打开一个持久化库文件con.execute("CREATE TABLE t (id INT, name VARCHAR)")con.execute("INSERT INTO t VALUES (3, 'Carol')")con.close() # 数据写入 my_data.db# 换个进程连同一个路径,表还在con2 = duckdb.connect("my_data.db")print(con2.execute("SELECT * FROM t").fetchall()) # [(3, 'Carol')]
提醒:connect("file.db") 的路径(相对当前工作目录)直接决定了库的身份——同目录下同名就是同一个库;换目录写脚本时建议用绝对路径,免得在错误位置生出一个同名空库。
想一次装齐 Parquet、Arrow 等加速项,用 pip install 'duckdb[all]';主战场在终端的话,还有命令行客户端 pip install duckdb-cli,装完敲 duckdb 进交互式命令行,和 Python 库不冲突。本文聚焦 Python,这几个先点到为止。
这个点后面踩线程的坑都跟它有关:DuckDB 是嵌入式 in-process 数据库。它把数据库引擎编译成了一个可以直接 import 的库,跑在你自己的进程里。
对比 MySQL、PostgreSQL——那些得先起一个常驻的数据库服务、再通过端口去连。嵌入式意味着没有连接串、没有端口、没有"先启动服务再干活"这一步,import 完就能开跑。
它的定位是列式存储的 OLAP(分析型)数据库:擅长"读一大堆、算聚合",不擅长高频的逐条增删改。所以它是来补 Pandas 短板的,你的业务主库不用动。
把 DataFrame 和文件,直接当表查
装完之后最好用的一点:你不必把 Python 数据"导入"数据库,它直接就能查。
最省事的写法,是让 DuckDB 直接看到同作用域里的 DataFrame 变量:
import duckdb, pandas as pddf = pd.DataFrame({'a': [42]})duckdb.sql("SELECT * FROM df WHERE a > 1").df()
这里的 df 就是上面那个 Pandas DataFrame,SQL 里直接用它的变量名当表名。想要个固定名字、重复使用,用 register() 把它注册成命名视图:
con.register("sales", df) # 之后 SQL 里写 FROM sales
手上是 Arrow 表而不是 Pandas,也有对应入口:from_df(df) 和 from_arrow(tbl) 都能生成一个 Relation(关系对象,惰性求值)。这几条路都是零拷贝——靠 Apache Arrow 这块共享的内存列式格式,DuckDB 和 Pandas / Polars / NumPy 都认它,两头读的是同一块内存,大数据量来回转换时不多占一份副本。
更实在的入口在文件这边:CSV、Parquet、JSON 不用先 import,直接当表查,类型自动推断:
SELECT * FROM 'sales.csv' LIMIT 10;SELECT * FROM 'data.parquet' WHERE date > '2026-01-01';SELECT * FROM read_json_auto('events.jsonl');
还能往上叠:'logs/*.csv' 通配符批量读、'test.csv.gz' 直接读压缩文件、read_parquet('s3://...') 读对象存储上的远程文件(httpfs 扩展用到时自动加载)。多文件查询时加一个虚拟列 filename,还能顺手标出每行来自哪个文件。
SQL 本身也省事:SELECT category, SUM(amount) FROM sales GROUP BY ALL 里的 GROUP BY ALL 会自动把所有非聚合列当分组键,不用一个个列名抄上去。
把结果拿回来,一步到位
查询结果不用手动解析成表结构,一个方法调用就回到你熟悉的对象:
r = duckdb.sql("SELECT 42")r.fetchall() # Python 元组列表r.df() # Pandas DataFramer.pl() # Polars DataFrame(需已装 pyarrow)r.arrow() # Arrow Tabler.fetchnumpy() # NumPy 数组
不想依赖 Pandas 的话,还有 r.to_arrow_table().to_pylist(),把 Arrow 表转成 dict 列表(每行一个 dict、键是列名),拿去喂 JSON 接口或存文档库都顺手。说到转换,多数路径直接走 Arrow、免去反复解析,但别默认全部零拷贝——.pl() 转 Polars 要先经 pyarrow 中间层,装好 pyarrow 才可用。
duckdb.sql(...) / con.sql(...) 返回的是 Relation 对象,惰性求值、可以继续链式往下写;con.execute(...) 执行后立即返回结果对象,上面这些 .df()、.fetchall() 取值方法都挂在它身上。日常探索用前者,需要立即执行并取回结果时用后者,差别不大,别混在一起。
所以 DuckDB 和 Pandas / Polars 是分工关系:DuckDB 负责扫描、Join、聚合这些重活,结果转回 DataFrame 做最后的打磨和可视化,多数 "Pandas OOM" 问题能从这条路绕开(这也是素材里的社区经验值)。另说一句,它不只有 Python 客户端,Node.js、Rust、Go、Java、WebAssembly 都是官方支持,前端想在 Node 环境里跑也没有门槛。
写回和持久化:算完得留下东西
一次性算完就丢的场景不多,多数时候算出的表要落库复用。用 create("表名") 把一个查询结果持久化成库里的一张命名表:
duckdb.sql("SELECT * FROM 'sales.csv'").create("sales")
往已有表里追加新数据用 append(),并显式传 by_name=True:
con.append("sales", new_df, by_name=True)
默认 append 按列位置匹配,列顺序一旦和表不一致就容易触发类型转换报错;按列名匹配(by_name=True)更稳,直接养成习惯。
导出到文件也简单,但注意挂载点:write_parquet()、write_csv() 是 Relation 对象的方法(duckdb.sql(...) / con.sql(...) 的返回值),con.execute() 返回的结果对象上没有这俩。写法一行搞定:
r = duckdb.sql("SELECT * FROM 'logs/*.csv'")r.write_parquet("out.parquet")r.write_csv("out.csv")
要更细的控制(格式、压缩),用 COPY ... TO:
COPY (SELECT * FROM 'logs/*.csv') TO 'all_logs.parquet' (FORMAT PARQUET, COMPRESSION ZSTD);
这是典型的"多 CSV 合并成一个压缩 Parquet",压缩和查询提速一次拿到。
参数化、线程数,和两个会踩的坑
写进程序(而不是交互式跑),查询条件通常来自变量。别手拼 SQL 字符串,用 ? 占位符 + 参数列表,防注入:
con.execute("SELECT count(*) FROM t WHERE a = ?", [True])
想控制并行度,连接时可以配 threads:
con = duckdb.connect(config={'threads': 1})
两个线程相关的坑,根源都在"全局库"设计:
- •
duckdb.sql() 调用的是模块级全局连接,非线程安全——多线程并发时不要共用它,每个线程各自 duckdb.connect() 拿独立连接。 - •
cursor() 只是同一连接上的另一个句柄,并不能让同一个连接并行跑查询。
写库或写包给别人用时,建议一律用连接对象 con,而不是模块级的 duckdb.sql。
一个完整实战:换掉那个三分钟的重活
把前面的东西串起来,看一个真实任务。素材里的"模式 1"是典型的中等数据聚合:
duckdb.sql(""" SELECT category, COUNT(*) AS n, AVG(price) AS avg_price FROM 'sales-2026.csv' WHERE region = 'APAC' AND date >= '2026-01-01' GROUP BY category ORDER BY n DESC""").df()
同一条任务、同一组社区实战经验值:Pandas 读满内存、单线程,5GB CSV 常 OOM 或约 3 分钟;DuckDB 流式 + 列式 + 多线程,约 8 秒。代码量反而更少。
再补一个轻量 ETL,把对象存储上的原始 JSONL 沉淀成压缩 Parquet("模式 2"):
con = duckdb.connect()con.sql("INSTALL httpfs; LOAD httpfs;")con.sql(""" COPY ( SELECT CAST(ts AS DATE) AS event_date, user_id, event_type, amount FROM 's3://raw-bucket/events/2026-06-11/*.jsonl' WHERE event_type IN ('purchase', 'refund') ) TO 's3://curated-bucket/events/dt=2026-06-11/data.parquet' (FORMAT PARQUET, COMPRESSION ZSTD)""")
日批几十 GB 以内的数据管道,单容器里一个 DuckDB 的运维成本和复杂度,比上一套 Spark 集群低得多。
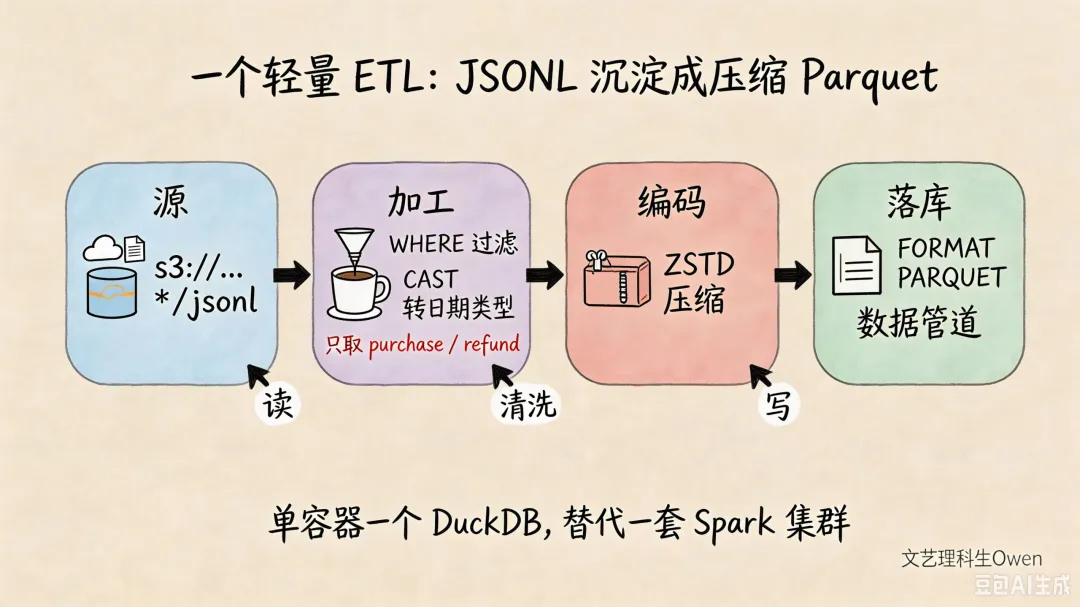 轻量 ETL 流程:S3 上的 JSONL 经源读取(读)、WHERE 过滤与 CAST 转日期(清洗)、ZSTD 压缩(写)后,以 Parquet 格式落库,单容器一个 DuckDB 替代一套 Spark 集群
认识边界,别到处硬用
用 DuckDB 之前,先用三句话自检,三条同时成立才合适:
三条全中,它大概率是比 Pandas / Spark 更省事的选项;任一条不满足,别硬搬。
正反场景对照:
| |
|---|
| 多用户并发写入、高并发逐条事务(OLTP)→ PostgreSQL / SQLite |
| PB 级分布式分析 → ClickHouse / Spark |
| 直查 S3 / ADLS 上的 Parquet、JSON,不先落库 | |
| |
| 给 PostgreSQL 卸掉 OLAP 重读重聚合压力 | |
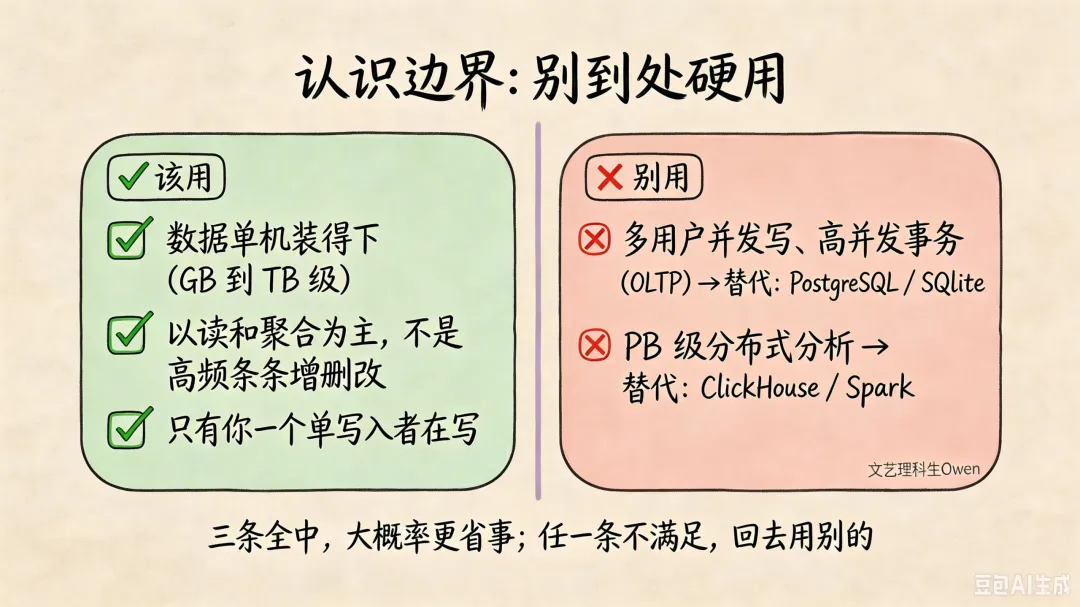 该用 vs 别用边界判断:三条同时成立才合适(数据单机装得下、以读和聚合为主、只有你一个单写入者);多用户并发写/OLTP 或 PB 级分布式分析则改用 PostgreSQL、SQLite、ClickHouse、Spark
再补一个"知道存在即可"的进阶入口,入门不必碰:ATTACH 能把 MySQL、SQLite 等外部库并进来,和本地/远程 Parquet 直接 JOIN,跨源拼一张报表。至于 v1.5 新引入的 VARIANT(半结构化类型化存储,精度与速度优于 JSON 字符串)和 GEOMETRY 空间类型,用到时再翻文档。
起步不用系统啃文档。先 pip install duckdb,挑一个你现在最烦的重活——那个跑三分钟的 CSV 分组,或者一堆日志文件要合并——替换掉,跑通一个,再决定要不要往下学。
 10个月宝宝每天需要喝多少奶粉?