很多人一提到 AI,就会想到 Linux、GPU 和一套庞大的软件环境。STM32 没有这些条件,于是它经常被归到“只能做外设控制”的一边。
这个判断混淆了模型训练和模型部署这两个阶段。
训练阶段需要反复调整参数,数据量大,GPU 能显著缩短时间;
部署阶段拿着已经确定的模型,对一小段输入数据执行固定计算,CPU、DSP 指令或 NPU 都可以承担这项工作。STM32 主要参与后一个阶段。
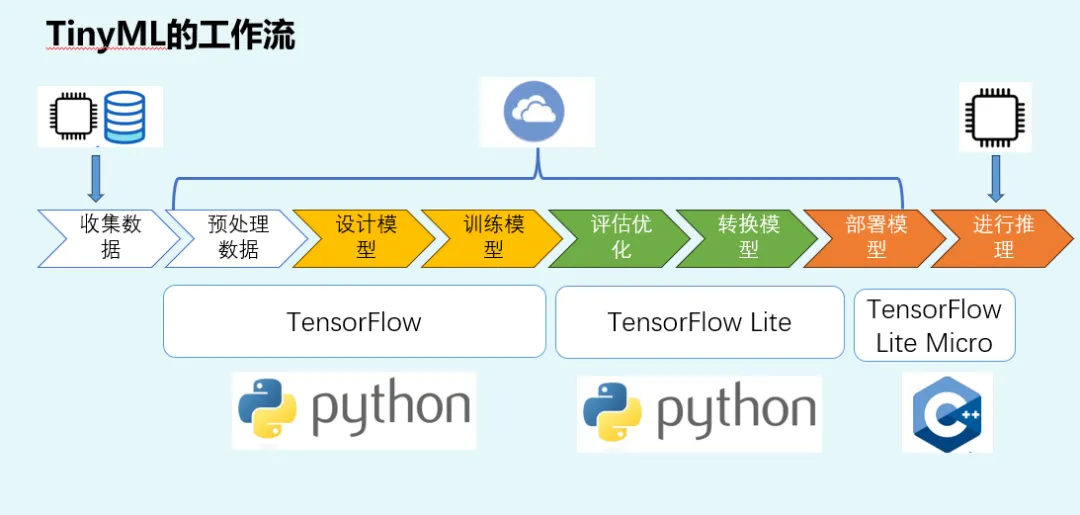
如下面图片中所示的TinyML的工作流。
| 电脑或服务器:准备数据、训练模型、量化和验证STM32:采集传感器数据、运行固定模型、输出分类或异常结果 |
因此,问题应该换一种问法:手里的 STM32 能不能在规定时间内,把实际传感器数据变成可靠的设备判断?
一、STM32 适合处理什么样的 AI 任务?
STM32 最适合接收维度有限、采样规律明确的信号。加速度、角速度、电流、温度、压力、麦克风波形都属于这类输入。它们通常先进入采样缓冲区,再经过滤波、归一化或频域变换,最后交给一个轻量模型。
这类任务的共同点是输出很明确:进入保护模式、记录一次事件、切换设备状态、发出提醒或继续观察。模型不需要生成一段文字,也不需要理解一张高分辨率照片;它需要在固定时间窗口内完成一次小范围判断。
以六轴 IMU 动作识别为例,系统可以用 50 Hz 采样,把一秒钟的加速度和角速度组成一个窗口。模型读取这个窗口,给出“静止、走动、晃动、跌倒”等类别。STM32 同时负责定时器、DMA、串口和状态机,AI 只是其中一个确定时长的处理环节。
二、真正的上限由四个资源决定
“能不能跑”不能只看主频。模型部署后,Flash 要放代码和权重,RAM 要同时容纳输入窗口、中间激活、输出张量、任务栈和通信缓冲区。最容易被忽略的是峰值 RAM:模型每一层都会产生中间结果,运行时需要的空间取决于最大的同时存活缓冲区。
| 模型可用 RAM ≈ 总 RAM - 输入/输出缓冲 - Tensor Arena - 任务栈 - 通信与系统开销可用 Flash ≈ 总 Flash - 启动代码 - 固件 - 模型权重 - 常量数据 |
第二个资源是计算时间。一次推理即使只需要几毫秒,也要放进采样周期和控制周期里核算。100 ms 判断一次的设备,可以容纳更长的推理;1 ms 控制周期的设备,就必须减少模型计算,或者把推理放到低优先级任务中。推理时间还要用 DWT、GPIO 或工具报告实测,不能用主频直接推断。
第三个资源是算子支持。PC 上能运行的模型,转换到 MCU 后需要落成 C/C++ 算子。全连接、1D 卷积、池化、激活函数通常容易部署;复杂动态控制、尺寸变化频繁的算子会增加转换和运行时负担。模型结构需要从目标运行时能够提供的算子集合反向约束。
第四个资源是数据链路。采样率、窗口长度、传感器安装方式和训练数据分布都会影响结果。模型在电脑上的准确率只能说明离线测试通过,板端还要验证采样是否稳定、量化输入是否一致、推理输出是否能被状态机正确使用。
while (1) { if (window_ready) { preprocess_int8(sample_window, model_input); model_run(model_input, model_output); update_state_machine(model_output); } service_uart_dma(); service_control_task();} |
这段代码没有展示某一家框架的 API,它说明的是部署后的真实分工:DMA 或中断负责把数据送进窗口,预处理把数据变成模型要求的格式,模型执行固定计算,状态机再决定设备动作。AI 结果直接进入控制回路之前,还需要阈值、连续确认、超时和故障降级。
三、边界在哪里?
STM32 可以把 TinyML 做成一个完整的端侧功能:传感器采集、预处理、INT8 推理、结果确认、通信上报和设备控制都能放在同一套固件中。它尤其适合状态分类、异常检测、关键词识别、动作识别和低分辨率轻量视觉分类。
大型语言模型、高分辨率多目标检测、复杂语义分割和需要持续处理大量图像的任务,需要更大的内存带宽、操作系统和专用加速器。遇到这些需求,应当换成带 NPU 的 MCU、MPU、视觉 SoC 或边缘计算平台。STM32 的价值在于把“小模型对真实设备的判断”做成稳定、低功耗、离线可运行的产品功能。
| 所以,不用 Linux、不用 GPU 的 STM32,能够完成一类很具体的 AI:对本地传感器数据进行实时识别,并把结果交给设备控制逻辑。判断一块板子是否适合 AI,先列出输入窗口、模型大小、峰值 RAM、推理周期和算子支持,再决定模型与芯片的组合 |
因最近微信公众平台推送规则改变,很多读者反馈没有及时看到更新的文章。根据最新规则,建议多点击“推荐阅读、分享、收藏”等,成为常读用户。