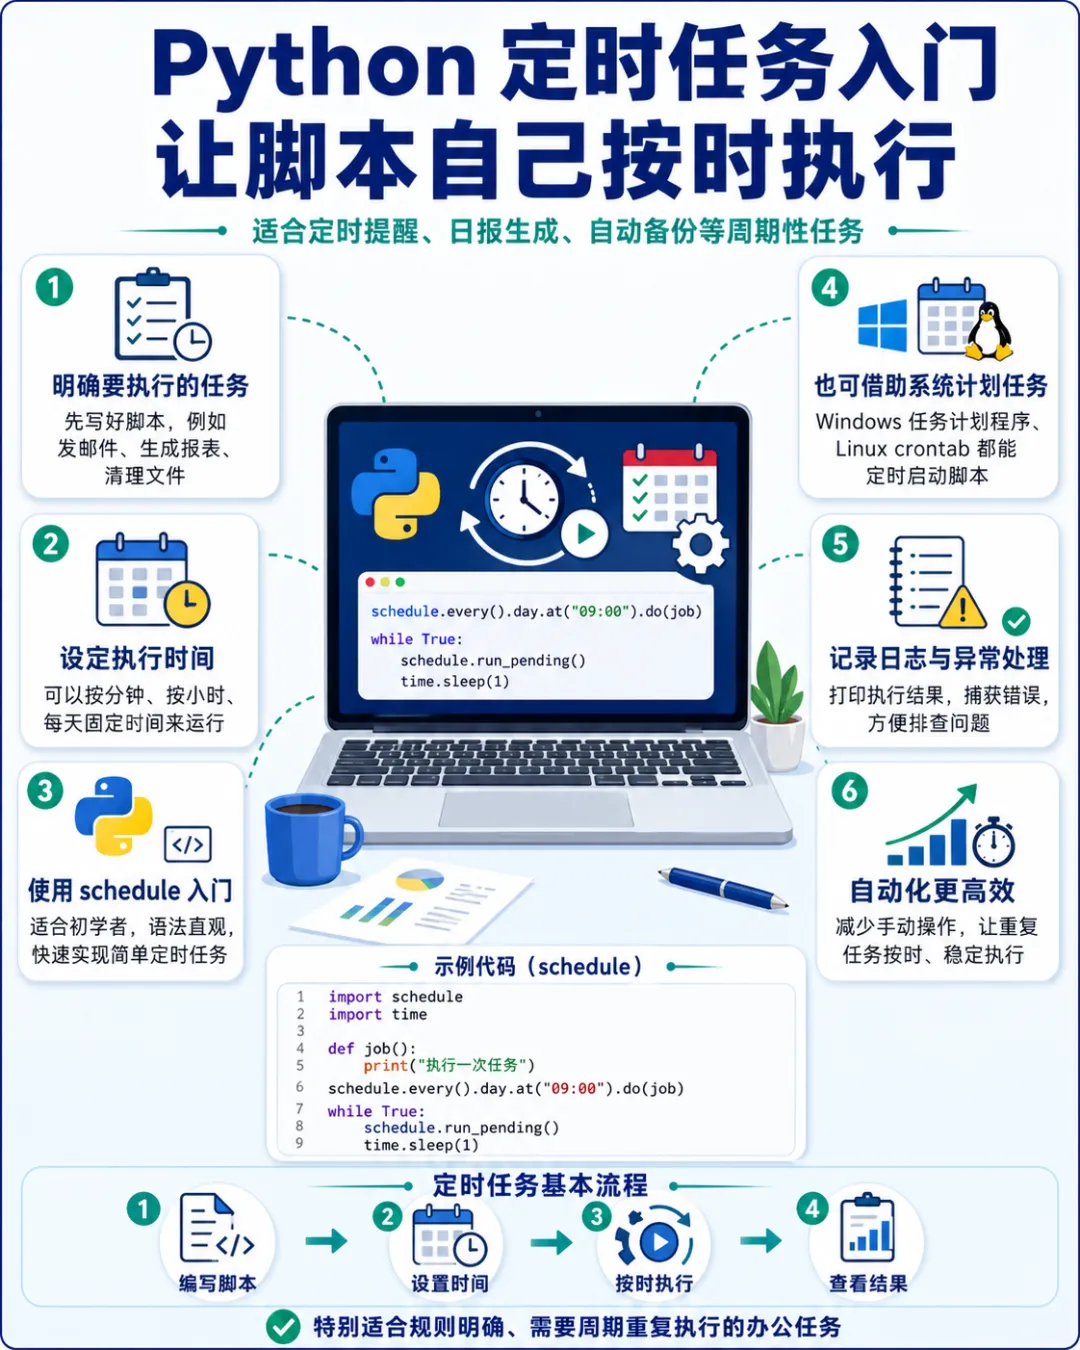
一、为什么定时任务是自动化办公里特别关键的一步
很多人刚开始学自动化时,写出来的脚本已经能干活了。
能自动合并表格 能自动整理文件 能自动发邮件 能自动生成报表
但这些脚本通常还有一个共同问题:
必须你手动去运行
也就是说,自动化只完成了一半。 它只是把“怎么做”自动了,但“什么时候做”还没有自动。
比如:
每天早上 8 点发日报 每周五下午生成周报 每月 1 号整理上月销售数据 每隔 10 分钟检查一次某个目录 每晚 11 点备份文件 每小时抓一次接口数据
这些场景里,真正有价值的,不只是脚本能跑,而是它能在对的时间自己跑。
这就是定时任务存在的意义。
它解决的不是脚本逻辑问题,而是执行时机问题。 它让你的脚本从“一个工具”,变成“一个会按时工作的工具”。
二、什么叫定时任务
定时任务,说白了就是:
让程序在指定时间、指定周期、指定条件下自动执行。
这里有三个关键词特别重要。
第一个,是指定时间。 比如每天 9 点、每周一上午、每月最后一天。
第二个,是指定周期。 比如每 5 分钟一次、每小时一次、每天一次。
第三个,是自动执行。 不需要你临时想起来再双击脚本,也不需要你一直盯着电脑。
所以你可以把定时任务理解成:
给脚本设一个闹钟,时间到了,它自己开工。
这件事看起来普通,实际非常实用。 因为很多办公自动化脚本,真正节省时间的关键,并不是脚本本身,而是它能按时、稳定、重复地跑起来。
三、为什么很多自动化脚本,最后都要走到定时任务
因为现实工作里,重复任务通常都和时间绑定。
日报为什么叫日报。 因为每天都要发。
周报为什么烦。 因为每周都要做。
月报为什么常常让人头疼。 因为它不是只做一次,而是每个月都要重复。
如果你的脚本只是“我想起来就运行”,那你依然要承担这些额外成本:
记时间 怕忘记 临时手忙脚乱 人不在电脑前就断掉 某天忙起来就漏跑了
而一旦加上定时任务,整个流程就会稳定很多。
你今天写好的脚本,明天还能自动跑。 后天照样跑。 下周、下月还能继续跑。
这才是自动化真正开始“替你上班”的时刻。
四、定时任务到底有哪些实现方式
入门阶段,你可以先把定时任务分成两大类来理解。
第一类,是操作系统层面的定时。 也就是让系统来负责“什么时候执行脚本”。
比如:
Windows 任务计划程序 Linux 或 macOS 的 cron
第二类,是程序内部自己定时。 也就是让 Python 脚本自己判断时间,到点就执行。
比如:
schedule 库time.sleep() 配合循环 更复杂一点还可能用 APScheduler
这两类方式都能做定时任务,但适合场景不太一样。
如果你想让脚本真正稳定地长期跑,通常更推荐交给操作系统层面。 因为系统是专门干调度这件事的,更可靠。
如果你只是做一些学习测试、小型工具或者需要程序内部灵活控制执行逻辑,那么 Python 内部定时也很常见。
所以这一章的重点,就是先把这些方式的思路理顺,不急着一上来全学复杂。
五、先说最朴素的一种思路:让脚本自己循环等待
很多初学者接触定时任务时,最容易想到的方法是:
程序一直运行 到时间就执行一次
比如:
import timewhileTrue: print("执行一次任务") time.sleep(10)
这段代码的意思是:
先执行 然后休眠 10 秒 醒来后再执行 如此反复
这就是最简单的“间隔执行”模型。
如果你只是想做一个每隔一段时间执行的小任务,比如:
每隔 1 分钟检查一次目录 每隔 10 秒打印一次状态 每隔 30 秒读取一次接口
这种写法是能跑的,也很好理解。
但它有一个明显问题:
脚本必须一直挂着运行
只要这个 Python 程序停了,定时也就断了。 所以它更适合短时、小型、实验性质的任务,不太适合长期稳定托管的正式定时任务。
六、time.sleep 的思路为什么简单,但不够优雅
因为它虽然能让任务重复执行,但它并不知道“现在几点”,它只知道“再等多久”。
比如你想每天早上 8 点执行一次任务。 如果用 sleep(86400) 这种思路,看起来好像也能凑合,但问题很多:
脚本启动时间不对,整个节奏就歪了 中途报错或中断,定时链条就断掉 系统休眠、电脑重启、网络异常,都可能影响执行 它不适合做复杂的时间规则
所以 time.sleep() 更适合做“每隔多久执行一次”,不太适合做“某天某时执行”。
你可以把它理解成一个简易闹钟。 能用,但功能很有限。
七、程序内部定时,更顺手的入门方式是 schedule 库
如果你想在 Python 代码里写得更像“定时任务”,schedule 是一个非常适合入门的库。
安装:
python -m pip install schedule
最简单例子:
import scheduleimport timedefjob(): print("开始执行任务")schedule.every(10).seconds.do(job)whileTrue: schedule.run_pending() time.sleep(1)
这段代码比刚才直接写 sleep() 更有“定时表达力”。
它清楚地写出了:
每 10 秒执行一次 job
然后通过:
schedule.run_pending()
不断检查有没有到时间的任务。
这种写法的优点很明显:
语义更直观 规则更容易读 扩展多个任务也更顺手
所以如果你在学习阶段想先体会“代码里写定时规则”的感觉,schedule 很适合。
八、schedule 最常见的写法有哪些
这个库最大的优点之一,就是语义很像自然语言。
比如每 5 秒执行一次:
schedule.every(5).seconds.do(job)
每 10 分钟执行一次:
schedule.every(10).minutes.do(job)
每小时执行一次:
schedule.every().hour.do(job)
每天执行一次:
schedule.every().day.do(job)
每天固定时间执行:
schedule.every().day.at("09:00").do(job)
每周一执行:
schedule.every().monday.do(job)
每周一 9 点执行:
schedule.every().monday.at("09:00").do(job)
你会发现,它特别适合表达:
每隔多久 每天几点 每周哪天几点
这已经能覆盖很多办公自动化的入门场景了。
九、一个更像真实工作的例子:每天早上自动生成日报
比如你已经写好一个生成日报的函数:
defgenerate_report(): print("开始生成日报")
那么配合 schedule,就可以这样写:
import scheduleimport timedefgenerate_report(): print("开始生成日报")schedule.every().day.at("08:30").do(generate_report)whileTrue: schedule.run_pending() time.sleep(1)
这段代码的含义就是:
每天 08:30 自动执行生成日报任务
这已经很像真正的自动化流程了。 你只要让脚本一直运行,它就会按时检查并触发。
但这里又会回到一个现实问题:
脚本得一直开着
这就是为什么,程序内定时虽然好学,但长期稳定运行时,很多人最终还是会转向操作系统层面的定时工具。
十、为什么正式环境里,很多人更推荐操作系统定时
因为系统更适合管理“什么时候运行某个程序”。
它的优势主要有几个。
第一,它不要求你的 Python 脚本一直挂着。 你不需要让脚本 24 小时空转等待。
第二,它对系统启动、用户登录、固定时刻执行这些事支持得更成熟。 比如电脑一开机就执行,或者每天固定时间执行。
第三,更稳。 程序内部循环万一卡住、崩溃、断开,定时就停了。 但系统级任务调度通常更独立。
第四,更符合正式环境使用习惯。 尤其是长期运行的办公脚本、备份脚本、定时报表脚本,大多最终都交给系统调度。
所以你要慢慢形成一个判断:
临时、小型、学习型任务,用 schedule 很合适。 长期、固定、正式任务,优先考虑系统定时。
十一、Windows 下最常见的定时工具:任务计划程序
如果你在 Windows 环境里做办公自动化,最常见的系统级定时方式就是:
任务计划程序
它是系统自带工具,专门用来在指定条件下执行程序。
你可以让它:
每天某个时间运行 Python 脚本 每周固定时间运行 开机时运行 登录时运行 空闲时运行
从思路上看,它做的事其实很简单:
到点了 就帮你把某个命令执行一下
比如执行:
python report.py
所以你不用把它想得多神秘。 它本质上只是一个“系统级闹钟 + 启动器”。
十二、Windows 定时任务的核心思路,不是点哪里,而是想清楚三件事
你以后不管通过图形界面配置,还是别的方式,最核心都离不开这三件事。
第一,什么时候触发。 比如每天 8 点,或者每周五 18 点。
第二,执行什么程序。 通常是 Python 解释器,或者一个 bat 脚本。
第三,参数和工作目录是什么。 比如你的脚本路径在哪,脚本运行时依赖的文件又在哪。
这里第三点特别容易被忽略。 很多人明明在终端里能跑,一到定时任务里就报错,很大原因不是代码错,而是工作目录不对。
比如你的脚本里写了相对路径:
df = pd.read_excel("data.xlsx")
你在项目目录手动运行当然没问题。 但定时任务运行时,如果当前目录不是这个项目目录,就会找不到文件。
所以做定时任务时,一个非常稳的习惯是:
尽量用绝对路径 或者在脚本开头先切换到项目目录
十三、Linux 和 macOS 下常见的是 cron
如果你以后在服务器、Linux 或 macOS 环境里部署定时任务,经常会碰到:
cron
它也是经典定时工具,适合按时间规则执行命令。
比如常见的 cron 表达方式可以表示:
每天 8 点执行 每小时执行 每周一执行 每月 1 号执行
它本质上和 Windows 任务计划程序一样,都是系统层面的调度器。 只是配置方式不同,更多靠规则表达式。
这一章是入门,不展开很深,但你至少要有这个概念:
Windows 常想到任务计划程序 Linux 和 macOS 常想到 cron
这会让你以后接触不同环境时不至于完全陌生。
十四、既然系统定时更稳,为什么还要学程序内定时
因为两者解决的问题角度不一样。
程序内定时更适合:
快速试验 学习理解 需要在一个程序里维护多个任务 需要更灵活的任务逻辑 任务不是特别长期托管
系统定时更适合:
正式落地 固定时间重复执行 系统级托管 减少脚本常驻运行
也就是说,程序内定时更像“写在代码里的规则控制”。 系统定时更像“把脚本交给系统按时叫醒”。
你不能简单说谁更高级。 关键是看当前需求更适合哪种方式。
十五、定时任务里最常见的真实需求,不是一次运行,而是无人值守
这一点特别重要。
很多人第一次写定时任务时,关注点都在:
会不会按时执行
但真正实战里,更关键的问题通常是:
执行失败怎么办 日志有没有留 有没有异常提醒 电脑重启后还会不会跑 路径对不对 依赖环境对不对 有没有权限问题
因为一旦是定时任务,它就意味着很多时候不是你盯着它跑。 它是在你不操作的时候自己跑。
这就要求脚本本身比平时更稳。
也就是说,定时任务的重点不只是“定时”,还包括“无人值守”。
十六、写定时脚本时,最好先把普通脚本打磨稳
很多人一上来就配置定时任务,结果问题一堆。 其实顺序最好反过来:
先把脚本本身在终端里手动跑稳 确认输入输出都正常 确认文件路径都对 确认不会中途报错 再上定时任务
因为如果脚本本身都不稳定,定时任务只会把不稳定放大。
正确顺序应该是:
先手动运行成功 再让系统帮你重复运行
这会省掉很多排查时间。
十七、定时任务最常见的第一类坑:路径问题
这是高频中的高频。
比如你的脚本里有:
with open("result.txt", "w", encoding="utf-8") as f: f.write("完成")
你手动运行时没问题。 但定时任务里一跑,找不到文件、保存位置不对、数据目录丢失。
问题通常出在:
当前工作目录不是你以为的那个目录
所以一个很稳的做法是,在脚本开头先定位脚本自身目录:
from pathlib import Pathimport osBASE_DIR = Path(__file__).resolve().parentos.chdir(BASE_DIR)
这样后面相对路径就更不容易乱。
当然,更彻底的方法还是直接写绝对路径。 尤其是正式定时任务里,路径最好别靠猜。
十八、第二类坑:环境问题
很多人手动运行时用的是某个虚拟环境。 但定时任务执行时,可能调用的是另一个 Python。
于是就会出现这种情况:
终端里能跑 定时任务里报模块不存在
原因很简单:
不是同一个解释器环境。
所以做定时任务时,一个非常实用的习惯是:
明确写出你要调用的 Python 解释器路径
比如不是只写:
python report.py
而是写你虚拟环境里的 Python 路径去执行脚本。 这样更稳,也更容易排查问题。
如果你前面已经学过虚拟环境,这里就会一下子感觉很真实了。 环境不对,定时任务再准时也没用。
十九、第三类坑:脚本执行了,但没人知道结果如何
定时任务和手动运行最大的区别在于:
你不一定在现场
所以脚本到底有没有成功执行,不能只靠肉眼看终端。 更好的做法是主动留日志。
比如最简单地记录文本日志:
from datetime import datetimewith open("task.log", "a", encoding="utf-8") as f: f.write(f"{datetime.now()}:任务开始执行\n")
执行成功也记一下:
with open("task.log", "a", encoding="utf-8") as f: f.write(f"{datetime.now()}:任务执行成功\n")
如果出错,也记错误:
try:# 执行任务passexcept Exception as e:with open("task.log", "a", encoding="utf-8") as f: f.write(f"{datetime.now()}:任务执行失败:{e}\n")
你会发现,定时任务一旦开始无人值守,日志就会变得非常值钱。 因为它是你排查问题时最直接的证据。
二十、第四类坑:一个任务失败,就影响后面所有定时运行
比如你有一个每天执行的脚本,某天因为网络异常失败了。 如果你没做异常处理,程序可能直接崩掉,中间文件还没清理干净,下次执行又继续出问题。
所以定时任务脚本特别适合写成“更稳”的样子:
关键步骤用异常处理包起来 日志写清楚 必要时做失败重试 不要因为单个小问题就让整个脚本彻底瘫掉
比如:
import timefor i in range(3):try: print("尝试执行任务")# 任务代码breakexcept Exception as e: print(f"第{i+1}次失败:{e}") time.sleep(5)
这种小小的重试逻辑,可能就能让定时任务稳定很多。
二十一、程序内定时和系统定时,怎么做选择
你可以先按这个思路判断。
如果你现在只是:
学习 测试 临时工具 不想碰系统配置 需要快速验证逻辑
那先用 schedule 很合适。
如果你现在是:
正式办公脚本 每天固定要跑 不能依赖你一直开着 Python 程序 希望系统自己托管 要长期稳定执行
那更适合上系统级定时任务。
简化成一句话就是:
想先学清楚逻辑,用 schedule想真正稳定落地,用系统定时
这个判断非常实用。
二十二、一个完整的小例子:每天自动生成销售汇总
假设你已经有一个生成汇总表的函数:
import pandas as pddefgenerate_report(): df = pd.read_excel("销售数据.xlsx") summary = df.groupby("门店", as_index=False)[["销量", "销售额"]].sum() summary.to_excel("门店销售汇总.xlsx", index=False) print("报表生成完成")
如果你只是学习,可以先用 schedule:
import scheduleimport timeimport pandas as pddefgenerate_report(): df = pd.read_excel("销售数据.xlsx") summary = df.groupby("门店", as_index=False)[["销量", "销售额"]].sum() summary.to_excel("门店销售汇总.xlsx", index=False) print("报表生成完成")schedule.every().day.at("08:30").do(generate_report)whileTrue: schedule.run_pending() time.sleep(1)
如果你想正式落地,通常就是把上面的 generate_report() 脚本保存成一个 .py 文件,然后交给系统定时工具每天 08:30 去调用。
这就是一个非常典型的办公自动化落地过程。
二十三、一个更稳一点的定时脚本,最好长什么样
不是最短,而是更适合实际运行的样子。
比如:
from pathlib import Pathfrom datetime import datetimeimport osimport pandas as pdBASE_DIR = Path(__file__).resolve().parentos.chdir(BASE_DIR)LOG_FILE = BASE_DIR / "task.log"defwrite_log(message):with open(LOG_FILE, "a", encoding="utf-8") as f: f.write(f"{datetime.now()}:{message}\n")defgenerate_report(): df = pd.read_excel("销售数据.xlsx") summary = df.groupby("门店", as_index=False)[["销量", "销售额"]].sum() summary.to_excel("门店销售汇总.xlsx", index=False)try: write_log("任务开始") generate_report() write_log("任务成功完成")except Exception as e: write_log(f"任务失败:{e}")
这段代码虽然不长,但已经体现出定时任务脚本的几个关键习惯:
明确工作目录 单独封装任务函数 写日志 异常处理
这就比“随手写几行然后丢进定时器里”稳得多。
二十四、定时任务入门阶段,最值得养成的几个习惯
第一,脚本先手动跑通,再去定时。 第二,路径尽量明确,不要过度依赖当前目录。 第三,环境要明确,别让定时任务调用错 Python。 第四,日志要留,别让定时任务变成黑盒。 第五,出错要兜底,别让一次失败带崩后续。 第六,先小规模测试,再正式长期运行。
这些习惯看起来不复杂,但它们决定了你写出来的是“能演示的定时脚本”,还是“能真正长期使用的定时脚本”。
二十五、本章要点整理
定时任务的核心价值,是让脚本在指定时间或周期内自动执行,不再依赖人工手动触发。 实现定时任务常见有两类思路,一类是 Python 程序内部定时,如 schedule,另一类是操作系统层面的定时,如 Windows 任务计划程序或 cron。schedule 适合学习、测试和小型工具,语法直观,适合写在代码里。 长期稳定的正式任务,通常更适合交给操作系统调度。 定时任务真正的难点不只是定时本身,还包括路径、环境、日志、异常处理和无人值守稳定性。 做定时脚本时,建议先手动跑通,再接定时工具;同时尽量明确 Python 环境和文件路径,并做好日志记录。