当前位置:首页>python>每天10分钟玩转Python基础篇 - 正则表达式(re)

每天10分钟玩转Python基础篇 - 正则表达式(re)

  • 2026-09-07 17:10:41
每天10分钟玩转Python基础篇 - 正则表达式(re)
PYTHON · 基础篇第7课2026.08

还在用 split 和 replace 硬拆文本?

给你的文本,装个过滤器

re · 正则表达式

📦 3 PARTS + CONCLUSION

👉 滑动

PART 01

通俗原理

模式模板

PART 02

核心用法

8 个套路

PART 03

完整案例

日志解析器

PART ///

写在最后

小结自检

这是基础篇第7篇。前面我们学了变量、循环、字符串,还有列表、元组、字典、集合,以及 argparse。今天学一个特别能打的工具:正则表达式(re 模块)。它是处理文本的「瑞士军刀」,查、找、替、切、洗,一把搞定。

你有没有遇到过这种需求:从一坨混乱的文本里,把手机号、邮箱、日期一个一个抠出来?或者把用户填的日期 2026/08/24、2026-08-24、2026.08.24 统一成一种格式?再或者解析服务器日志,把每一行的「时间、级别、消息」拆开?

用字符串的 split、replace、find 也能硬做,但代码会又长又绕。正则表达式就是专门干这个的——它是一门「描述文本模式」的小语言,写一个模式,就能匹配一堆符合规则的字符串。

PART 01

通俗原理:模式模板

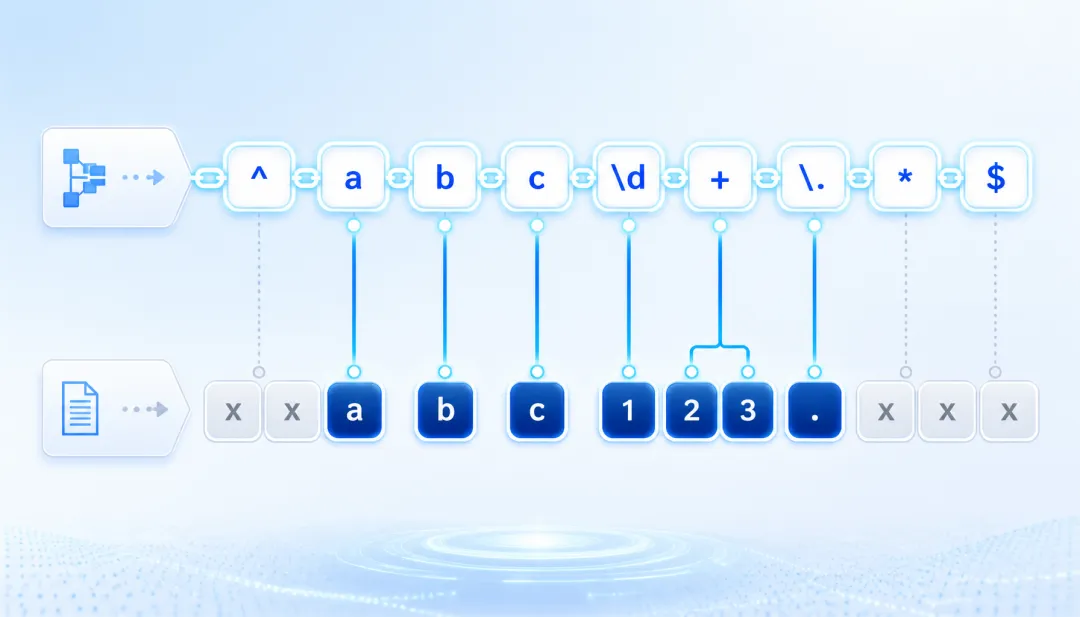
先建立一个直觉:正则表达式就是一个「模式模板」。你告诉它「我要找的东西长什么样」,它就在文本里帮你找所有符合这个长相的地方。

比如 \d+ 这个模式,读作「一个或多个数字」。放到 re.findall 里,就能把一段话里的所有数字都抓出来:

python

import re

text="价格 12 元,数量 3 个,共 36 元"

print(re.findall(r"\d+",text))# ['12', '3', '36']

注意那个 r"\d+" 里的 r。这是 raw string(原始字符串)前缀,告诉 Python「这个字符串里的反斜杠就是反斜杠,别当转义符处理」。正则会大量用到反斜杠,所以几乎总是用 raw string 写模式,否则 \d 会被 Python 当成非法转义。

下面这张图能帮你建立「模式 ↔ 文本」的对应关系:模式串像一条发光的链条,逐个字符对上文本里的字符,匹配成功的亮起来。

PART 02

核心用法:8 个套路

STEP 01

查:search 和 match

python

import re

# search:任意位置找第一个数字

print(re.search(r"\d+","订单号是 1024").group())# 1024

# match:只从开头匹配

print(re.match(r"\d+","1024 订单").group())# 1024

print(re.match(r"\d+","订单 1024"))# None(开头不是数字)

re.search 在字符串里任意位置找第一个匹配;re.match 只从开头匹配。匹配到的东西是一个 Match 对象,用 .group() 取出匹配文本,match 没匹配到就返回 None。

STEP 02

找所有:findall

python

print(re.findall(r"\d+","价格 12 元,数量 3 个,共 36 元"))

# ['12', '3', '36']

re.findall 返回所有匹配,组成列表。这是最常用的一个。

STEP 03

字符类和字符集

python

print(re.findall(r"\w+","user_name@example.com"))

# ['user_name', 'example', 'com']

print(re.findall(r"[0-9a-f]+","颜色 #FF8800"))

# ['8800']  ← 注意:# 不是十六进制字符,所以 FF 被 # 截断了

\d 数字、\w 单词字符(字母数字下划线)、\s 空白;[] 自定义字符集,比如 [0-9a-f] 匹配十六进制字符。

STEP 04

量词:控制重复次数

python

print(re.findall(r"colou?r","color colour colouur"))# ['color', 'colour']

print(re.findall(r"a{2,3}","a aa aaa aaaa"))# ['aa', 'aaa', 'aaa']

* 0次或多次、+ 1次或多次、? 0或1次、{m,n} 至少m次最多n次。

STEP 05

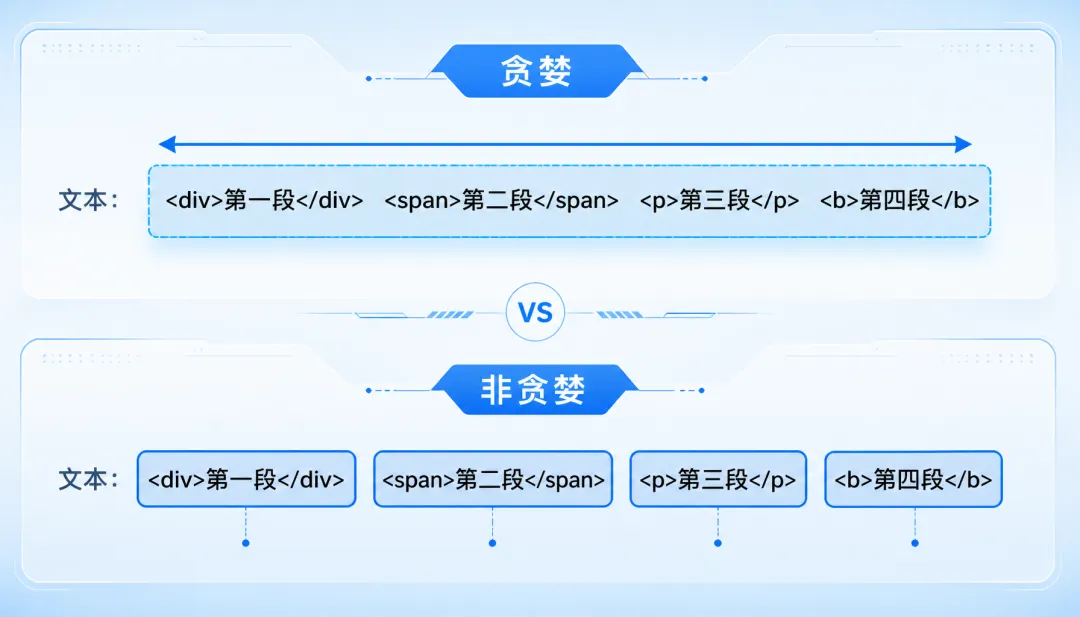
贪婪 vs 非贪婪

python

s="<b>加粗</b> 和 <i>斜体</i>"

print(re.findall(r"<.*>",s))# 贪婪:一整块

print(re.findall(r"<.*?>",s))# 非贪婪:['<b>', '</b>', '<i>', '</i>']

这是正则最容易踩的坑。* 和 + 默认是贪婪的(尽量多吃),加 ? 变非贪婪(尽量少吃)。提取标签、括号内容这类场景,几乎都用非贪婪。

STEP 06

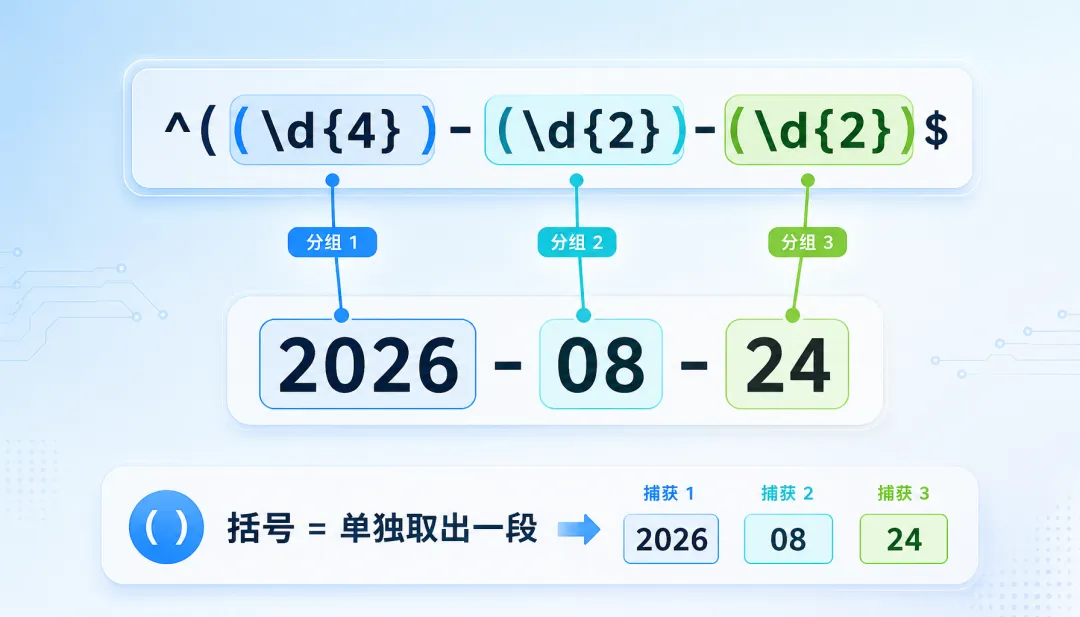
分组:捕获子串

python

# 普通分组

m=re.search(r"(\d{4})-(\d{2})-(\d{2})","日期 2026-08-24")

print(m.group(0))# 2026-08-24(整个匹配)

print(m.group(1))# 2026(第一个括号)

print(m.group(2))# 08

print(m.group(3))# 24

# 命名分组

m2=re.search(r"(?P<year>\d{4})-(?P<month>\d{2})-(?P<day>\d{2})","日期 2026-08-24")

print(m2.group("year"))# 2026

print(m2.group("month"))# 08

print(m2.group("day"))# 24

用 () 把模式的一部分括起来,就能单独取出那一部分。(?P<name>...) 还能给分组起名字,用 group("name") 访问。

STEP 07

替:sub

python

# 把多个空格压成一个

print(re.sub(r"\s+"," ","这  是   一段    乱   文本"))

# 这 是 一段 乱 文本

# 交换日期格式:2026-08-24 → 24/08/2026

print(re.sub(r"(\d{4})-(\d{2})-(\d{2})",r"\3/\2/\1","2026-08-24"))

# 24/08/2026

re.sub(模式, 替换内容, 文本) 把匹配到的部分替换掉。替换内容里可用 \1、\2 引用分组。

STEP 08

切:split

python

print(re.split(r"[,\s]+","苹果, 香蕉 橙子,,葡萄"))

# ['苹果', '香蕉', '橙子', '葡萄']

re.split(模式, 文本) 按模式分割,比字符串的 split 强大——[,\s]+ 表示「一个或多个逗号或空白」,连续的逗号和空格都被当成一个分隔符。

PART 03

完整案例:日志解析器

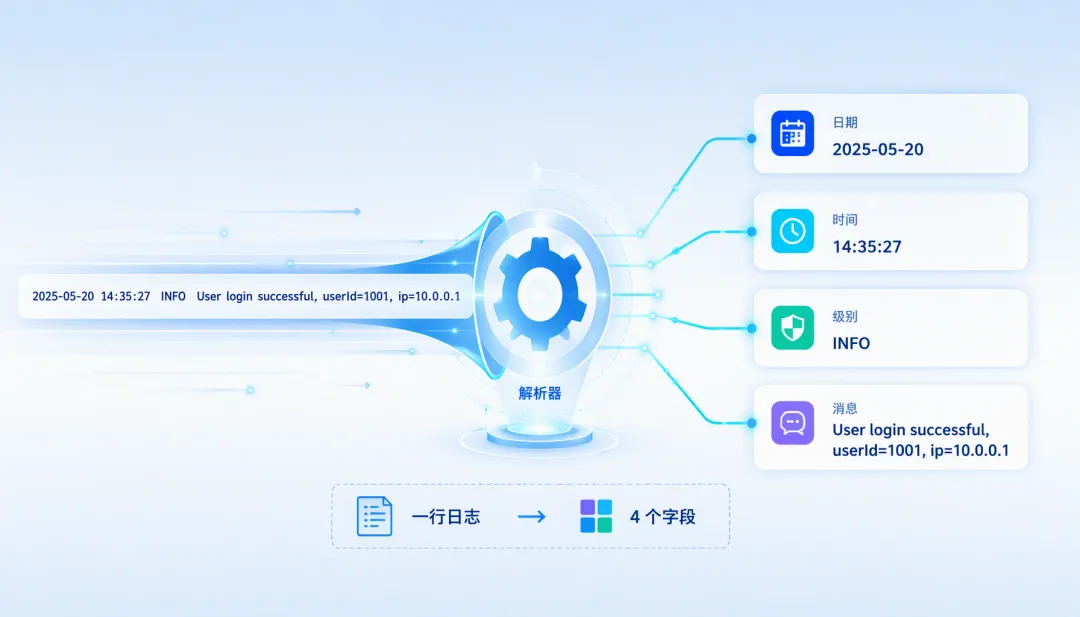
把上面的东西串起来,写一个实用的「日志解析器」——从日志行里提取时间、级别、消息,顺便提取里面的手机号和邮箱:

python

import re

# 一条典型的日志

log="2026-08-24 10:30:15 ERROR 数据库连接失败,请检查配置"

# 用命名分组把日志拆成 4 个字段

pattern=re.compile(r"(?P<date>\d{4}-\d{2}-\d{2}) "

r"(?P<time>\d{2}:\d{2}:\d{2}) "

r"(?P<level>\w+) "

r"(?P<msg>.*)")

m=pattern.search(log)

print("日期:",m.group("date"))# 2026-08-24

print("时间:",m.group("time"))# 10:30:15

print("级别:",m.group("level"))# ERROR

print("消息:",m.group("msg"))# 数据库连接失败,请检查配置

# 再从另一段文本里提取手机号和邮箱

text="联系我:13812345678 或 email me at foo@bar.com,备用 13987654321"

phones=re.findall(r"1[3-9]\d{9}",text)

emails=re.findall(r"[\w.+-]+@[\w-]+\.[\w.]+",text)

print("手机号:",phones)# ['13812345678', '13987654321']

print("邮箱:",emails)# ['foo@bar.com']
手机号模式 1[3-9]\d{9} 的意思是:1 开头,第二位 3-9 之间,后面跟 9 位数字——正好 11 位手机号。

避坑指南

4 个常见坑

1. 一定用 raw string 写模式。不用 r"\d" 而写 "\d",会报 SyntaxWarning,未来会变成 SyntaxError。

2. 提取标签/括号内容用非贪婪 .*?,别用贪婪 .*,否则会吞过头。

3. match 和 search 别搞混:match 只认开头,search 满字符串找。绝大多数情况你要的是 search 或 findall。

4. findall 遇到分组只返回分组内容:re.findall(r"(\d+)", ...) 返回的是分组列表而不是整个匹配。想要完整匹配就别加多余括号,或用 finditer。

写在最后

小结自检

自检一下,下面这四题都能答上来,正则的常用套路你就掌握了:

① 能用 re.findall 从一段文本里找出所有数字吗?

② 能写出匹配 11 位手机号的模式吗?

③ 能说出贪婪 .* 和非贪婪 .*? 的区别吗?

④ 能用 re.sub 把 2026/08/24 统一成 2026-08-24 吗?

正则会在后面的爬虫、数据清洗、日志分析里反复出现,值得现在就打牢基础。

既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。

点赞
在看
转发

THANKS FOR READING

最新文章

随机文章