Linux Block I/O 性能分析: 工具(1)
在 Linux 性能分析中,Disk I/O 问题通常比 CPU、Memory 更难定位。因为我们看到的“磁盘慢”,可能来自多种不同原因:
●应用产生了大量 I/O 请求
●block layer 队列堆积
●I/O request size 太小
●磁盘 IOPS 或吞吐达到上限
●I/O latency 突然升高
●filesystem、page cache 或 writeback 成为瓶颈
●某个进程产生了大量随机 I/O
因此,分析 Block I/O 时,一个非常重要的思路是:
先看整体指标,再定位进程,最后深入 block layer。
Linux 中常用的工具包括 iostat、sar、pidstat、iotop、perf 和 blktrace。

1. iostat:磁盘 I/O 总体情况
iostat 是分析 Linux Disk I/O 最常用的工具之一,来自 sysstat。
iostat -xz 1
典型输出:
Devicer/sw/srkB/swkB/saqu-szawait%util
nvme0n1120030048000120002.11.485.0
其中最重要的指标包括:
r/s、w/s
每秒读写请求数量,即 IOPS:
r/s = reads per second
w/s = writes per second
例如:
r/s = 5000
w/s = 1000
表示设备每秒处理约 6000 个 I/O request。
rkB/s、wkB/s
每秒读写的数据量:
rkB/s
wkB/s
可以用来判断设备主要受 IOPS 还是 bandwidth 限制。
例如:
r/s = 10000
rkB/s = 40000
平均每个 request 只有:
40 MB/s / 10000 ≈ 4 KB
这明显更接近“小 I/O + 高 IOPS”的 workload。

await
await 是非常重要的指标,表示 I/O request 的平均等待时间,通常以 ms 为单位。
例如:
await = 0.5 ms
说明平均 I/O latency 较低。
如果:
await = 50 ms
同时:
aqu-sz = 20
通常意味着设备或者 block layer 出现了明显的 I/O 排队。
但需要注意:
await 是平均值,不能完全代表 tail latency。
对于延迟敏感服务,还需要进一步观察更细粒度的 latency。
aqu-sz
表示平均 I/O queue depth。
aqu-sz = 0.1
说明队列基本为空。
而:
aqu-sz = 50
说明大量 I/O request 正在排队。

%util
表示设备有多少时间处于 busy 状态。
例如:
%util = 99%
传统 HDD 上通常意味着设备非常繁忙。
但是对于现代 NVMe/SSD,不能简单认为 %util=100% 就意味着磁盘达到性能极限。
现代高性能设备可以并行处理大量 I/O,因此应该结合:
IOPS
throughput
await
aqu-sz
一起判断。

2. sar:观察 I/O 的历史趋势
iostat 更适合实时观察,而 sar 非常适合观察系统过去一段时间的 I/O 状态。
sar -d 1
或者:
sar -d -f /var/log/sysstat/sa24
其中 -d 表示 block device。
例如:
DEVtpsrkB/swkB/sawait%util
nvme0n1350080000200002.572
sar 最大的价值是:
它可以回答“问题是什么时候发生的”。
例如应用昨天 3:00 出现 latency spike,但现在已经恢复。
此时:
iostat
只能告诉你当前状态,而:
sar -d -f ...
可以帮助回溯当时的磁盘:
●IOPS
●throughput
●latency
●utilization
是否发生异常。
因此在生产环境中,sar 很适合和监控系统结合,用于事故后的历史分析。
3. pidstat:找到是谁在产生 I/O
知道:
nvme0n1 await = 50ms
还不够。
下一步通常要问:
到底哪个进程产生了这些 I/O?
可以使用:
pidstat -d 1
例如:
PIDkB_rd/skB_wr/sCommand
123410240051200mysqld
56781024204800backup
这时候就可以发现:
磁盘写入异常
↓
pidstat
↓
backup 进程产生大量 write
常见指标:
kB_rd/s
kB_wr/s
kB_ccwr/s
iodelay
其中 iodelay 可以帮助判断进程是否因为 I/O 而产生明显等待。
因此:
iostat 主要回答 “磁盘怎么样?” pidstat 主要回答 “哪个进程在产生 I/O?”
4. iotop:实时观察 I/O 活跃进程
iotop 类似于 top,但关注 I/O。
sudo iotop
可以看到类似:
TIDUSERDISK READDISK WRITE
1234mysql20.5 MB/s5.2 MB/s
5678root0.1 MB/s150.0 MB/s
它特别适合故障现场快速定位:
磁盘突然变慢
↓
iotop
↓
发现某个 backup / logging / database process
↓
进一步分析
相比 pidstat,iotop 更偏向交互式实时观察。
5. perf:分析 I/O 对应用和 CPU 的影响
perf 并不是一个专门的 Disk I/O 工具,但它非常适合回答:
为什么应用会因为 I/O 变慢?
例如:
perf stat -p
可以观察:
task-clock
context-switches
page-faults
cpu-migrations
进一步可以使用:
perf record -p
perf report
分析应用到底在哪里消耗 CPU。
对于 I/O 问题,还可以观察:
perf trace
例如:
read()
write()
pread64()
pwrite64()
fsync()
fdatasync()
这可以建立:
Application
↓
read/write/fsync
↓
filesystem
↓
block layer
↓
device
之间的联系。
一个非常重要的场景
假设:
iostat:
await = 20ms
但是应用 CPU 使用率很低。
这可能意味着应用线程大量时间在等待 I/O。
反过来,如果:
iostat:
disk latency 很低
但应用仍然很慢,那么问题可能根本不是物理磁盘,而是:
●syscall
●filesystem
●page fault
●lock contention
●CPU scheduling
这时候 perf 就非常有价值。
6. blktrace:深入 Linux Block Layer
如果:
iostat
↓
发现 disk latency 异常
pidstat/iotop
↓
找到产生 I/O 的进程
但是
↓
仍然不知道 I/O 为什么这么慢
就可以进一步进入 block layer:
blktrace
例如:
sudo blktrace -d /dev/nvme0n1 -o trace
然后:
blkparse trace.blktrace.* > trace.txt
blktrace 可以观察 block I/O request 在 kernel 中的生命周期。
可以把它简单理解成:
Application
│
▼
read()/write()
│
▼
Filesystem
│
▼
Block Layer
│
├──queue
├──dispatch
└──completion
│
▼
Device Driver
│
▼
Disk
它可以帮助分析:
●request 什么时候进入 block layer
●什么时候被 dispatch
●什么时候完成
●request 在 queue 中等待多久
●I/O request size
●sequential / random I/O
●read / write 分布
因此,blktrace 更适合做 底层 I/O latency 分解。

7. 六个工具如何组合起来?
实际排查 Disk I/O 问题时,可以采用下面的路径:
DiskI/O 问题
│
▼
┌───────────┐
│iostat│
└─────┬─────┘
│
┌───────────────┐
▼▼▼
IOPSThroughputLatency
│││
└───────────────┘
▼
pidstat/iotop
│
▼
哪个进程?
│
▼
perf
│
▼
syscall/ CPU / page fault
│
▼
blktrace
│
▼
Blocklayer request
queue/ dispatch /
completionlatency
而 sar 负责另外一条线:
sar
│
└── 历史数据
│
├──问题什么时候发生?
├──IOPS 是否突然升高?
├──throughput 是否异常?
└──latency 是否出现 spike?

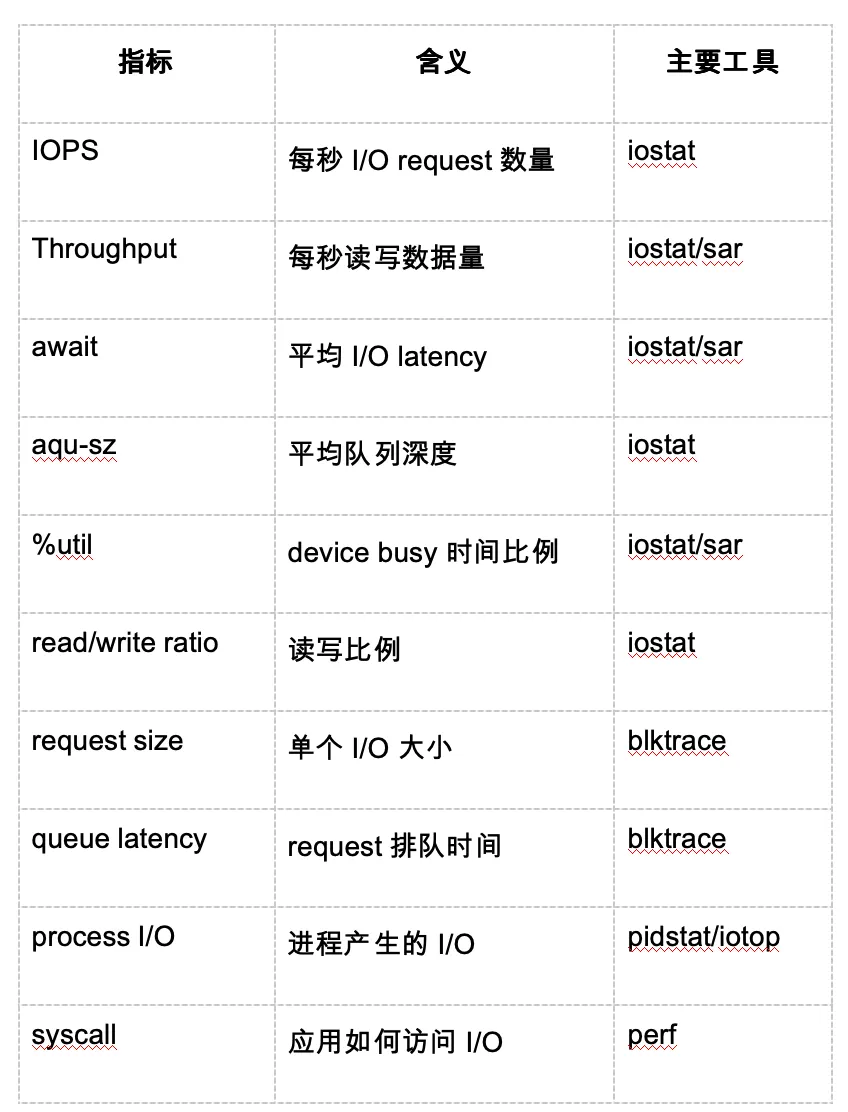
8. 最重要的 Disk I/O 指标
实际性能分析时,不要只盯着 %util。
建议重点关注:
尤其要建立一个概念:
Disk I/O 性能不能用单一指标判断。
例如:
IOPS 很高
+ throughput 很低
可能是大量小随机 I/O。
而:
IOPS 很低
+ throughput 很高
可能是大量 sequential I/O。
又例如:
IOPS 不高
+ throughput 不高
+ await 很高
则更值得关注:
queueing
device latency
filesystem
storage backend
9. 一套实用的排查命令
生产环境中可以先从下面几条开始:
# 1. 查看整体 Disk I/O
iostat -xz 1
# 2. 查看历史 Disk I/O
sar -d 1
# 3. 查看进程 I/O
pidstat -d 1
# 4. 实时观察 I/O 活跃进程
sudo iotop
# 5. 查看进程 CPU / syscall 行为
sudo perf stat -p
sudo perf trace -p
# 6. 深入 Block Layer
sudo blktrace -d /dev/nvme0n1 -o trace
可以形成一个非常实用的思维模型:
iostat
↓
整体磁盘是否异常?
sar
↓
异常发生在什么时候?
pidstat / iotop
↓
是谁产生了 I/O?
perf
↓
应用为什么在等待 / 产生这些 I/O?
blktrace
↓
Block Layer 中 request 到底在哪里等待?
总结
Linux Block I/O 分析最重要的不是记住某一个命令,而是建立 从应用到设备的完整 I/O 链路:
Application
↓
System Call
↓
Filesystem / Page Cache
↓
Block Layer
↓
I/O Scheduler
↓
Device Driver
↓
SSD / HDD
对应工具则可以按照深度逐步展开:
iostat
↓
sar
↓
pidstat / iotop
↓
perf
↓
blktrace
其中,iostat 是入口,pidstat/iotop 用来定位进程,perf 用来理解应用行为,而 blktrace 用来深入 Block Layer。 掌握这条分析路径,基本就能覆盖绝大多数 Linux Disk I/O 性能问题。
 10个月宝宝每天需要喝多少奶粉?