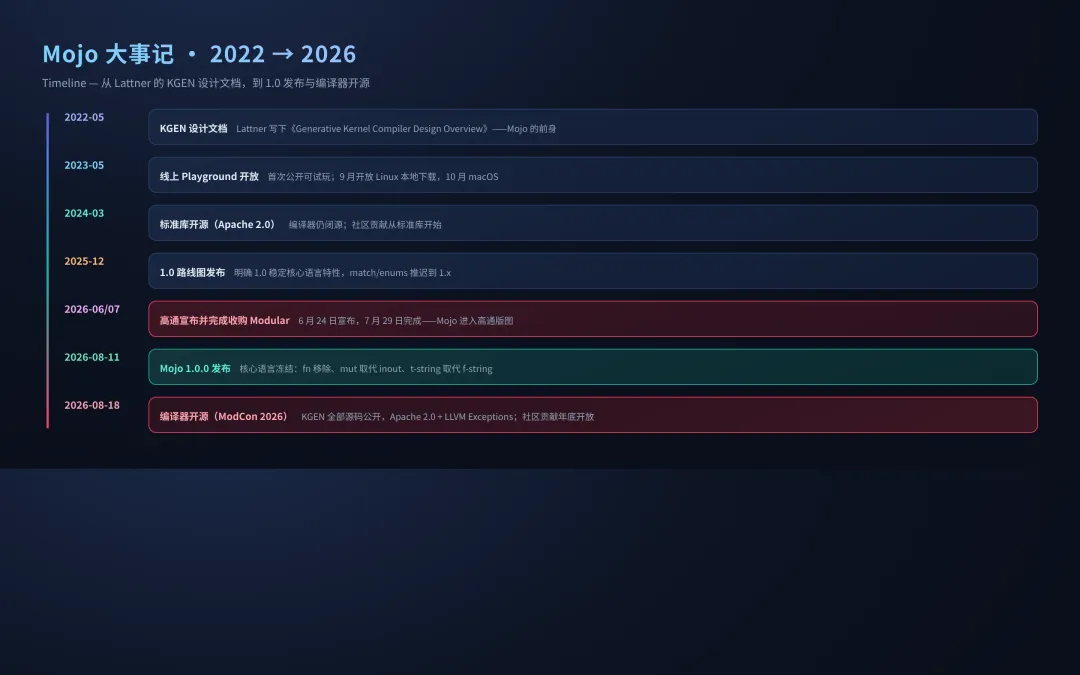
2026 年 8 月的最后两周,Mojo 语言一口气完成了三件大事:8 月 11 日发布 1.0.0(核心语法冻结),8 月 18 日在 ModCon 2026 上宣布编译器全部开源(Apache 2.0 + LLVM Exceptions),而在此之前,高通(Qualcomm)已在 7 月 29 日完成对 Modular 的收购——这家由 LLVM 之父 Chris Lattner 创立的公司,连同它押注的"Python 语法 + 系统编程性能"语言,正式进入新阶段。本文用 5 段可编译运行的代码,带你快速看懂 Mojo 的语法;再用一份官方编译器设计文档,讲清楚它"没有传统 AST、完全构建在 MLIR 之上"的实现逻辑。
1. 引子:为什么值得现在关注 Mojo
过去三年 Mojo 一直处于"能用但闭源"的状态:2023 年 5 月开放线上 Playground,9 月开放 Linux 本地下载;2024 年 3 月把标准库开源(Apache 2.0)。但编译器本体始终闭源——这在系统编程语言里相当罕见,也让很多人对它保持观望。
2026 年 8 月,观望的窗口关上了:
Mojo 1.0.0(8 月 11 日):核心语言特性稳定,官方明确"1.x 阶段只加不破";
编译器开源(8 月 18 日):modular/modular 仓库公开了完整编译器(内部代号 KGEN)、工具链与标准库,./bazelw run --config=build-mojo KGEN:mojo -- run hello.mojo 即可从源码构建;
高通收购(7 月 29 日完成):Modular 并入高通,Mojo 的未来与高通在 AI 推理/边缘计算上的布局绑定。
对一个做编译器、GPU 加速、AI 芯片方向的人来说,Mojo 恰好横跨了这三件事:一门新语言(语法)、一个 MLIR 编译器(实现)、一个 AI 算力生态(目标)。本文先给语法一个"能跑"的速览,再深入编译器内部。
2. Mojo 是什么:一门"MLIR 的语法糖"
Mojo 由 Chris Lattner(LLVM 创始人、Swift 语言作者)和 Tim Davis 于 2022 年创立,定位是衔接 AI 研究与生产的桥梁语言:既要 Python 的易用性和生态(可以直接 import Python 包),又要 C/CUDA 级别的性能(无 GC、无解释开销、SIMD/GPU 直通)。
它的技术底座不是 LLVM,而是 MLIR(Multi-Level Intermediate Representation)——Lattner 在 Google 期间主导的编译器基础设施。Mojo 的编译器 KGEN 完全构建在 MLIR 之上,将语言语义拆成多层中间表示(dialect),逐层降低到 LLVM IR。fast.ai 的 Jeremy Howard 有一句广为流传的概括:
"Mojo 本质上是 MLIR 的语法糖。"
这句话点出了 Mojo 设计哲学的核心:把"写编译器"变成"写方言"。语言层面的每个特性(所有权、泛型、编译期求值)都对应 MLIR 中的具体操作,编译器不再是一个巨大的 AST 变换器,而是一组 MLIR pass。
早期 Mojo 宣称要做"Python 超集",但到 2026 年这一目标已被官方放弃/无限期搁置——它不兼容 Python 的类系统(用 struct 替代)、不兼容隐式类型、不兼容全局解释器语义。它更像一门"语法致敬 Python、语义融合 Rust + C++ 模板 + MLIR"的新语言:
| 维度 | Python | Mojo | C++ | Rust |
| 语法风格 | 缩进、动态 | 缩进、静态推断 | 大括号 | 大括号 |
| 类型系统 | 动态 | 静态强类型 + 推断 | 静态 + 模板 | 静态 + 泛型 |
| 内存管理 | GC | 所有权 + 借用(无 GC) | 手动 RAII | 所有权 + 借用 |
| 类/结构 | class | struct(值语义) | struct/class | struct |
| 泛型/元编程 | 无 | 参数特化 + comptime | 模板 | trait + 宏 |
| 编译方式 | 解释 | AOT 编译(也可 JIT) | AOT | AOT |
| 生态 | 极强 | 可 import Python | 强 | 强 |
| 性能定位 | 慢 | 接近 C/C++ | 快 | 快 |
3. 五分钟上手:pip 装好就能跑
2026 年的 Mojo 安装方式已经"Python 化":直接 pip install modular(或 conda/uv/pixi),装完自带 mojo CLI。本机实测版本:
$ pip install modular        # 装的是 modular 26.5.0,内含 mojo CLI
$ mojo --version
Mojo 1.0.0 (ed45d567)
第一个程序(本机实际编译运行,输出如下):
def main():
    print("Hello from Mojo!")
    var x: Int = 42
    var y = x * 2  # 类型推断
    print(t"x = {x}, y = {y}")
Hello from Mojo!
x = 42  y = 84
注意两处 1.0 的细节:入口函数统一叫 def main()(1.0 起 fn 关键字已彻底移除,全部用 def);字符串插值用的是 t-string(t"..."),不是 Python 的 f-string。mojo run hello.mojo 编译并执行,mojo build hello.mojo 生成原生可执行文件(AOT 编译)。
4. 语法速览:看着像 Python,处处是系统编程
Mojo 的语法刻意模仿 Python:缩进块、def、for i in range(n)、列表推导式,Python 开发者几乎零成本上手。但类型系统完全是系统编程那一套。下面这段代码演示了 1.0 的核心语法(已在本机编译运行):
# V2: 语法速览 —— 类型、控制流、t-string、容器
from std.collections import List, Dict

def classify(score: Int) -> String:
    if score >= 90:
        return "优秀"
    elif score >= 60:
        return "及格"
    else:
        return "不及格"

def main() raises:
    var x: Int = 42
    var y = 3.14          # Float64 推断

    var grade = classify(91)
    print(t"x = {x}, y = {y}, 成绩 = {grade}")
    print(t"表达式插值: x * 2 = {x * 2}, x > 40 = {x > 40}")

    var total = 0
    for i in range(5):
        total += i
    print(t"sum(0..4) = {total}")

    var lst = List[Int]([1, 2, 3])
    lst.append(4)
    print(t"list = {lst}, len = {len(lst)}")

    var d = Dict[String, Int]()
    d["a"] = 1
    d["b"] = 2
    print(t"dict['b'] = {d['b']}")
x = 42, y = 3.14, 成绩 = 优秀
表达式插值: x * 2 = 84, x > 40 = True
sum(0..4) = 10
list = [1, 2, 3, 4], len = 4
dict['b'] = 2
要点拆解:
var 显式声明:1.0 中隐式声明(x = 42 不写 var)仍兼容但已标记废弃,编译器会警告;
raises 注解:Mojo 函数默认"不可抛出异常",调用可能失败的函数(如 d['b'] 键不存在)必须用 try 或声明 raises 向上传播;
类型标注:score: Int -> String,静态强类型,但支持推断;
List/Dict 是值语义容器:List[Int]([1, 2, 3]) 构造(注意 1.0 起必须用方括号字面量,旧式 List[Int](1, 2, 3) 已移除);
SIMD 是语言内置类型:SIMD[DType.float32, 4] 直接表达向量,见第 6、7 节。
1.0 的破坏性语法变化(老教程全失效)
Mojo 从 2023 公开到 1.0,语法经历了大量"推倒重来",网上 90% 的旧教程代码在 1.0 下编译不过。以下变化均为本机实测确认:
| 旧语法(2023-2025) | Mojo 1.0 | 说明 |
fn foo() -> Int | def foo() -> Int | fn 已移除,全部用 def |
inout self / inout p | mut self / mut p | 可变引用关键字改名 |
f"..." f-string | t"..." t-string | 返回 TString,需显式转 String |
let x = 1 | (移除) | 2024 年即删除 |
隐式 x = 1 声明 | var x = 1 | 隐式声明废弃,编译警告 |
DType.f32 | DType.float32 | 枚举成员改名 |
@parameter 装饰器 | comptime 关键字 | 见第 6 节 |
List[Int](1, 2, 3) | List[Int]([1, 2, 3]) | 列表字面量需方括号 |
from collections import ... | from std.collections import ... | stdlib 目录重组 |
5. 所有权系统:没有 GC,也能内存安全
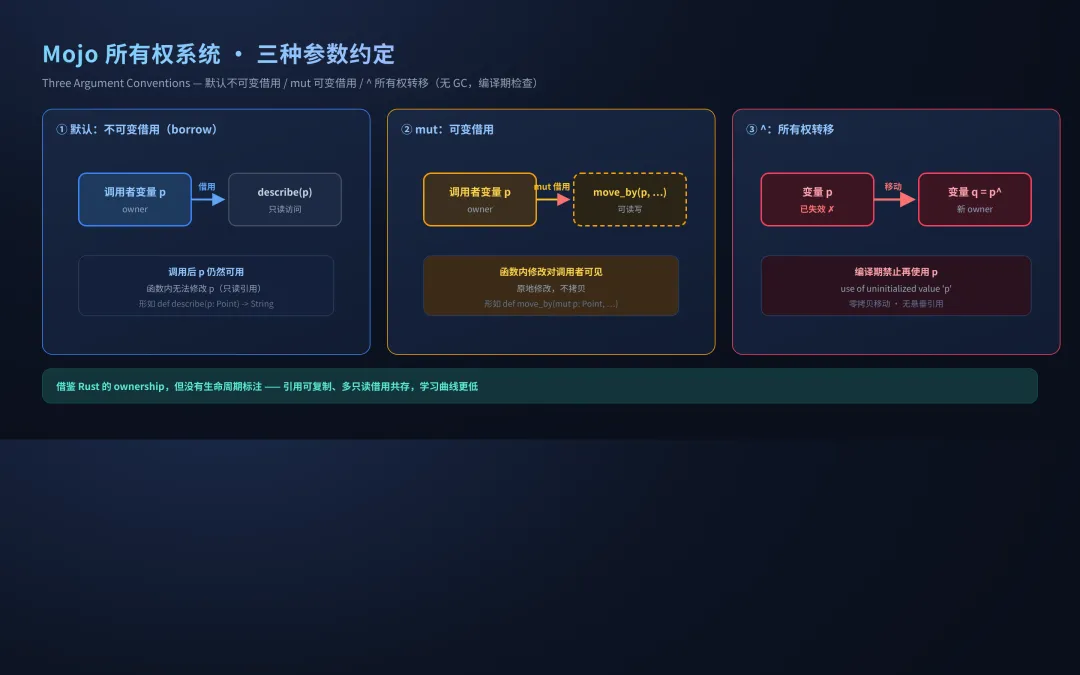
Mojo 的内存管理借鉴 Rust 的"所有权 + 借用"模型,但去掉了 Rust 中最难学的部分(生命周期标注),改用更宽松的约定。核心是三条:
1. 默认不可变借用(borrow):函数参数默认是只读引用,调用者不受影响;
2. mut 可变借用:加 mut 关键字可以原地修改调用者的对象;
3. ^ 所有权转移:把一个变量的值"移动"给另一个变量,原变量失效。
# V3: 所有权系统 —— 借用、mut、转移(^)
from std.collections import List

struct Point:
    var x: Int
    var y: Int

    def __init__(out self, x: Int, y: Int):   # out self: 构造器
        self.x = x
        self.y = y

    def norm2(self) -> Int:                    # self: 只读方法
        return self.x * self.x + self.y * self.y

    def scale(mut self, k: Int):               # mut self: 可变方法
        self.x *= k
        self.y *= k

def describe(p: Point) -> String:              # 参数默认不可变借用
    return String(t"Point({p.x}, {p.y})")

def move_by(mut p: Point, dx: Int, dy: Int):   # mut: 可变借用
    p.x += dx
    p.y += dy

def main():
    var p = Point(3, 4)
    print(t"初始: {describe(p)}")               # 借用,p 仍可用
    move_by(p, 1, 1)                            # 原地修改
    p.scale(2)
    print(t"move_by+scale 后: {describe(p)}")

    var q = p^                                  # 转移所有权
    print(t"转移后 q = {describe(q)}")
    # print(describe(p))  # ❌ 编译错误: use of uninitialized value 'p'

    var a = List[Int]([1, 2, 3])
    var b = a.copy()                            # 显式拷贝
    b.append(99)
    print(t"a = {a}, b = {b}")

    var c = a^                                  # 转移
    print(t"c = {c}")
    # print(len(a))     # ❌ 编译错误: 转移后原变量彻底不可用
初始: Point(3, 4)
move_by+scale 后: Point(8, 10)
转移后 q = Point(8, 10)
a = [1, 2, 3], b = [1, 2, 3, 99]
c = [1, 2, 3]
三个值得强调的设计:
struct 不是类:Mojo 的 struct 是编译期确定布局的值类型,支持方法、运算符重载、trait(Copyable、Movable、Stringable 等),但没有继承,也没有 Python 类的动态特性;
转移后变量编译期禁用:p^ 之后再用 p 直接编译报错(use of uninitialized value),编译器静态保证没有悬垂引用——这与 Rust 的"move 后禁止使用"一致;
拷贝要显式:1.0 起 List 不再隐式拷贝(var b = a 编译报错),必须 a.copy()。这是刻意的设计:把"昂贵的隐式拷贝"变成显式,避免 Python 式的大对象意外复制。
对比 Rust:Mojo 没有生命周期标注,借用检查更宽松(引用允许复制、允许同时存在多个只读借用),学习曲线低得多,代价是某些 Rust 能静态保证的约束需要运行时检查。
6. 元编程:编译期求值是语言核心
Mojo 的杀手锏是"参数(parameter)"机制:函数和结构体可以带编译期参数(方括号 []),编译器在编译时按参数值特化(specialize)出具体版本——类似 C++ 模板实例化,但语义更强。配合 comptime 关键字,可以实现编译期循环展开、编译期分支、编译期求值:
# V4: 元编程 —— 编译期参数 + comptime 求值
# 编译期参数 [count: Int]:count 在编译时确定,函数按 count 特化
def repeat[count: Int](msg: String):
    # comptime for:循环在编译期完全展开,零运行时开销
    comptime for i in range(count):
        print(t"{i}: {msg}")

def dot_product[N: Int](a: SIMD[DType.float32, N],
                        b: SIMD[DType.float32, N]) -> Float32:
    var acc = a[0] * b[0]
    comptime for i in range(1, N):
        acc += a[i] * b[i]
    return acc

def main():
    print("== comptime for 展开(编译期生成 4 条 print)==")
    repeat[4]("hello")

    print("== N=4 时循环完全展开 ==")
    var a = SIMD[DType.float32, 4](1.0, 2.0, 3.0, 4.0)
    var b = SIMD[DType.float32, 4](5.0, 6.0, 7.0, 8.0)
    print(t"dot(a, b) = {dot_product[4](a, b)}")
== comptime for 展开(编译期生成 4 条 print)==
0: hello
1: hello
2: hello
3: hello
== N=4 时循环完全展开 ==
dot(a, b) = 70.0
这里 repeat[4]("hello") 在编译期把循环展开成 4 条连续的 print 语句——生成的 LLVM IR 里函数名直接是 repeat[...,count=4],证明特化真实发生(见第 8 节)。dot_product[N] 中的 comptime for 让点积累加在编译期展开,避免了运行时循环开销,同时保留 SIMD 向量类型 SIMD[DType.float32, 4]——这是 Mojo 对标 CUDA 内联向量编程的核心能力。
与 C++ 模板的对比:
| 能力 | C++ 模板 | Mojo 参数 |
| 类型特化 | template | [T: AnyType] |
| 值特化 | template | [N: Int] |
| 编译期分支 | if constexpr | comptime if |
| 编译期循环 | 模板递归(难读) | comptime for(直观) |
| 编译期执行函数 | constexpr(受限) | comptime 函数(解释器执行) |
Mojo 的参数系统把 C++ 模板里"需要模板元编程技巧才能做的事"变成了普通语法。
7. 性能实测:同样的算法,快 80~220 倍
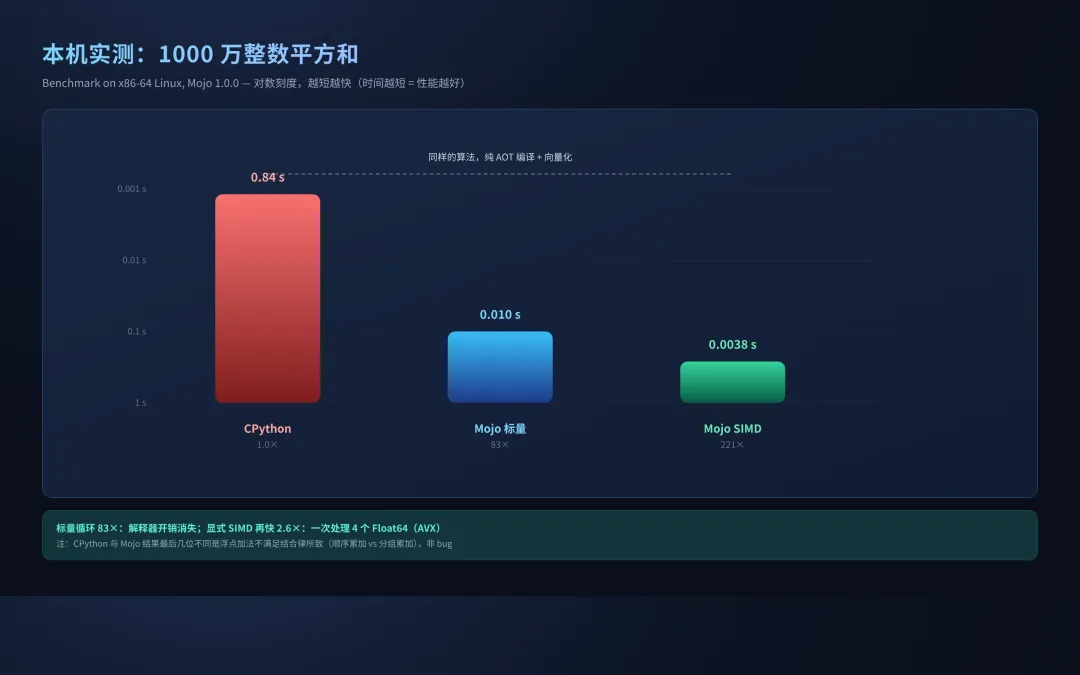
语法和概念讲完了,直接上数据。写一个"前 1000 万整数平方和"的基准,用三种方式实现:CPython 纯循环、Mojo 标量循环、Mojo 显式 SIMD。代码在同一程序里通过 Mojo 的 Python 互操作调用 CPython(顺便演示互操作能力),本机(x86-64 Linux)实测:
# V5: 性能对比 —— Mojo 标量 / SIMD vs CPython(含 Python 互操作)
from std.python import Python
from std.time import perf_counter

def sum_squares_scalar(n: Int) -> Float64:
    var total: Float64 = 0.0
    for i in range(n):
        total += Float64(i * i)
    return total

def sum_squares_simd(n: Int) -> Float64:
    var total = SIMD[DType.float64, 4](0.0)
    var vec_n = (n // 4) * 4
    for i in range(0, vec_n, 4):          # 4 路向量累加
        var v = SIMD[DType.float64, 4](
            Float64(i * i), Float64((i + 1) * (i + 1)),
            Float64((i + 2) * (i + 2)), Float64((i + 3) * (i + 3)),
        )
        total += v
    var sum4 = total.reduce_add()
    for j in range(vec_n, n):             # 余数收尾
        sum4 += Float64(j * j)
    return sum4

def main() raises:
    var n = 10_000_000
    # CPython 基准:通过 Mojo 的 Python 互操作调用
    var module = Python.evaluate("""
def sum_sq_py(n):
    total = 0.0
    for i in range(n):
        total += i * i
    return total
""", file=True)
    var sum_sq_py = module.sum_sq_py

    var t0 = perf_counter()
    var r_py = Float64(py=sum_sq_py(n))
    var t1 = perf_counter()
    var t2 = perf_counter()
    var r_scalar = sum_squares_scalar(n)
    var t3 = perf_counter()
    var t4 = perf_counter()
    var r_simd = sum_squares_simd(n)
    var t5 = perf_counter()

    print(t"CPython  : {r_py}  耗时 {t1 - t0} s")
    print(t"Mojo标量 : {r_scalar}  耗时 {t3 - t2} s")
    print(t"Mojo SIMD: {r_simd}  耗时 {t5 - t4} s")
    print(t"标量加速比 = {(t1 - t0) / (t3 - t2)}x")
    print(t"SIMD加速比 = {(t1 - t0) / (t5 - t4)}x")
CPython  : 3.333332833337171e+20  耗时 0.84 s
Mojo标量 : 3.333332833337171e+20  耗时 0.010 s
Mojo SIMD: 3.3333328333347134e+20  耗时 0.0038 s
标量加速比 = 83x
SIMD加速比 = 221x
三点解读:
标量循环 83 倍:纯 AOT 编译 + LLVM 优化,无需任何手写优化。CPython 的 0.84 秒几乎全花在解释器开销(整数对象、字节码循环)上;
显式 SIMD 再快 2.6 倍(221 倍 vs 83 倍):SIMD[DType.float64, 4] 编译成 AVX 指令,一次处理 4 个元素。值得注意的是 LLVM 对简单标量循环也会自动向量化,所以差距没有想象中大——手动 SIMD 的价值在复杂访存模式(跨步访问、数据布局转换)下才会完全显现;
浮点结果最后几位不同:标量顺序累加 vs SIMD 分组累加,浮点加法不满足结合律,这是正常现象,不是 bug。
8. 编译器实现逻辑:没有 AST 的 MLIR 编译器
这是本文的核心章节。Mojo 编译器内部代号 KGEN(Kernel Generator),2026 年 8 月开源后位于 modular/modular 仓库的 KGEN/ 目录。官方文档(KGEN/docs/MojoCompilerWalkthrough.md)明确写道:
"Mojo 编译器完全构建在 MLIR 之上。与传统编译器'AST → IR → 机器码'的清晰分界不同,Mojo 用 MLIR 方言(dialect)在不同抽象层次表示代码,全部处于同一个框架内。"
8.1 核心设计:没有传统 AST
绝大多数编译器(GCC、Clang、rustc)的第一步是构建抽象语法树(AST),再做语义分析、生成 IR。KGEN 跳过了 AST:解析器在词法分析后直接向 MLIR 的 lit 方言发射操作(operation),lit 就是"源码级 IR"——它既是 AST 的替代品,又是后续所有优化的起点。
解析采用三阶段惰性策略处理前向引用(无需显式前置声明):
1. 名字解析:先扫描所有声明,注册名字(不解析内容);
2. 签名解析:解析函数/结构体的签名与参数类型;
3. 体解析:最后才解析函数体。
这让"函数 A 在函数 B 之后定义、B 调用 A"这类前向引用天然成立,也支撑了编译期参数的按需解析。
8.2 六阶段编译管线
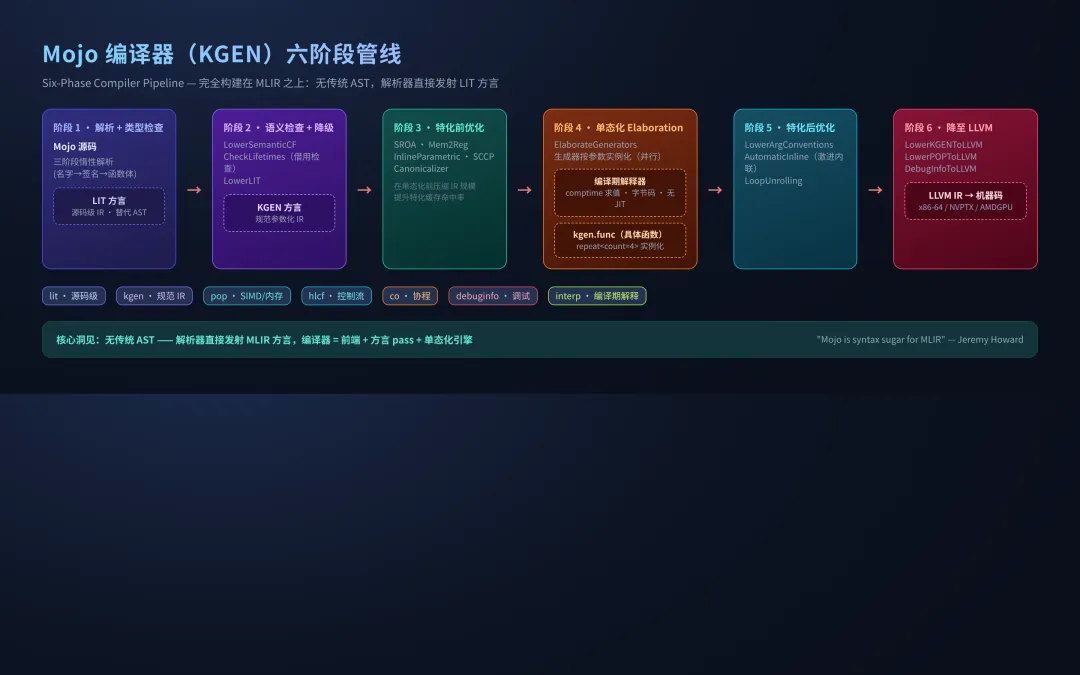
| 阶段 | 输入 → 输出 | 关键 pass / 机制 |
| 1. 解析 + 类型检查 | Mojo 源码 → LIT 方言 | 三阶段惰性解析;无传统 AST |
| 2. 语义检查 + LIT 降级 | LIT → KGEN 方言 | LowerSemanticCF(控制流)、CheckLifetimes(借用检查,插入析构调用、拒绝 use-after-free)、LowerLIT |
| 3. 特化前优化 | KGEN(参数化) | SROA、Mem2Reg、Canonicalizer、InlineParametric、SCCP(稀疏常量传播)——在单态化前压缩 IR 规模 |
| 4. 单态化(Elaboration) | 参数化 KGEN → 具体化 kgen.func | ElaborateGenerators:按参数值实例化所有"生成器"(函数模板/结构模板),并行执行,编译期代码由内置解释器求值 |
| 5. 特化后降级 + 优化 | 具体 KGEN → 优化 KGEN | LowerArgConventions/LowerCallingConventions(调用约定)、AutomaticInline(激进内联)、LoopUnrolling、DeadArgumentElimination |
| 6. 降至 LLVM | KGEN/POP → LLVM 方言 → LLVM IR → 机器码 | LowerKGENToLLVM、LowerPOPToLLVM、LowerControlFlow、DebugInfoToLLVM |
关键概念逐个解释:
① 方言(Dialect)分层。Mojo 自研了 7 个方言,加上上游 MLIR/LLVM 方言,构成完整流水线:
| 方言 | 作用 | 何时消失 |
lit | 源码级 IR(函数/调用/引用/结构/特质声明) | 阶段 2(LowerLIT) |
kgen | 规范参数化 IR(生成器/具体函数) | 阶段 4 后只剩具体化操作 |
pop | 参数化 SIMD/内存操作(add/load/store/splat) | 阶段 4 后具体化 |
hlcf | 高层结构化控制流(if/for/while/break) | 阶段 6(降至 CFG) |
co | 协程/异步 | 阶段 6 |
debuginfo | 调试信息(源码位置、变量追踪) | 阶段 6(降至 DWARF) |
interp | 编译期解释器操作 | 阶段 6 |
② 生成器(Generator)与单态化。"生成器"指带编译期参数的函数模板(kgen.generator)和结构模板(kgen.struct.generator)。阶段 4 的 ElaborateGenerators 把每个生成器按参数值实例化:参数替换、编译期求值、静态断言检查。输出的 kgen.func 就是"具体函数"——第 6 节里 repeat[count=4] 在 LLVM IR 中的函数名 repeat[...,count=4] 正是单态化的直接证据。与 C++ 模板实例化最大的不同:KGEN 的单态化是并行的,独立实例化并发处理,且带缓存(相同参数组合只实例化一次)。
③ 编译期解释器。comptime 代码(comptime for、编译期函数调用、参数表达式)由 KGEN 内置的解释器执行:MLIR 操作通过 fold hooks 求值,函数被"编译"成字节码(FunctionIRBytecode)高效求值,解释器维护虚拟地址空间模拟内存读写,支持完整的 if/for/while/函数调用。好处是不需要 JIT——在禁止 JIT 的环境(iOS、嵌入式)也能完成编译期求值。
④ .mojoc 预编译包。mojo precompile my_package/ 生成 .mojoc 文件——本质是 MLIR 字节码(lit.package 操作序列化),只做阶段 1-2(解析 + 语义检查),不做单态化。导入时惰性加载、按需物化函数体,从而获得接近"头文件 + 模板库"的编译速度。这也解释了为什么 Mojo 的包系统像 Python:__init__.mojo 是包的公共接口,子模块默认不可见。
⑤ 参数化调试信息。KGEN 用专门的 debuginfo 方言跟踪调试信息,且调试信息本身是"参数化"的:单态化前局部变量的调试类型可以是 !debuginfo.unresolved>(包含参数引用),单态化时随参数一起实例化,逐级降低到具体类型。调试体验与模板代码的展开天然对齐。
8.3 为什么选 MLIR 而不是直接 LLVM
Lattner 在 2022 年的 KGEN 设计文档(KGEN/docs/DesignOverview.md)里说得很直白:传统 kernel 库(TensorFlow/PyTorch 的算子库)有数千个算子,换一个新硬件就要全部重调优;XLA 只覆盖稠密线性代数且算子集封闭;TVM 编译慢、性能不可预测、对现代空间架构支持差。MLIR 的"多层方言"模型让 Mojo 可以:
高层方言直接表达语言语义(lit/kgen),优化 pass 可以在语言层面运行(如编译期展开、特化);
利用 MLIR 生态:共享 Canonicalizer、SROA、Mem2Reg 等数百个经过验证的 pass;
多后端:LLVM(CPU)、NVVM(NVIDIA GPU)、ROCDL(AMD GPU),未来可加任意新后端(TPU、ASIC)。
一句话总结:Mojo 编译器 = 一个把 Mojo 语法翻译成 MLIR 方言的前端 + 一组在方言上运行的优化 pass + 一个单态化引擎。这也是为什么 Jeremy Howard 说它是"MLIR 的语法糖"。
9. 生态、争议与学习路径
生态现状
GPU 编程:标准库的 gpu 包支持在 Mojo 中直接写 GPU kernel(对标 CUDA)。2025 年橡树岭国家实验室(ORNL)在 SC25 WACCPD 研讨会发表的研究表明:Mojo 的 GPU kernel 在显存带宽受限负载上与 CUDA/HIP 基本持平(NVIDIA 和 AMD 平台),仅在原子操作和部分 AMD 计算密集型负载上有差距——对一个发布两年的新语言,这是相当强的信号;
MAX 框架:Modular 的 MAX(Mojo 之上构建的 AI 推理框架)已经可以端到端跑 Llama 等模型,pip install modular 一条命令全搞定;
开源路线图:编译器目前暂不接受社区贡献(官方计划 2026 年底前开放),标准库自 2024 年起接受贡献。
争议与批评
"Python 超集"落空:早期宣传的 Python 兼容性被大幅缩减,官方最终承认不是超集。对期待"无缝迁移"的 Python 开发者来说这是最大失望点;
1.0 破坏性变更:fn 移除、inout→mut、f-string→t-string 等变更让大量旧教程失效(本文第 4 节表格已列出);
语法糖还是新语言? 批评者认为 Mojo 的独特价值(编译期求值、所有权)在 Rust/C++ 中都有对应物,MLIR 底座对普通开发者不可见——"少了一个必须存在的理由"。
学习路径
| 层次 | 内容 | 入口 |
| 1. 语言基础 | 手册的 Basics / Values / Functions / Structs | mojolang.org/docs/manual/ |
| 2. 所有权 | Value ownership 章节(生命周期、借用、转移) | manual/values/ownership |
| 3. 元编程 | Parameters / Comptime evaluation / Traits | manual/metaprogramming/ |
| 4. 编译原理 | 编译器 walkthrough + KGEN 源码 | 仓库 KGEN/docs/MojoCompilerWalkthrough.md |
| 5. MLIR 底层 | MLIR 官方教程(方言、pass 编写) | mlir.llvm.org |
| 6. GPU/MAX | GPU 编程教程、MAX 推理部署 | max.modular.com/gpu/ |
如果只读一个文件,读 KGEN/docs/MojoCompilerWalkthrough.md——这份为编译器新人写的指南把 KGEN 的每一阶段、每个 pass、每个目录都讲清楚了,是理解"MLIR 编译器"的最佳入门材料。
总结:Mojo 的语法是 Python 的皮,语义是 Rust + C++ 模板的骨,编译器是 MLIR 的魂。它未必是"Python 超集",但作为"AI 时代的系统编程语言"候选者——语法亲民、性能接近原生、编译期元编程开箱即用、GPU 直通——加上高通入局和编译器开源,2026 年的 Mojo 值得每个做 AI 基础设施的人上手试一次。安装只需一条命令:
pip install modular && mojo run hello.mojo
 10个月宝宝每天需要喝多少奶粉?