当前位置:首页>python>python爬虫(正则+豆瓣top250)

python爬虫(正则+豆瓣top250)

  • 2026-09-07 18:59:35
python爬虫(正则+豆瓣top250)
现在,我们来利用python来尝试爬取豆瓣的榜单。
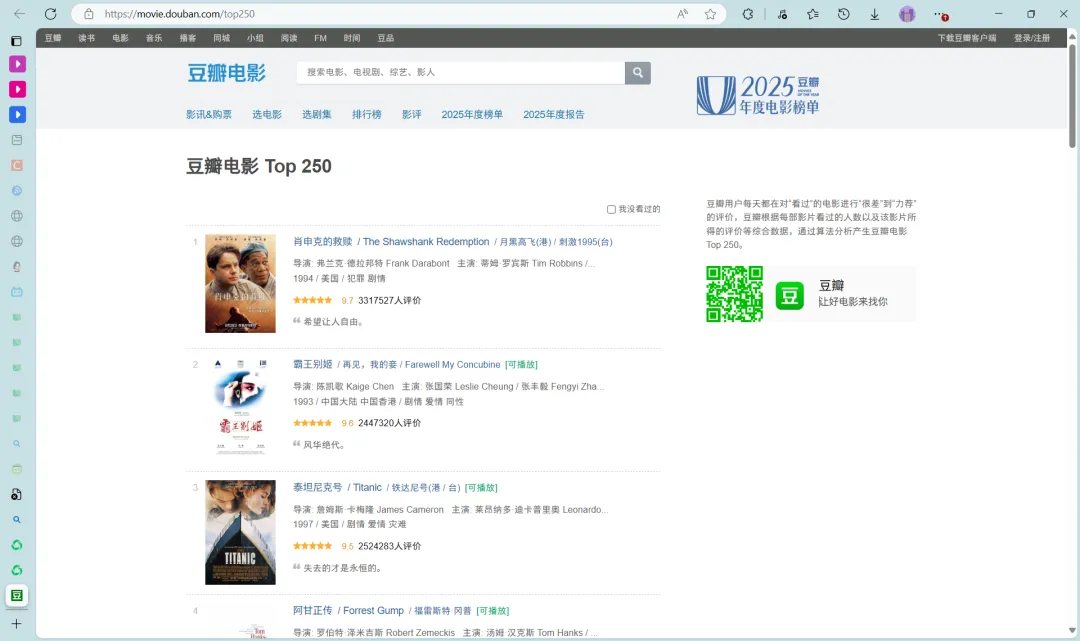
首先,我们找到豆瓣Top250的网址,如图所示:
可以发现,豆瓣Top250的网址为:
https://movie.douban.com/top250
接下来我们就可以开始写代码了。

代码部分
首先肯定是导入我们要用到的库,re、requests和csv。
import reimport requestsimport csv
我们来简单说明一下为什么要导入这些东西:
  • requests  →  请求网页,获取 HTML
  • re        →  用正则从 HTML 中提取电影信息
  • csv       →  将结果保存到 CSV 文件
接下来,我们可以写请求了:
url = "https://movie.douban.com/top250"headers = {"user-agent":"Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/138.0.0.0 Safari/537.36 Edg/138.0.0.0"}resp = requests.get(url,headers=headers)page_content = resp.text
在之前的文章里面有相关的写请求的内容,这里不再赘述。

查看源码,并针对其编写正则
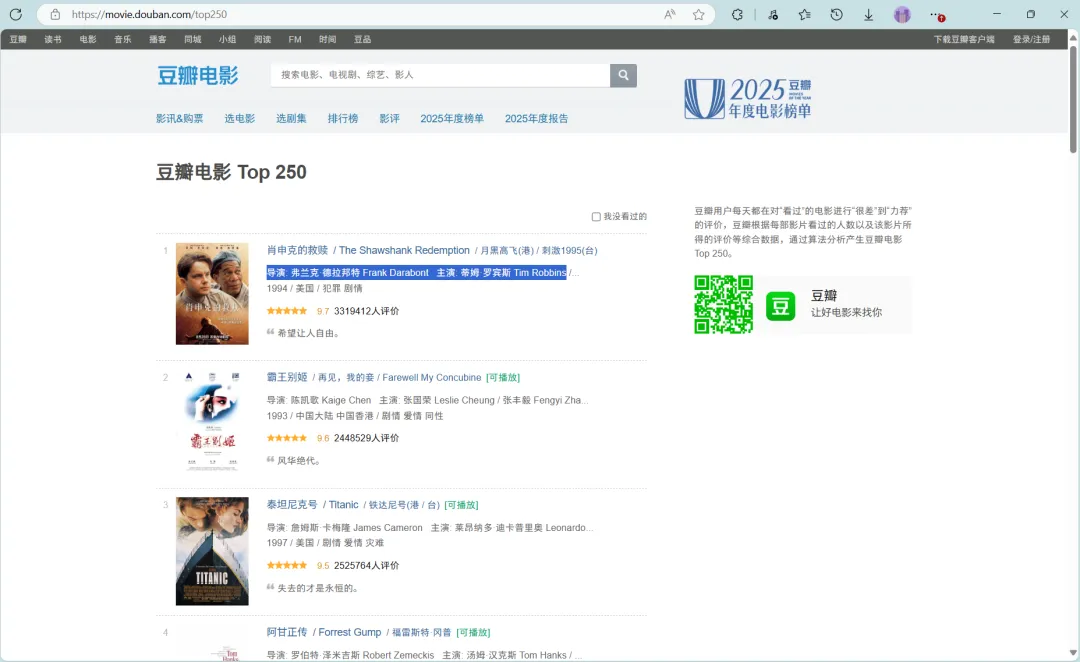
打开豆瓣Top的网址,按Ctrl+U查看其源码。再按Ctrl+F搜索源码,找到网页中出现的内容,我们需要据此来定位。
我们就按照导演(导演: 弗兰克·德拉邦特)来在源码中查找,可以看到我们成功在源码中找到相关的内容。
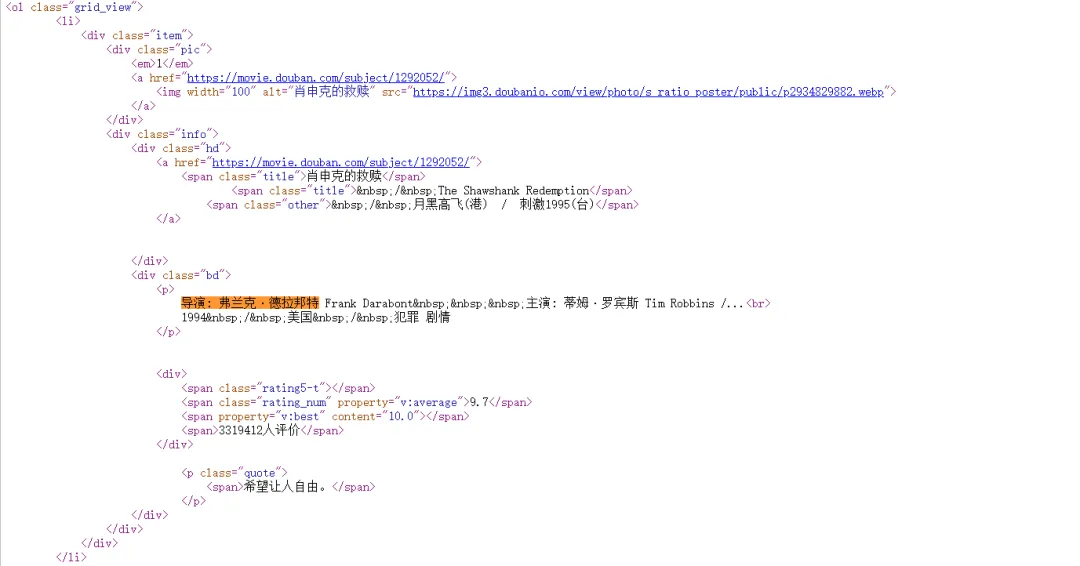
我们可以很容易的注意到这一段html代码的格式大致是这样的:
<li>  <divclass="item">    <divclass="hd">      <a>        <spanclass="title">肖申克的救赎</span>      </a>  </div>  <divclass="bd">    <p>      导演: 弗兰克·德拉邦特...<br>1994&nbsp...    </p>      <div>        <spanclass="rating5-t"></span>        <spanclass="rating_num"property="v:average">9.7</span>        <spanproperty="v:best"content="10.0"></span>        <span>3319412人评价</span>      </div>    </div>  </div></li>
据此,再根据我们的需求开始写我们的正则,假如现在我需要这个页面的电影的名称、发行年份、评分、以及评价人数,可以写出如下正则:
obj = re.compile(r'<li>.*?<div class="item">.*?<div class="pic">.*?<em>.*?</em>.*?<a href=".*?">.*?<img width="100" alt="(?P<name>.*?)" src=".*?">.*?</a>.*?</div>'                  r'.*?<div class="bd">.*?<p>.*?<br>.*?(?P<year>.*?)&nbsp;.*?</p>.*?'                  r'<span class="rating_num" property="v:average">(?P<score>.*?)</span>.*?'                  r'<span>(?P<vote>.*?)</span>',re.S)
原因如下:
  • 每一部电影数据都包裹在<li>标签内,开头锚定<li>;
  • .*? 非贪婪:尽可能少吃字符,防止一次性匹配跨到下一个 li 条目;如果写成.*贪婪,会把多条电影数据吞到同一个匹配结果。
  • .*?<em>.*?</em>:跳过 div 内部,吃掉排名 em 标签内容,不需要提取排名,只做定位锚点;
  • alt="(?P<name>.*?)" :alt属性里面正好是中文电影名称,使用命名捕获组(?P<name>.*?)把电影名字抓出来;
  • (?P<year>.*?)&nbsp; :br 之后,第一个&nbsp;前面就是电影年份1994;用&nbsp;做锚定分隔符,把年份捕获到year分组。
  • class+property 两个属性一起写,精准锚定评分标签,防止页面其他同名 span 干扰;
  • 网页源码有换行,普通.不能匹配换行符;加上re.S之后 . 可以匹配换行,否则遇到换行正则直接匹配不到任何结果。

正则写完我们就可以爬取页面内容,并存放到csv中了:
res = obj.finditer(page_content)f = open("data.csv",mode="w",encoding="utf-8",newline="")csv_writer = csv.writer(f)for it in res:    dic = it.groupdict()    dic['year'] = dic['year'].strip()    csv_writer.writerow(dic.values())print("over")
  • page_content:豆瓣网页的完整 HTML 字符串
  • finditer():正则迭代器,找到全部匹配项,返回迭代对象,不是列表。 循环的时候每一个 it 就是一条电影的匹配结果对象。
  • "data.csv":输出文件名
  • mode="w":覆盖写模式,每次运行程序,会清空旧的 data.csv,重新写入。
  • encoding="utf‑8":必须指定,防止中文乱码。
  • newline="":csv 模块专属参数,Windows 下如果不加,导出的 csv 会出现大量多余空行。
  • groupdict():正则命名分组专用方法,直接返回字典。
  • .strip() :去掉字符串前后空格、换行、空白字符
  • dic.values():取出字典里的值,得到
  • writerow(可迭代对象):把列表 / 元组,写成 csv 的一行,逗号自动分隔各个单元格。
完整源码附上:
import reimport requestsimport csvurl = "https://movie.douban.com/top250"headers = {"user-agent":"Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/138.0.0.0 Safari/537.36 Edg/138.0.0.0"}resp = requests.get(url,headers=headers)page_content = resp.textobj = re.compile(r'<li>.*?<div class="item">.*?<div class="pic">.*?<em>.*?</em>.*?<a href=".*?">.*?<img width="100" alt="(?P<name>.*?)" src=".*?">.*?</a>.*?</div>'                 r'.*?<div class="bd">.*?<p>.*?<br>.*?(?P<year>.*?)&nbsp;.*?</p>.*?'                 r'<span class="rating_num" property="v:average">(?P<score>.*?)</span>.*?'                 r'<span>(?P<vote>.*?)</span>',re.S)res = obj.finditer(page_content)f = open("data.csv",mode="w",encoding="utf-8",newline="")csv_writer = csv.writer(f)for it in res:    dic = it.groupdict()    dic['year'] = dic['year'].strip()    csv_writer.writerow(dic.values())print("over")
仅用于网络爬虫教学,请遵守Robots.txt爬虫协议,严禁用于非法途径。

最新文章

随机文章