python数据可视化技巧的100个练习 -- 55. 比较点图生成
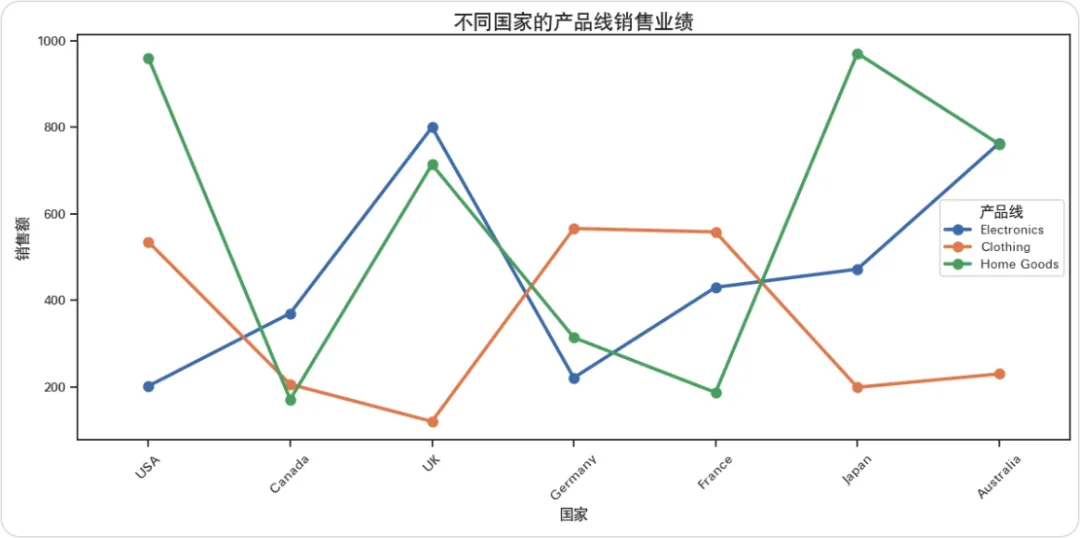
一家跨国公司的市场营销经理希望比较三条产品线在不同地区的销售业绩。你的任务是创建一个点图,以直观地表示这些比较数据。编写一个 Python 脚本,生成样本数据,并使用 seaborn 生成点图。该图表应清晰显示不同国家的每条产品线的销售业绩,便于进行比较。【数据生成代码示例】
import pandas as pdimport numpy as npnp.random.seed(42)countries = ['USA', 'Canada', 'UK', 'Germany', 'France', 'Japan', 'Australia']product_lines = ['Electronics', 'Clothing', 'Home Goods']data = [{'Country': country, 'Product Line': product, 'Sales': np.random.randint(100, 1000)} for country in countries for product in product_lines]df = pd.DataFrame(data)
【图表答案】
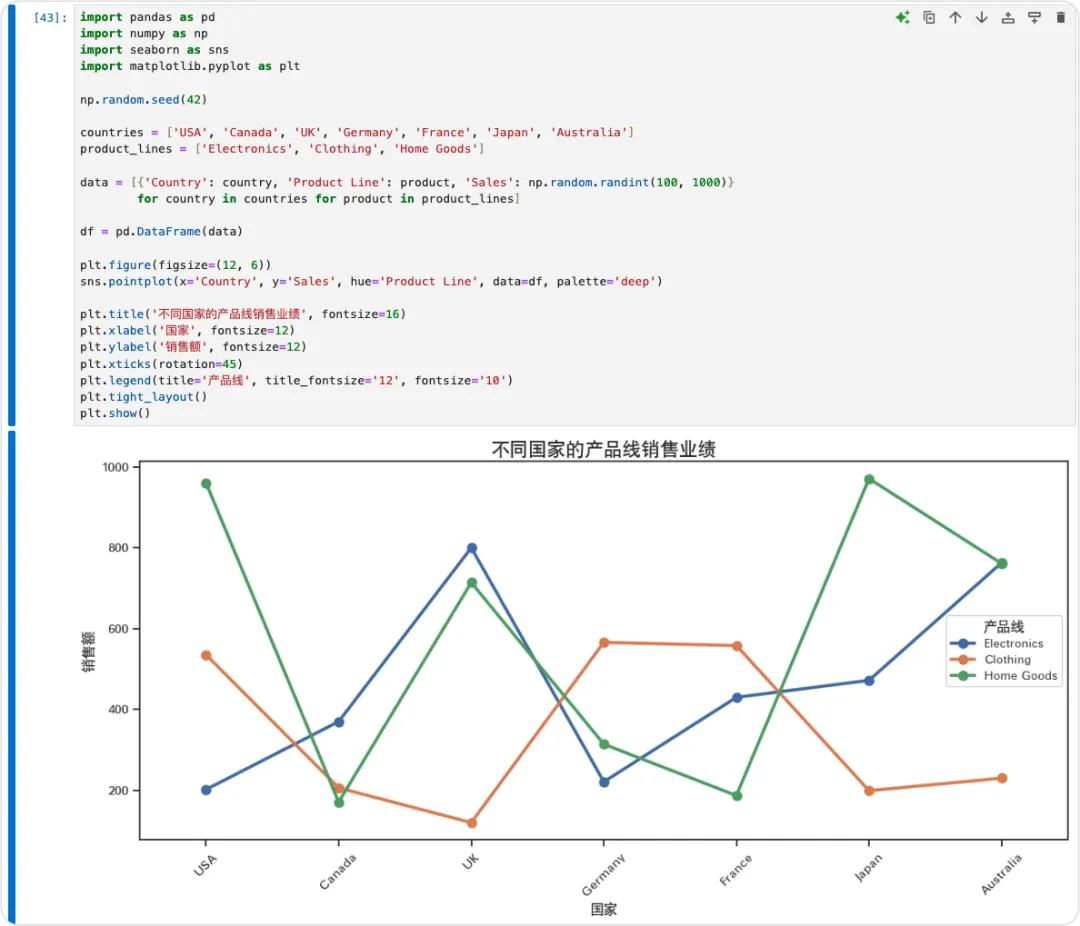
【代码答案】
import pandas as pdimport numpy as npimport seaborn as snsimport matplotlib.pyplot as pltnp.random.seed(42)countries = ['USA', 'Canada', 'UK', 'Germany', 'France', 'Japan', 'Australia']product_lines = ['Electronics', 'Clothing', 'Home Goods']data = [{'Country': country, 'Product Line': product, 'Sales': np.random.randint(100, 1000)} for country in countries for product in product_lines]df = pd.DataFrame(data)plt.figure(figsize=(12, 6))sns.pointplot(x='Country', y='Sales', hue='Product Line', data=df, palette='deep')plt.title('不同国家的产品线销售业绩', fontsize=16)plt.xlabel('国家', fontsize=12)plt.ylabel('销售额', fontsize=12)plt.xticks(rotation=45)plt.legend(title='产品线', title_fontsize='12', fontsize='10')plt.tight_layout()plt.show()
此代码创建了一个点图,用于比较不同产品线和国家的销售业绩。我们使用 NumPy 的随机数生成器创建样本销售数据。数据结构为一个字典列表,每个字典包含国家、产品线和销售额的信息。然后将此列表转换为 pandas DataFrame,便于操作。我们使用 matplotlib.pyplot 创建一个指定大小(12x6 英寸)的图形。使用 seaborn.pointplot 函数创建可视化。- hue='Product Line':通过颜色区分产品线
- data=df:包含我们数据的 DataFrame
- palette='deep':用于区分产品线的颜色方案
- 使用 plt.xlabel() 和 plt.ylabel() 添加 x 轴和 y 轴标签
- 使用 plt.xticks(rotation=45) 将 x 轴标签(国家名称)旋转 45 度,以提高可读性
- 使用 plt.tight_layout() 自动调整图表布局
此代码展示了 Python 数据可视化中的几个重要方面:- 使用 matplotlib 自定义图表,以提高清晰度和美观性
这种类型的可视化特别适用于比较多个类别和子组的分类数据,非常适合此场景中市场营销经理的需求。【小知识】
Seaborn 基于 matplotlib 构建,提供了一个高级接口,用于绘制美观的统计图表。点图非常适合展示不同分类变量水平的数值变量的集中趋势(如均值或中位数)。在点图中,点表示每个 x 类别的 y 变量的均值,而误差条通常表示 95% 置信区间。Seaborn 中的 “deep” 颜色方案旨在方便色盲人士使用,使你的可视化更具可访问性。当处理长类别名称或许多类别时,旋转 x 轴标签是一种常见的技术,可防止重叠。Matplotlib 中的 tight_layout() 函数会自动调整子图参数以提供指定的填充。当你有标题、标签或其他可能重叠的元素时,这特别有用。Seaborn 与 pandas 数据结构紧密集成,便于直接从 DataFrame 绘图。在处理真实世界数据时,通常需要在创建可视化之前处理缺失值或异常值。Pandas 提供了各种方法,例如 dropna() 用于删除包含缺失数据的行,或 fillna() 用于填充缺失值。
系列完整内容可以在公众号主页搜索或点击分栏找到,欢迎扫码关注预防迷路找不到。感谢您的支持与相伴。