当前位置:首页>java>都说Vibe Coding不看代码,让AI写C或汇编行不行?结论有点残酷

都说Vibe Coding不看代码,让AI写C或汇编行不行?结论有点残酷

  • 2026-10-21 13:29:34
都说Vibe Coding不看代码,让AI写C或汇编行不行?结论有点残酷
这两年,Vibe Coding逐渐成了一个被反复提及的词:
不盯实现细节、不给精确指令、让AI在高层语义里“自己把代码跑出来”。
于是一个看似犀利、实则非常值得认真讨论的问题出现了:

既然都不需要人盯代码了,那为什么不干脆一步到位,让AI直接写C/汇编?

这个问题并不幼稚。恰恰相反,它精准击中了Vibe Coding的理论边界。
要回答它,我们必须把两件事分清楚:
Vibe Coding到底在“省”什么?又在“押注”什么?

 01 

先纠正一个误解
Vibe Coding ≠ 不需要人
Vibe Coding从来不是“没人看代码”,而是:

人不再负责“指令级正确性”,而只对“意图级正确性”负责。

换句话说,人不再逐行检查for循环、内存分配、类型细节,而是只判断一件事:

这个系统的行为,是否符合我想要的那个世界?

这意味着什么?
意味着错误不可避免,但必须满足一个前提:
错误要集中在“逻辑层”,而不是“物理层”。
而这,正是C和汇编被排除的根本原因。

 02 

从理论上看
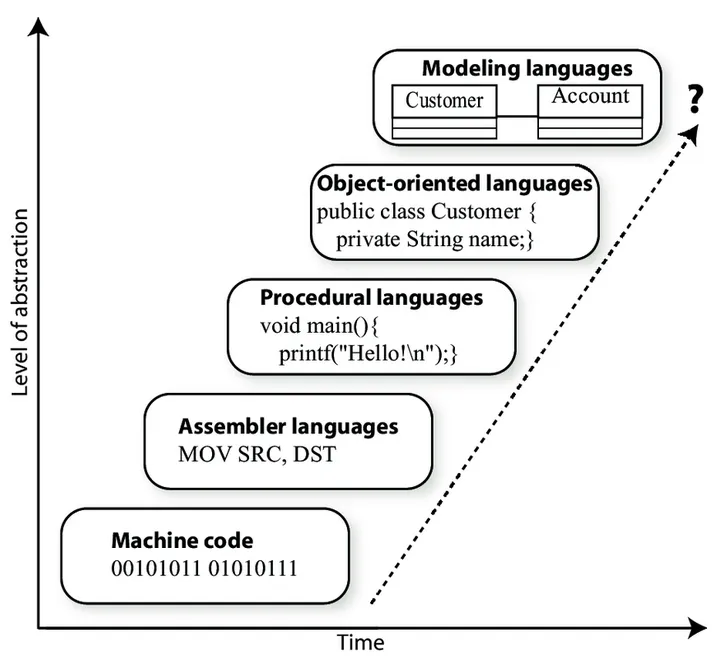
抽象层级决定了“Vibe是否成立”
我们先看一个核心判断标准:

Vibe Coding成立的前提,是“意图 → 行为”的映射可以被反复重写,而不会引入不可诊断的风险。

这背后,其实是一个经典的计算机科学问题:
抽象边界在哪里?

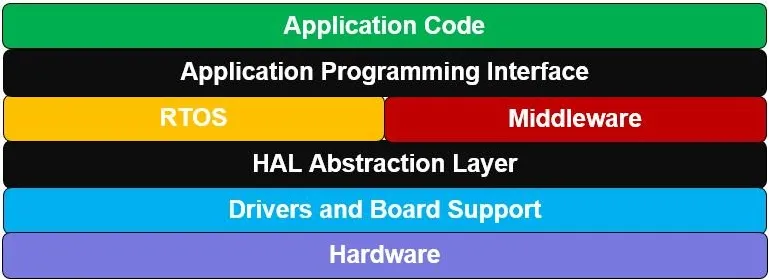
汇编的问题:没有“意图层”

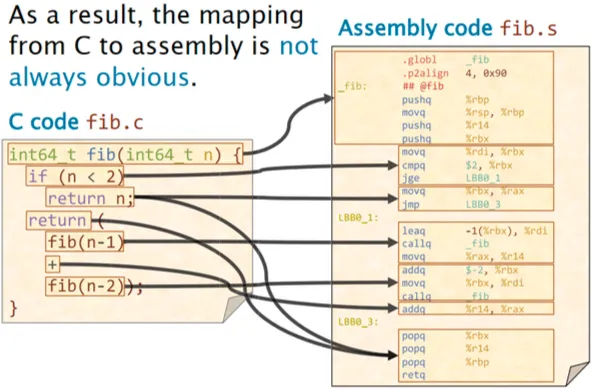
汇编代码表达的不是“我要做什么”,而是:
CPU寄存器此刻放什么
下一条指令跳到哪里
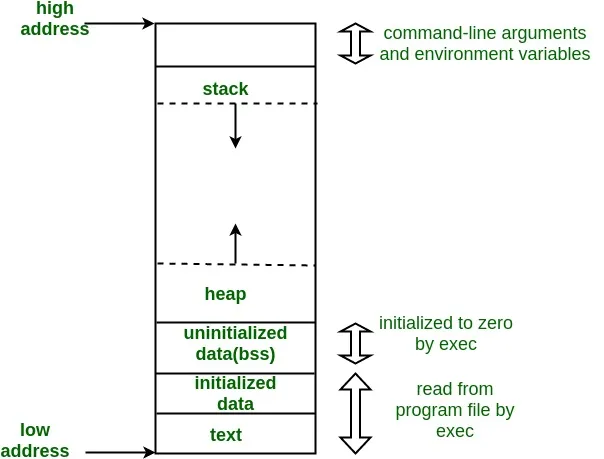
栈如何增长、如何回收
这是一种完全展开的世界观。
在这种语言里:
一行代码 = 一个“物理动作”
根本不存在“可被重写的意图空间”
这意味着什么?
意味着你一旦让AI自动生成汇编,
你就要求它永远不犯硬件级错误。
这不是Vibe Coding,这是在赌宇宙常数不变。

C的问题:卡在最危险的中间层

C常被称为“高级汇编”,这句话是褒义,也是诅咒。
从抽象层级看,C处在一个非常尴尬的位置:
对机器来说:它不够直接,仍要编译器猜意图
对人来说:它不够安全,隐藏大量未定义行为
C的正确性依赖三件事:
程序员的隐性约定
平台与ABI的细节
对“哪些事不能做”的经验直觉
而Vibe Coding的前提恰恰是:
允许反复试错、反复重写、反复“改着玩”。
这在C里是灾难性的。

 03 

从工程上看
错误类型决定了“是否敢自动化”
工程不是哲学,工程只问一句话:

当系统错了,你能不能快速定位“错在了哪一层”?

我们直接对比三种语言在真实开发中的失败形态。

高层语言(Python/TypeScript/Rust高层用法)

错误集中在:逻辑、状态、边界条件
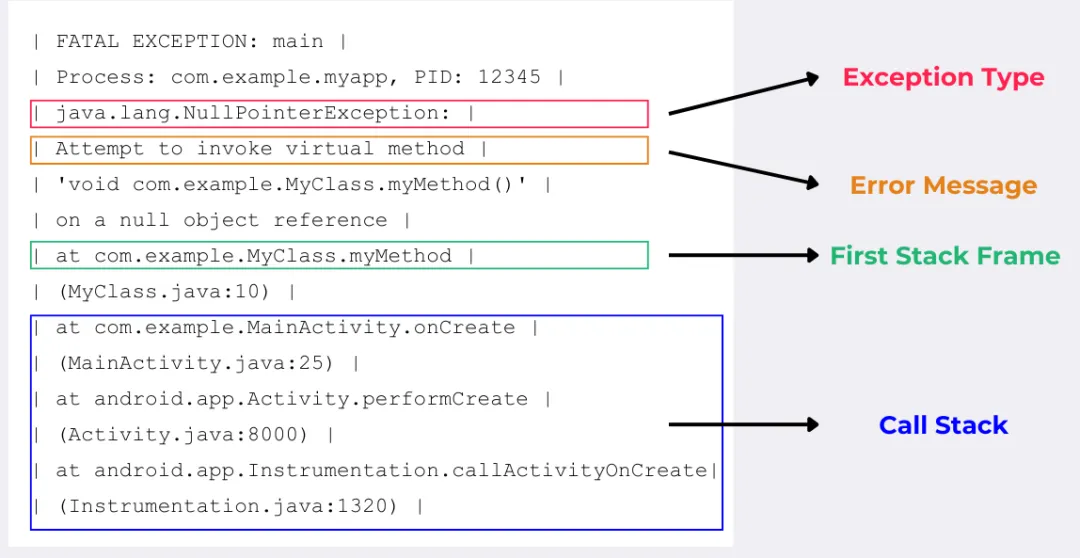
症状:异常、日志、断言失败
特点:失败是可观测的

C/汇编

错误集中在:内存、生命周期、时序
症状:
特点:失败是延迟的、不可复现的
而Vibe Coding需要的恰恰是:

失败要足够“吵”,才能被AI+人类一起修正。

Silent corruption(静默损坏)是Vibe的天敌。

 04 

为什么“完全不用人看”时
反而更不能用底层语言?
这里有一个非常反直觉、但极其重要的结论:

越是“没人盯”,语言就越不能接近机器。

原因很简单:
高层语言出错 → 世界模型错了
底层语言出错 → 世界本身被破坏了
前者还能修,后者已经不知道从哪里开始怀疑。
这也是为什么在现实工程中:
AI自动生成的代码,更适合放在解释型或强约束语言里
而不是放在“信任人类克制力”的语言里
所以,问题并不是:

为什么Vibe Coding不写C或汇编?

而是:

当编程从“写指令”变成“塑造行为”,语言就必须站在人类这一侧,而不是机器那一侧。

C和汇编不会消失,它们依然是:
性能极限
硬件接口
操作系统内核
编译器与运行时的基石
但它们属于精密手工艺,不是自动化生产线。

Vibe Coding的本质不是“偷懒”,而是一次角色分工的重排:

人类:负责世界观、目标、边界
AI:负责在高层语义空间里反复试错
而C与汇编,恰恰要求你永远对细节负责。
把它们强行拉进Vibe Coding,
就像让自动驾驶系统用纯机械连杆转向——
不是不能动,而是方向完全错了。
编程语言并不只是工具,它们隐含着对错误、责任与不确定性的态度。

而Vibe Coding,选择的是那种:
允许失败、鼓励重写、并且能被理解的世界。
这不是技术趋势,这是抽象的必然结果。

最新文章

随机文章