Python实战系列<六> | 自动提取考试题库中的题目及答案(word文档处理)
- 2026-10-21 13:30:33
点击上方"蓝字",关注"Python当打之年"
大家好,我是欧K~
第 2 期:【Python实战系列<二> | 70万+条表格信息标记】
提取word文档中的题目,选项,答案,并生成excel文档。
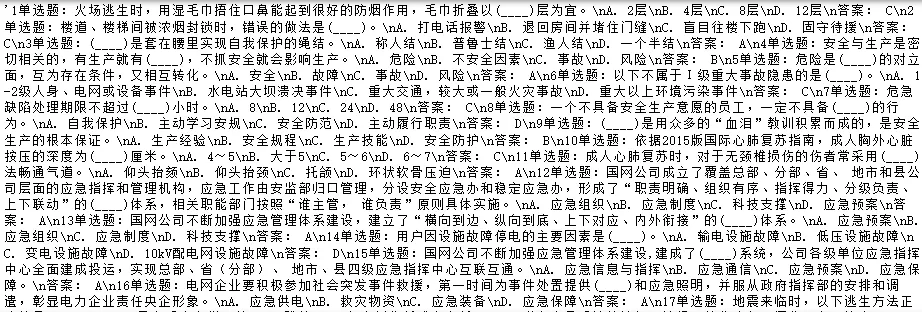
文件内容:
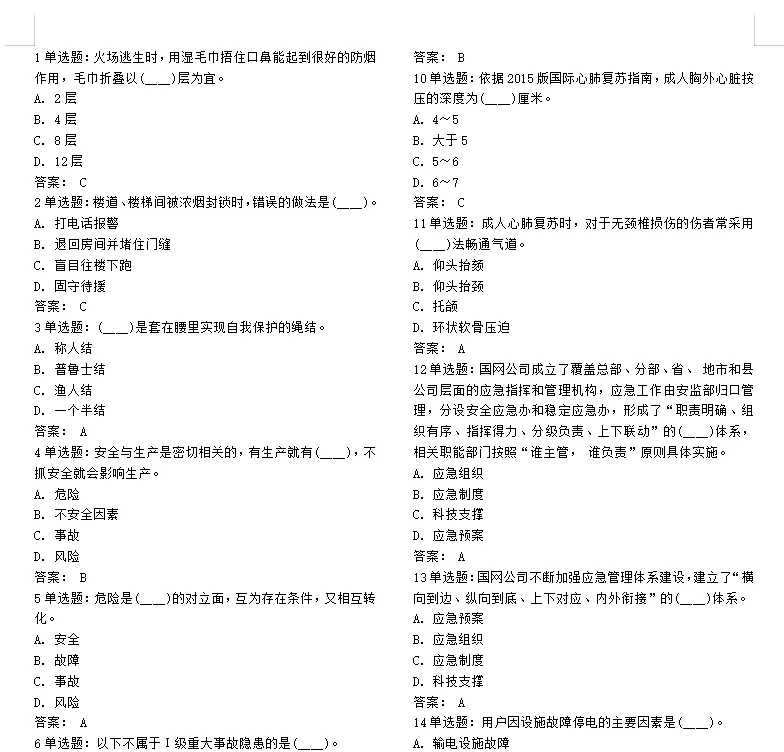
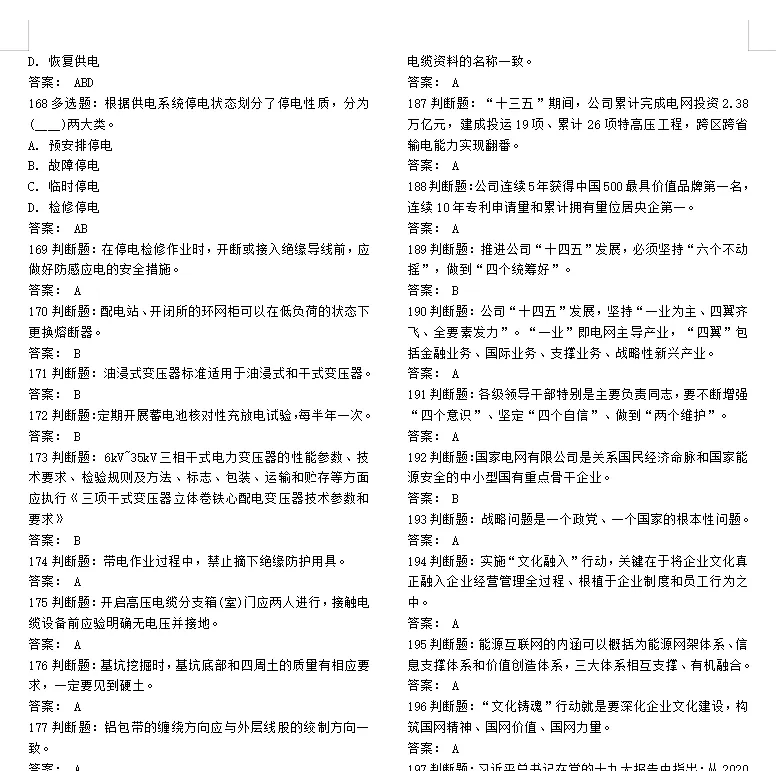
这里是文件的一部分,主要展示一下题型:单选题、多选题、判断题。
🏳️🌈 1. 读取数据
file_path = "./考试自测题库.docx"doc = docx.Document(file_path)len(doc.paragraphs)# 1只有一个段落,内容如下:
toc = [0]flag_more = Truefor idx,value in enumerate(topics):if'多选题'in value and flag_more: toc.append(idx) flag_more = Falseif'判断题'in value: toc.append(idx)break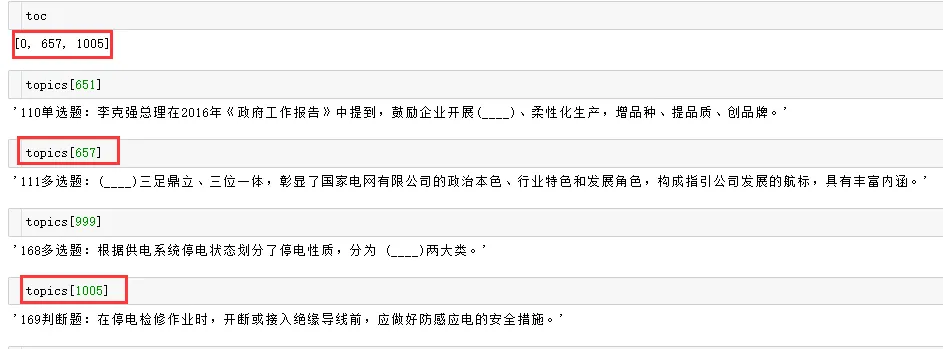
索引分别为 0、657、1005,获得索引后分题型进行处理
🏳️🌈 3. 单选题内容提取
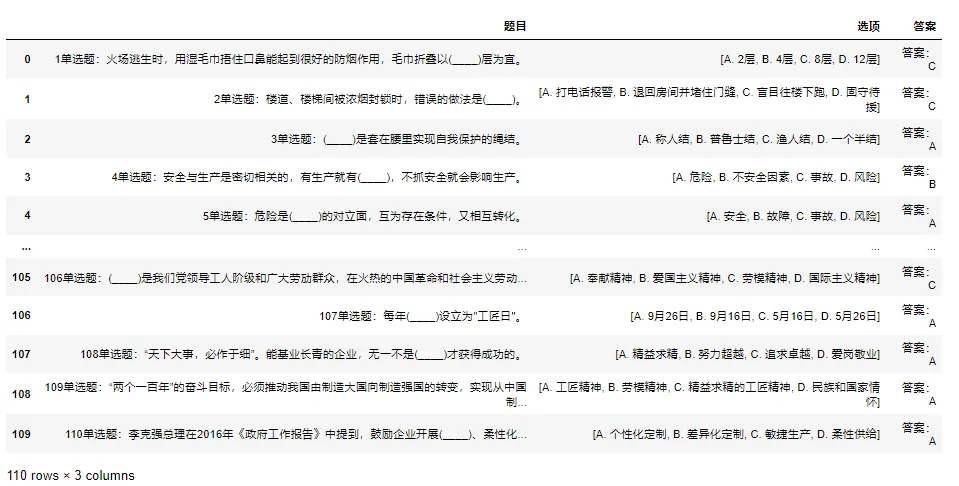
ans = []one_dic_list = []dic_tmp = {}for idx,valueinenumerate(topics[toc[0]:toc[1]]): if '单选题' invalue: iflen(ans) > 0: dic_tmp['选项'] = ans[:-1] dic_tmp['答案'] = ans[-1] one_dic_list.append(dic_tmp) dic_tmp = {} ans = [] dic_tmp['题目'] = valueelse: ans.append(value)dic_tmp['选项'] = ans[:-1]dic_tmp['答案'] = ans[-1]one_dic_list.append(dic_tmp)转换成Dataframe如下:
🏳️🌈 4. 多选题内容提取
ans = []more_dic_list = []dic_tmp = {}for idx,valueinenumerate(topics[toc[1]:toc[2]]): if '多选题' invalue: iflen(ans) > 0: dic_tmp['选项'] = ans[:-1] dic_tmp['答案'] = ans[-1] more_dic_list.append(dic_tmp) dic_tmp = {} ans = [] dic_tmp['题目'] = valueelse: ans.append(value)dic_tmp['选项'] = ans[:-1]dic_tmp['答案'] = ans[-1]more_dic_list.append(dic_tmp)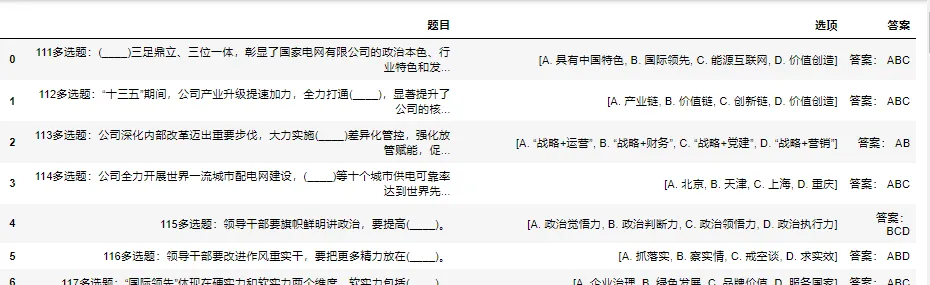
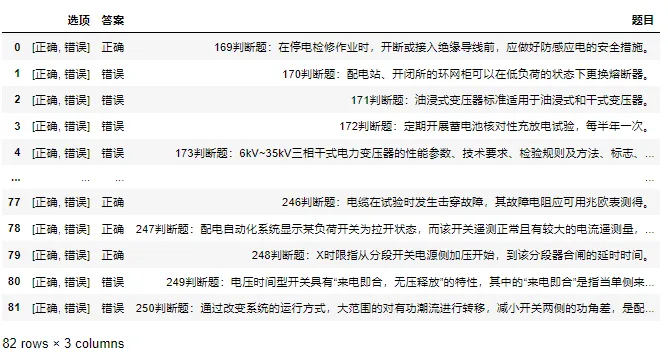
ans = []right_dic_list = []for idx,valueinenumerate(topics[toc[2]:1167]): if '判断题' invalue: dic_tmp = {} dic_tmp['选项'] = ['正确','错误'] ans_t = '正确'if topics[idx+1006].split('答案:')[1] == 'B': ans_t = '错误' dic_tmp['答案'] = ans_t dic_tmp['题目'] = value right_dic_list.append(dic_tmp)dic_tmp = {} dic_tmp['选项'] = ['正确','错误']ans_t = '正确'if topics[idx+1006+1].split('答案:')[1] == 'B': ans_t = '错误'dic_tmp['答案'] = ans_tdic_tmp['题目'] = topics[1167]right_dic_list.append(dic_tmp)转换成Dataframe如下:
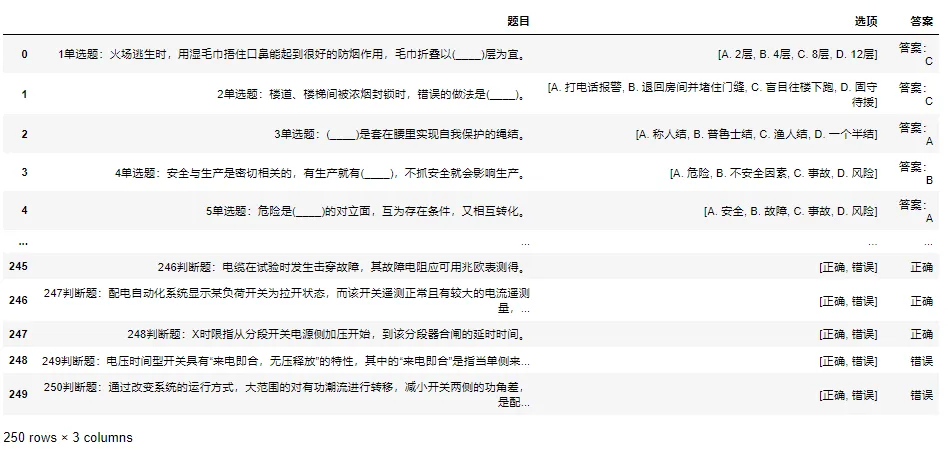
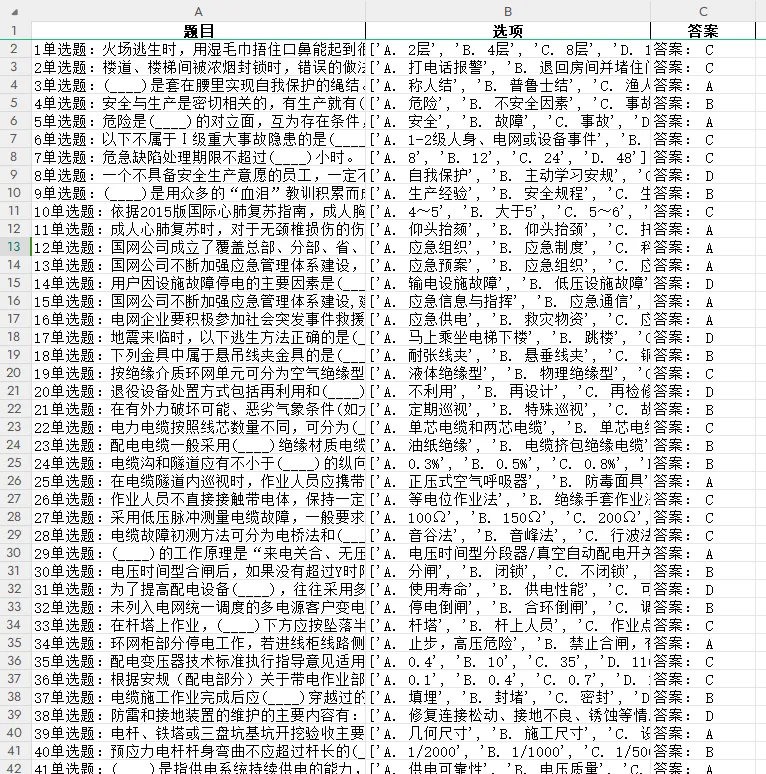
🏳️🌈 6. 最后结果
以上就是本期为大家整理的全部内容了,喜欢的朋友可以 点赞、点在看
 也可以分享让更多人知道。
往期推荐
可视化 | Flask+Mysql+Echarts 豆瓣电影Top250数据分析系统
Pandas+Pyecharts | 豆瓣电影Top250数据分析可视化
Pandas+Pyecharts | 全国星巴克门店数据分析可视化
Pandas+Pyecharts | 第七次人口普查数据分析可视化
Pandas+Pyecharts | 快手APP全国大学生用户数据分析可视化
Pandas+Pyecharts | 奥迪汽车销量数据分析可视化
可视化 | Flask+Mysql+Echarts 豆瓣电影Top250数据分析系统
Pandas+Pyecharts | 第七次人口普查数据分析可视化
Pandas+Pyecharts | 快手APP大学生用户数据分析可视化
Pandas+Pyecharts | 奥迪汽车销量数据分析可视化
Pandas+Pyecharts | 剧荒了?用Python找找最近的热播好剧!
Pandas+Pyecharts | 2023年胡润百富榜数据分析可视化
Pandas+Pyecharts | 成都大运会奖牌数据分析可视化
Pandas+Pyecharts | 电子产品销售数据分析可视化+用户RFM画像
Pandas+Pyecharts | 北京近五年历史天气数据可视化
Pandas+Pyecharts | 中国高校及专业数据分析可视化
Pandas+Pyecharts | 新冠疫情数据动态时序可视化
Pandas+Pyecharts | 全国吃穿住行消费排行榜,最‘抠门’的地区居然是北京!!!
Pandas+Pyecharts | 2022世界500强数据分析可视化
Pandas+Pyecharts | 上海市餐饮数据分析可视化
Pandas+Pyecharts | 山东省高考考生数据分析可视化
Pandas+Pyecharts | 20000+天猫订单数据可视化
Pandas+Pyecharts | 40000+汽车之家数据分析可视化
Pandas+Pyecharts | 广州市已成交房源信息数据可视化
Pandas+Pyecharts | 某直聘平台招聘信息数据可视化
可视化 | 分享一套Flask+Pyecharts可视化模板