【生存分析机器学习】Python05-加速失效时间模型(AFT)及可视化
- 2026-10-22 00:34:26
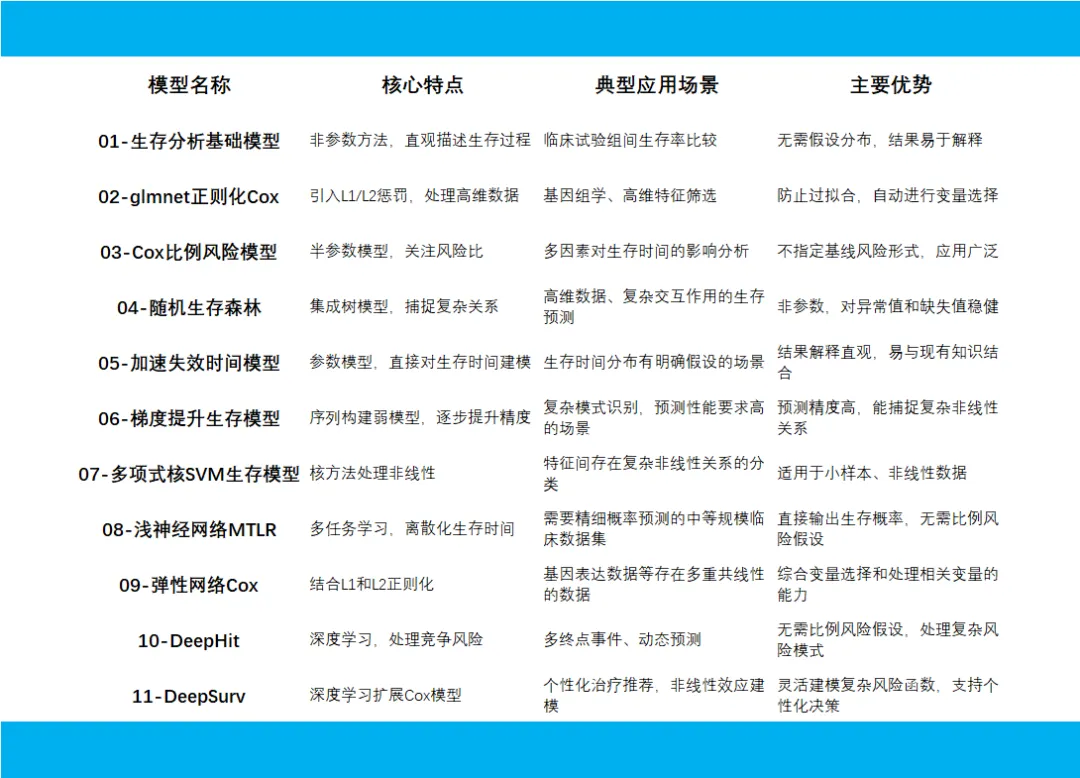
概念:参数模型,假设协变量线性地加速或减速生存时间。
原理:模型为log(T) = μ + βX + σW,其中T是生存时间,W是误差分布。常见分布包括指数、Weibull。
思想:直接对生存时间建模,而非风险函数。
应用:当风险比例假设不成立时,替代Cox模型。
可视化:生存曲线;残差图;概率图。
公共卫生意义:在环境健康研究中评估暴露对生存时间的影响。
-数据预处理:
-模型构建:
-训练:
-评估:
-可视化:
-保存结果:
生存分析机器学习模型主要分为传统统计扩展模型、树基集成模型和深度学习模型三大类,它们通过不同机制处理删失数据并预测事件发生时间。评价方法则聚焦于区分能力、校准效果和临床实用性,核心指标包括一致性指数(C-index)、Brier分数和时间依赖ROC曲线等。
# pip install pandas numpy matplotlib seaborn scikit-learn lifelinesimport osimport pandas as pdimport numpy as npimport matplotlib.pyplot as pltimport seaborn as snsfrom sklearn.model_selection import train_test_splitfrom sklearn.preprocessing import StandardScaler, LabelEncoderfrom sklearn.metrics import roc_curve, aucfrom sklearn.calibration import calibration_curvefrom sklearn.inspection import permutation_importanceimport scipy.stats as statsfrom lifelines import WeibullAFTFitter, LogNormalAFTFitter, LogLogisticAFTFitterfrom lifelines.utils import concordance_indexfrom lifelines.statistics import logrank_testimport warningswarnings.filterwarnings('ignore')# 设置中文字体和输出目录plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei']plt.rcParams['axes.unicode_minus'] = False# 创建结果文件夹desktop_path = os.path.join(os.path.expanduser("~"), "Desktop")results_dir = os.path.join(desktop_path, "Results模型-aft-comprehensive")os.makedirs(results_dir, exist_ok=True)# 1. 数据准备和预处理def load_and_preprocess_data():""" 加载和预处理数据 """ try:# 尝试读取实际数据 data = pd.read_excel(os.path.join(desktop_path, "示例数据.xlsx"), sheet_name="示例数据")print("成功读取示例数据") except:# 创建模拟数据print("未找到示例数据,创建模拟数据...") np.random.seed(2025) n_samples = 500 data = pd.DataFrame({'时间': np.random.exponential(100, n_samples),'结局': np.random.choice([0, 1], n_samples, p=[0.7, 0.3]),'指标1': np.random.normal(50, 10, n_samples),'指标2': np.random.normal(25, 5, n_samples),'指标3': np.random.normal(100, 20, n_samples),'指标4': np.random.normal(10, 2, n_samples),'指标5': np.random.normal(75, 15, n_samples),'指标6': np.random.normal(30, 6, n_samples),'指标7': np.random.normal(60, 12, n_samples),'指标8': np.random.choice(['A', 'B', 'C'], n_samples),'肥胖程度': np.random.choice(['正常', '超重', '肥胖'], n_samples),'教育水平': np.random.choice(['小学', '中学', '大学'], n_samples),'血型': np.random.choice(['A', 'B', 'O', 'AB'], n_samples) })# 确保时间变量为正数 data['时间'] = np.abs(data['时间'])# 数据预处理 data['时间'] = pd.to_numeric(data['时间'], errors='coerce') data['结局'] = pd.to_numeric(data['结局'], errors='coerce') data['结局'] = data['结局'].fillna(0).astype(int)# 处理分类变量 - 使用独热编码 categorical_cols = ['指标8', '肥胖程度', '教育水平', '血型']for col in categorical_cols:if col in data.columns:# 使用独热编码 dummies = pd.get_dummies(data[col], prefix=col) data = pd.concat([data, dummies], axis=1) data = data.drop(columns=[col])# 删除缺失值 data = data.dropna()print(f"数据维度: {data.shape}")print(f"结局分布:\n{data['结局'].value_counts()}")return data# 2. 描述性统计分析def descriptive_analysis(data, results_dir):"""生成描述性统计分析"""print("\n=== 描述性统计分析 ===")# 数值变量描述 numeric_cols = data.select_dtypes(include=[np.number]).columns numeric_cols = [col for col in numeric_cols if col not in ['时间', '结局']] desc_stats = data[numeric_cols].describe().T desc_stats['missing'] = data[numeric_cols].isnull().sum()# 按结局分组的描述if len(data['结局'].unique()) > 1: grouped_stats = data.groupby('结局')[numeric_cols].mean()# 保存结果 desc_stats.to_csv(os.path.join(results_dir, "数值变量描述性统计.csv"))return desc_stats# 3. 划分训练集和测试集def split_data(data, test_size=0.3, random_state=2025):"""划分训练集和测试集""" train_data, test_data = train_test_split( data, test_size=test_size, random_state=random_state, stratify=data['结局'] )print(f"训练集样本数: {len(train_data)}")print(f"测试集样本数: {len(test_data)}")return train_data, test_data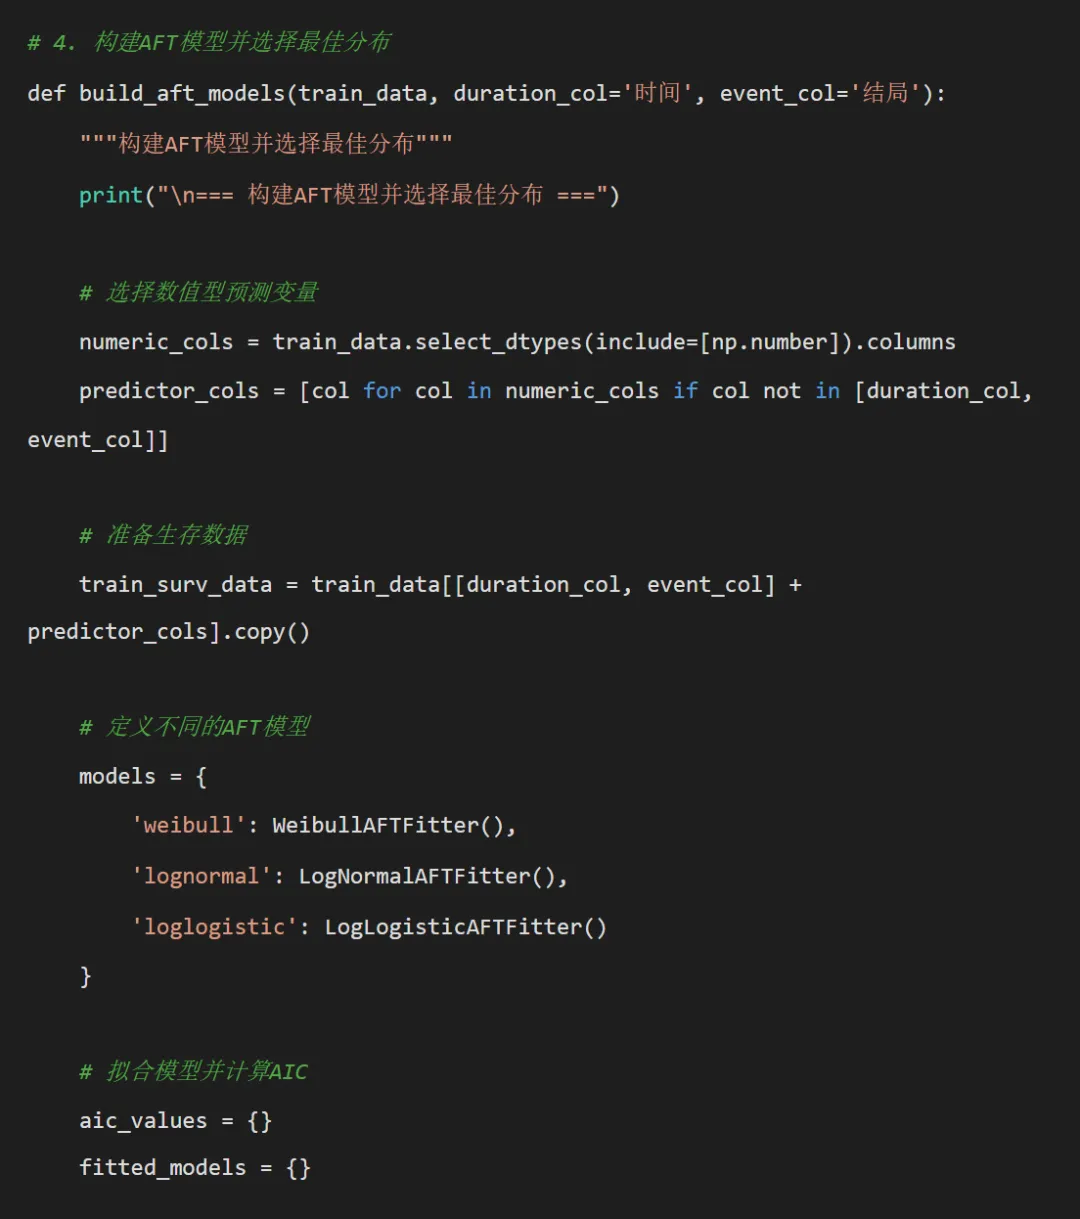
for name, model in models.items(): try: model.fit(train_surv_data, duration_col=duration_col, event_col=event_col) fitted_models[name] = model aic_values[name] = model.AIC_print(f"{name} AIC: {model.AIC_:.3f}") except Exception as e:print(f"拟合 {name} 模型时出错: {e}") aic_values[name] = np.inf# 选择最佳模型 best_model_name = min(aic_values, key=aic_values.get) best_model = fitted_models[best_model_name]print(f"最佳分布: {best_model_name}, AIC: {aic_values[best_model_name]:.3f}")# 创建AIC比较表 aic_comparison = pd.DataFrame({'Distribution': list(aic_values.keys()),'AIC': list(aic_values.values()) }).sort_values('AIC')return best_model, best_model_name, aic_comparison, predictor_cols# 5. 模型性能评估def evaluate_model(aft_model, train_data, test_data, predictor_cols, results_dir):"""评估模型性能"""print("\n=== 模型性能评估 ===")# 准备测试数据 test_surv_data = test_data[['时间', '结局'] + predictor_cols].copy()# 训练集C-index train_predictions = aft_model.predict_expectation(train_data[predictor_cols]) train_cindex = concordance_index( train_data['时间'], train_predictions, train_data['结局'] )# 测试集C-index test_predictions = aft_model.predict_expectation(test_data[predictor_cols]) test_cindex = concordance_index( test_data['时间'], test_predictions, test_data['结局'] )print(f"训练集C-index: {train_cindex:.3f}")print(f"测试集C-index: {test_cindex:.3f}")# 计算风险分数(使用预测生存时间的负值) train_data['risk_score'] = -train_predictions test_data['risk_score'] = -test_predictions# 时间依赖性ROC曲线 time_points = [12, 24, 36] # 1年、2年、3年 auc_values = calculate_time_dependent_auc(test_data, time_points, results_dir)# Brier分数 brier_scores = calculate_brier_score(aft_model, test_data, time_points, results_dir)return {'train_cindex': train_cindex,'test_cindex': test_cindex,'auc_values': auc_values,'brier_scores': brier_scores,'test_predictions': test_predictions,'test_risk_scores': test_data['risk_score'] }def calculate_time_dependent_auc(test_data, time_points, results_dir):"""计算时间依赖性AUC"""print("\n=== 时间依赖性AUC计算 ===") auc_values = {}for time_point in time_points:# 使用风险分数计算ROC risk_scores = test_data['risk_score']# 创建二元标签 y_true_binary = ((test_data['时间'] <= time_point) & (test_data['结局'] == 1)).astype(int)if y_true_binary.sum() > 0: # 确保有阳性样本 fpr, tpr, _ = roc_curve(y_true_binary, risk_scores) roc_auc = auc(fpr, tpr) auc_values[time_point] = roc_aucprint(f"{time_point}个月AUC: {roc_auc:.3f}")else:print(f"{time_point}个月: 无事件发生,无法计算AUC") auc_values[time_point] = np.nanreturn auc_valuesdef calculate_brier_score(aft_model, test_data, time_points, results_dir):"""计算Brier分数"""print("\n=== Brier分数计算 ===") brier_scores = {}for time_point in time_points: try:# 计算在特定时间点的生存概率 surv_probs = aft_model.predict_survival_function(test_data, times=[time_point]).iloc[0].values# 计算观察到的结果 observed = ((test_data['时间'] <= time_point) & (test_data['结局'] == 1)).astype(int)# 计算Brier分数 brier_score = np.mean((observed - (1 - surv_probs)) ** 2) brier_scores[time_point] = brier_scoreprint(f"{time_point}个月Brier分数: {brier_score:.3f}") except Exception as e:print(f"计算 {time_point}个月Brier分数时出错: {e}") brier_scores[time_point] = np.nan# 保存Brier分数 brier_df = pd.DataFrame(list(brier_scores.items()), columns=['Time', 'Brier_Score']) brier_df.to_csv(os.path.join(results_dir, "Brier分数.csv"), index=False)return brier_scores# 6. 可视化分析def create_visualizations(aft_model, best_dist, aic_comparison, train_data, test_data, predictor_cols, performance_metrics, results_dir):"""创建所有可视化图表"""print("\n=== 创建可视化图表 ===")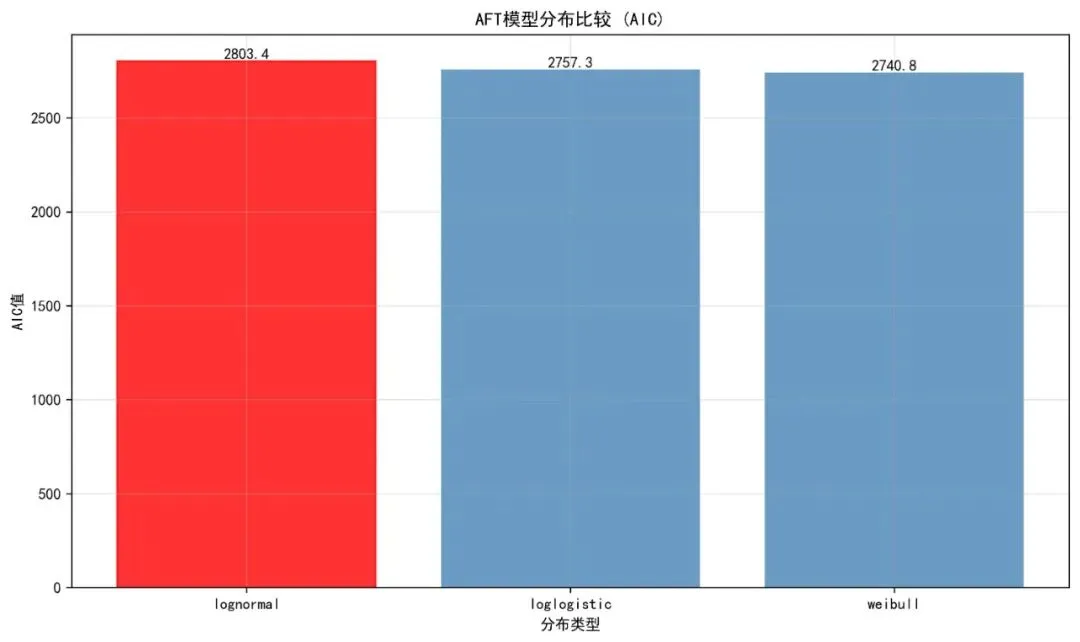
# 6.1 变量重要性图 plot_variable_importance(aft_model, predictor_cols, best_dist, results_dir)# 6.2 生存曲线比较 plot_survival_comparison(aft_model, train_data, best_dist, results_dir)# 6.3 残差分析 plot_residuals(aft_model, train_data, results_dir)# 6.4 分布比较图 plot_distribution_comparison(aic_comparison, results_dir)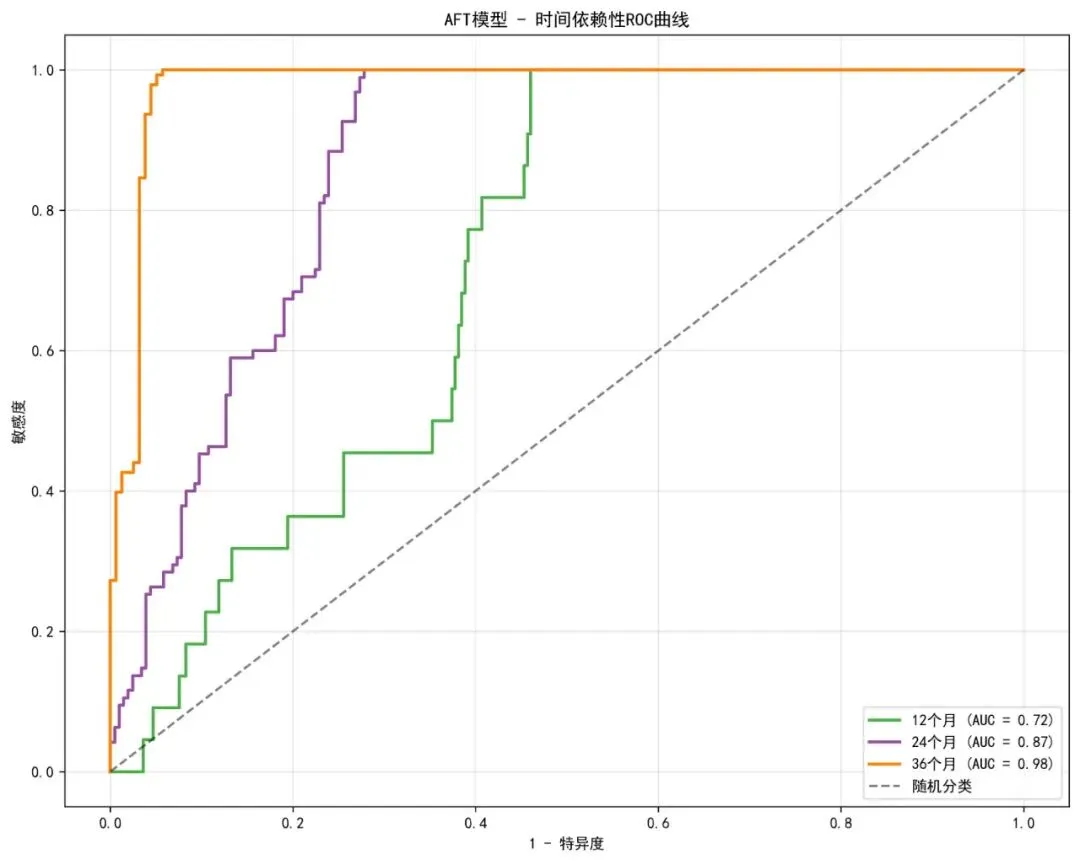
# 6.5 时间依赖性ROC曲线 plot_time_dependent_roc(test_data, performance_metrics['test_risk_scores'], results_dir)# 6.6 校准曲线 plot_calibration_curve(aft_model, test_data, results_dir)# 6.7 风险分层可视化 plot_risk_stratification(test_data, performance_metrics['test_risk_scores'], results_dir)# 6.8 临床决策曲线分析 plot_decision_curve_analysis(test_data, performance_metrics['test_risk_scores'], results_dir)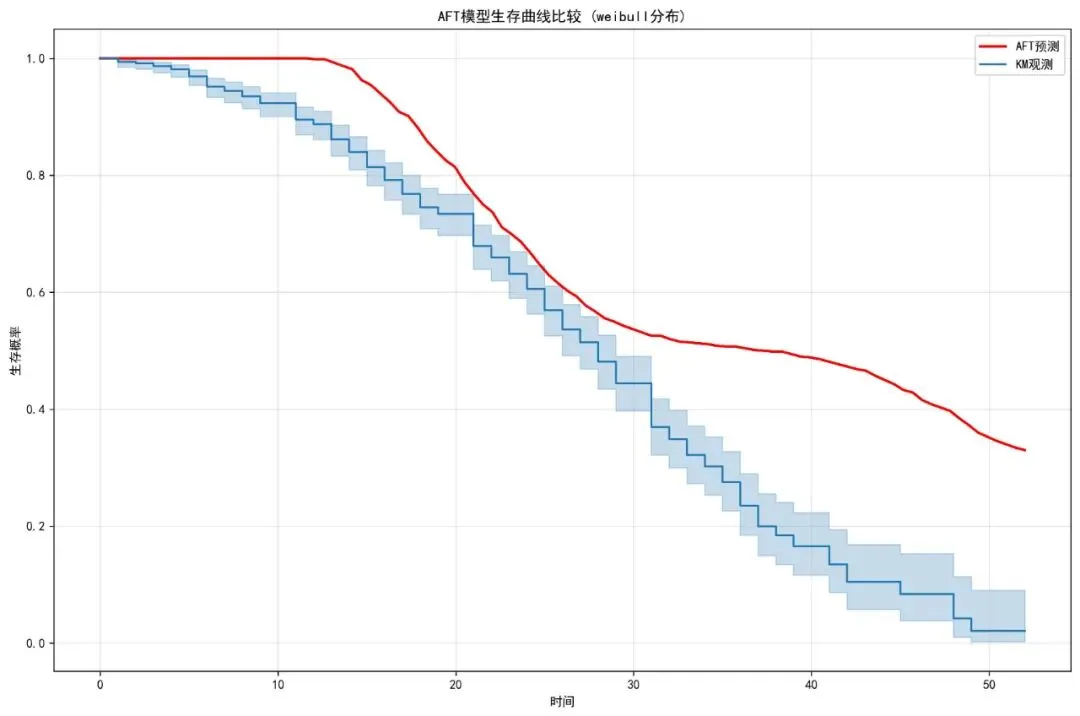
def plot_variable_importance(aft_model, predictor_cols, best_dist, results_dir):"""绘制变量重要性图""" plt.figure(figsize=(12, 8)) try:# 获取模型摘要 summary = aft_model.summary# 从摘要中提取系数(排除截距和尺度参数) coef_data = summary[~summary.index.str.contains('Intercept|_sigma|scale', na=False)]# 提取变量名和系数值 variables = [] coefficients = []for idx, row in coef_data.iterrows():# 检查变量名是否在predictor_cols中 var_name = idx.split('_')[0] if'_'in idx else idx # 处理独热编码变量if var_name in predictor_cols or any(p in idx for p in predictor_cols): variables.append(idx) coefficients.append(abs(row['coef']))# 创建重要性数据框 importance_df = pd.DataFrame({'Variable': variables,'Importance': coefficients }).sort_values('Importance', ascending=True)# 绘制水平条形图 plt.barh(importance_df['Variable'], importance_df['Importance'], color='steelblue', alpha=0.8) plt.xlabel('系数绝对值') plt.title(f'AFT模型变量重要性 ({best_dist}分布)') plt.grid(True, alpha=0.3)# 添加数值标签for i, v in enumerate(importance_df['Importance']): plt.text(v + 0.001, i, f'{v:.3f}', va='center') plt.tight_layout() plt.savefig(os.path.join(results_dir, "变量重要性图.jpg"), dpi=300, bbox_inches='tight') plt.close()# 保存变量重要性数据 importance_df.to_csv(os.path.join(results_dir, "变量重要性.csv"), index=False)print("变量重要性图创建成功") except Exception as e:print(f"创建变量重要性图时出错: {e}")# 创建简单的替代图 plt.figure(figsize=(12, 8)) plt.barh(range(len(predictor_cols)), [1] * len(predictor_cols), color='steelblue', alpha=0.8) plt.yticks(range(len(predictor_cols)), predictor_cols) plt.xlabel('重要性 (计算失败)') plt.title(f'AFT模型变量重要性 ({best_dist}分布)') plt.grid(True, alpha=0.3) plt.tight_layout() plt.savefig(os.path.join(results_dir, "变量重要性图.jpg"), dpi=300, bbox_inches='tight') plt.close()def plot_survival_comparison(aft_model, train_data, best_dist, results_dir):"""绘制生存曲线比较""" plt.figure(figsize=(12, 8)) try:# 生成时间序列times = np.linspace(0, train_data['时间'].max(), 100)# 计算AFT预测的生存曲线(使用中位生存时间) median_predictions = aft_model.predict_median(train_data) aft_survival = []for t intimes:# 计算在时间t的生存概率 surv_prob = (median_predictions > t).mean() aft_survival.append(surv_prob)# 计算KM曲线 from lifelines import KaplanMeierFitter kmf = KaplanMeierFitter() kmf.fit(train_data['时间'], train_data['结局'])# 绘制曲线 plt.plot(times, aft_survival, 'r-', linewidth=2, label='AFT预测') kmf.plot_survival_function(ax=plt.gca(), label='KM观测') plt.xlabel('时间') plt.ylabel('生存概率') plt.title(f'AFT模型生存曲线比较 ({best_dist}分布)') plt.legend() plt.grid(True, alpha=0.3) plt.tight_layout() plt.savefig(os.path.join(results_dir, "生存曲线比较.jpg"), dpi=300, bbox_inches='tight') plt.close()print("生存曲线比较图创建成功") except Exception as e:print(f"创建生存曲线比较图时出错: {e}")def plot_residuals(aft_model, train_data, results_dir):"""绘制残差分析""" plt.figure(figsize=(12, 8)) try:# 计算预测值 predictions = aft_model.predict_expectation(train_data)# 计算残差 residuals = train_data['时间'] - predictions# 绘制残差直方图 plt.hist(residuals, bins=30, alpha=0.7, color='steelblue', edgecolor='black') plt.xlabel('残差') plt.ylabel('频数') plt.title('AFT模型残差分布') plt.grid(True, alpha=0.3) plt.tight_layout() plt.savefig(os.path.join(results_dir, "残差分析.jpg"), dpi=300, bbox_inches='tight') plt.close()print("残差分析图创建成功") except Exception as e:print(f"创建残差分析图时出错: {e}")def plot_distribution_comparison(aic_comparison, results_dir):"""绘制分布比较图""" plt.figure(figsize=(10, 6)) try:# 按AIC排序 aic_comparison = aic_comparison.sort_values('AIC', ascending=False)# 绘制条形图 bars = plt.bar(aic_comparison['Distribution'], aic_comparison['AIC'], color='steelblue', alpha=0.8)# 标记最佳分布 best_idx = aic_comparison['AIC'].idxmin() bars[best_idx].set_color('red') plt.xlabel('分布类型') plt.ylabel('AIC值') plt.title('AFT模型分布比较 (AIC)') plt.grid(True, alpha=0.3)# 添加数值标签for i, v in enumerate(aic_comparison['AIC']): plt.text(i, v + 0.1, f'{v:.1f}', ha='center', va='bottom') plt.tight_layout() plt.savefig(os.path.join(results_dir, "分布比较图.jpg"), dpi=300, bbox_inches='tight') plt.close()print("分布比较图创建成功") except Exception as e:print(f"创建分布比较图时出错: {e}")def plot_time_dependent_roc(test_data, risk_scores, results_dir):"""绘制时间依赖性ROC曲线""" plt.figure(figsize=(10, 8)) time_points = [12, 24, 36] colors = ['#4DAF4A', '#984EA3', '#FF7F00']for i, time_point in enumerate(time_points):# 创建二元标签 y_true_binary = ((test_data['时间'] <= time_point) & (test_data['结局'] == 1)).astype(int)if y_true_binary.sum() > 0: fpr, tpr, _ = roc_curve(y_true_binary, risk_scores) roc_auc = auc(fpr, tpr) plt.plot(fpr, tpr, color=colors[i], linewidth=2, label=f'{time_point}个月 (AUC = {roc_auc:.2f})') plt.plot([0, 1], [0, 1], 'k--', alpha=0.5, label='随机分类') plt.xlabel('1 - 特异度') plt.ylabel('敏感度') plt.title('AFT模型 - 时间依赖性ROC曲线') plt.legend() plt.grid(True, alpha=0.3) plt.tight_layout() plt.savefig(os.path.join(results_dir, "时间ROC曲线.jpg"), dpi=300, bbox_inches='tight') plt.close()print("时间ROC曲线图创建成功")def plot_calibration_curve(aft_model, test_data, results_dir):"""绘制校准曲线""" plt.figure(figsize=(10, 8)) time_points = [12, 24, 36] colors = ['#4DAF4A', '#984EA3', '#FF7F00']for i, time_point in enumerate(time_points): try:# 计算在特定时间点的预测生存概率 surv_probs = aft_model.predict_survival_function(test_data, times=[time_point]).iloc[0].values pred_risk = 1 - surv_probs # 转换为风险概率# 计算观察到的风险 observed_risk = ((test_data['时间'] <= time_point) & (test_data['结局'] == 1)).astype(int)# 创建校准数据 prob_true, prob_pred = calibration_curve( observed_risk, pred_risk, n_bins=10, strategy='quantile' ) plt.plot(prob_pred, prob_true, 'o-', color=colors[i], label=f'{time_point}个月', linewidth=2, markersize=6) except Exception as e:print(f"计算 {time_point}个月校准曲线时出错: {e}") plt.plot([0, 1], [0, 1], '--', color='gray', label='理想校准') plt.xlabel('预测风险概率') plt.ylabel('观察风险概率') plt.title('AFT模型 - 校准曲线') plt.legend() plt.grid(True, alpha=0.3) plt.tight_layout() plt.savefig(os.path.join(results_dir, "校准曲线.jpg"), dpi=300, bbox_inches='tight') plt.close()print("校准曲线图创建成功")def plot_risk_stratification(test_data, risk_scores, results_dir):"""风险分层可视化""" plt.figure(figsize=(12, 8)) try:# 根据预测风险中位数分层 risk_median = np.median(risk_scores) test_data = test_data.copy() test_data['risk_group'] = np.where(risk_scores > risk_median, '高风险', '低风险')# 使用lifelines绘制分层生存曲线 from lifelines import KaplanMeierFitter kmf = KaplanMeierFitter()for group in ['低风险', '高风险']: group_data = test_data[test_data['risk_group'] == group] kmf.fit(group_data['时间'], group_data['结局'], label=group) kmf.plot_survival_function() plt.xlabel('时间') plt.ylabel('生存概率') plt.title('测试集风险分层生存曲线') plt.grid(True, alpha=0.3) plt.tight_layout() plt.savefig(os.path.join(results_dir, "风险分层生存曲线.jpg"), dpi=300, bbox_inches='tight') plt.close()print("风险分层图创建成功") except Exception as e:print(f"创建风险分层图时出错: {e}")def plot_decision_curve_analysis(test_data, risk_scores, results_dir):"""临床决策曲线分析""" plt.figure(figsize=(10, 8)) thresholds = np.linspace(0.01, 0.99, 50) net_benefits = []for threshold in thresholds:# 根据阈值决定治疗 risk_threshold = np.quantile(risk_scores, threshold) treat_by_model = risk_scores > risk_threshold true_positives = np.sum(treat_by_model & (test_data['结局'] == 1)) false_positives = np.sum(treat_by_model & (test_data['结局'] == 0)) n = len(test_data) net_benefit = (true_positives / n) - (false_positives / n) * (threshold / (1 - threshold)) net_benefits.append(net_benefit) plt.plot(thresholds, net_benefits, 'b-', linewidth=2, label='模型') plt.axhline(y=0, color='gray', linestyle='--', label='不治疗')# 所有治疗策略 event_rate = test_data['结局'].mean() treat_all_benefit = [event_rate - (1 - event_rate) * (t / (1 - t)) for t in thresholds] plt.plot(thresholds, treat_all_benefit, 'r--', linewidth=2, label='全部治疗') plt.xlabel('决策阈值') plt.ylabel('标准化净获益') plt.title('AFT模型 - 临床决策曲线分析 (DCA)') plt.legend() plt.grid(True, alpha=0.3) plt.tight_layout() plt.savefig(os.path.join(results_dir, "临床决策曲线.jpg"), dpi=300, bbox_inches='tight') plt.close()print("临床决策曲线图创建成功")# 7. 保存结果和生成报告def save_results_and_report(aft_model, best_dist, aic_comparison, performance_metrics, train_data, test_data, predictor_cols, results_dir):"""保存所有结果并生成报告"""print("\n=== 保存结果和生成报告 ===")# 7.1 保存模型性能指标 performance_df = pd.DataFrame([ ['训练集C-index', performance_metrics['train_cindex']], ['测试集C-index', performance_metrics['test_cindex']], ] + [[f'{time_point}个月AUC', auc_value]for time_point, auc_value in performance_metrics['auc_values'].items()], columns=['Metric', 'Value'] ) performance_df.to_csv(os.path.join(results_dir, "模型性能指标.csv"), index=False)# 7.2 保存模型系数 model_coefficients = aft_model.summary model_coefficients.to_csv(os.path.join(results_dir, "模型系数.csv"))# 7.3 保存AIC比较 aic_comparison.to_csv(os.path.join(results_dir, "分布AIC比较.csv"), index=False)# 7.4 生成文本报告 generate_text_report(performance_metrics, best_dist, len(train_data), len(test_data), results_dir)# 7.5 保存工作空间 import joblib joblib.dump({'model': aft_model,'best_dist': best_dist,'performance_metrics': performance_metrics,'train_data': train_data,'test_data': test_data,'predictor_cols': predictor_cols }, os.path.join(results_dir, "分析环境.pkl"))def generate_text_report(performance_metrics, best_dist, n_train, n_test, results_dir):"""生成文本报告""" report_content = f"""加速失效时间模型(AFT)综合分析报告================================数据概览--------训练集样本数: {n_train}测试集样本数: {n_test}模型性能指标-----------训练集C-index: {performance_metrics['train_cindex']:.3f}测试集C-index: {performance_metrics['test_cindex']:.3f}时间依赖性AUC值:"""for time_point, auc_value in performance_metrics['auc_values'].items(): report_content += f"{time_point}个月AUC: {auc_value:.3f}\n" report_content += f"""Brier分数:"""for time_point, brier_score in performance_metrics['brier_scores'].items(): report_content += f"{time_point}个月Brier分数: {brier_score:.3f}\n" report_content += f"""关键结论--------模型在测试集的区分能力(C-index): {performance_metrics['test_cindex']:.3f}平均Brier分数: {np.mean(list(performance_metrics['brier_scores'].values())):.3f}最佳分布类型: {best_dist}"""# 性能问题提示if performance_metrics['test_cindex'] < 0.5: report_content += """!!! 警告: 测试集C-index低于0.5,模型在测试集上表现不佳 !!!可能原因:- AFT模型可能不适合此数据集- 数据可能需要不同的变换- 考虑使用Cox模型或其他机器学习方法- 检查数据是否符合AFT模型的参数假设""" with open(os.path.join(results_dir, "综合分析报告.txt"), "w", encoding='utf-8') as f: f.write(report_content)# 主函数def main():print("开始加速失效时间模型(AFT)综合分析...")# 1. 数据准备和预处理 data = load_and_preprocess_data()# 2. 描述性统计分析 desc_stats = descriptive_analysis(data, results_dir)# 3. 划分训练集和测试集 train_data, test_data = split_data(data)# 4. 构建AFT模型并选择最佳分布 aft_model, best_dist, aic_comparison, predictor_cols = build_aft_models(train_data)# 5. 模型性能评估 performance_metrics = evaluate_model(aft_model, train_data, test_data, predictor_cols, results_dir)# 6. 可视化分析 create_visualizations(aft_model, best_dist, aic_comparison, train_data, test_data, predictor_cols, performance_metrics, results_dir)# 7. 保存结果和生成报告 save_results_and_report(aft_model, best_dist, aic_comparison, performance_metrics, train_data, test_data, predictor_cols, results_dir)print(f"\n=== 加速失效时间模型(AFT)综合分析已完成 ===")print(f"所有结果已保存到 {results_dir} 文件夹中。")print("包含的性能评价指标:")print("- 综合区分能力 (C-index)")print("- 时间依赖性ROC曲线 (AUC)")print("- Brier分数 (校准度)")print("- 临床决策曲线 (DCA)")print("- 风险分层分析")print("- 分布选择分析")print("- 残差分析")print(f"\n关键指标:")print(f"训练集C-index: {performance_metrics['train_cindex']:.3f}")print(f"测试集C-index: {performance_metrics['test_cindex']:.3f}")print(f"时间点AUC值: {', '.join([f'{auc_value:.3f}' for auc_value in performance_metrics['auc_values'].values()])}")print(f"平均Brier分数: {np.mean(list(performance_metrics['brier_scores'].values())):.3f}")print(f"最佳分布: {best_dist}")if __name__ == "__main__": main()🔍加速失效时间模型及可视化
概念:加速失效时间模型是一种参数模型,它假设协变量的效应是"加速"或"减速"生存过程,即直接对生存时间 $T$ 的对数进行建模。
原理:模型基本形式为 $\log T = \mu + \beta X + \sigma W$。其中 $\mu$ 是截距,$W$ 是误差项(服从特定分布如极值分布、正态分布)。常见的分布假设包括指数分布、威布尔分布等。
思想:将协变量效应体现为对生存时间尺度的乘性影响,即 $T = \exp(\mu + \beta X) \times \exp(\sigma W)$,使得结果解释更符合直觉。
应用:当数据不满足Cox模型的比例风险假定时,AFT模型是良好的替代选择,例如在工业产品寿命测试或某些疾病进程研究中。
可视化:生存曲线:根据拟合的AFT模型绘制不同协变量水平下的生存函数曲线。概率图:用于评估所选分布假设的合理性(如威布尔概率图)。
公共卫生意义:可用于评估环境暴露或政策干预(如空气质量改善)对人群"健康寿命"年的影响效果。
医学统计数据分析分享交流SPSS、R语言、Python、ArcGis、Geoda、GraphPad、数据分析图表制作等心得。承接数据分析,论文返修,医学统计,机器学习,生存分析,空间分析,问卷分析业务。若有投稿和数据分析代做需求,可以直接联系我,谢谢!
“医学统计数据分析”公众号右下角;
找到“联系作者”,
可加我微信,邀请入粉丝群!
有临床流行病学数据分析
如(t检验、方差分析、χ2检验、logistic回归)、
(重复测量方差分析与配对T检验、ROC曲线)、
(非参数检验、生存分析、样本含量估计)、
(筛检试验:灵敏度、特异度、约登指数等计算)、
(绘制柱状图、散点图、小提琴图、列线图等)、
机器学习、深度学习、生存分析
等需求的同仁们,加入【临床】粉丝群。
疾控,公卫岗位的同仁,可以加一下【公卫】粉丝群,分享生态学研究、空间分析、时间序列、监测数据分析、时空面板技巧等工作科研自动化内容。
有实验室数据分析需求的同仁们,可以加入【生信】粉丝群,交流NCBI(基因序列)、UniProt(蛋白质)、KEGG(通路)、GEO(公共数据集)等公共数据库、基因组学转录组学蛋白组学代谢组学表型组学等数据分析和可视化内容。
或者可扫码直接加微信进群!!!

精品视频课程-“医学统计数据分析”视频号付费合集
在“医学统计数据分析”视频号-付费合集兑换相应课程后,获取课程理论课PPT、代码、基础数据等相关资料,请大家在【医学统计数据分析】公众号右下角,找到“联系作者”,加我微信后打包发送。感谢您的支持!!
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- Scratch案例0-500编程源码(获取方式见文末)
- 当 85% 的代码由 AI 生成,程序员的价值在哪里?
- 2026年捅破AI编程天花板的,竟然是一个在澳大利亚养羊的大叔?
- 快速交付项目!最新LuBase 低代码开发框架,强!
- 被进化“编程”的大脑:我们的自由,不过是基因的提线木偶|领《洞见》电子书
- 看6岁孩子用AI编程设计的游戏!马斯克最新访谈,所言非虚
- 吴军*脱不花|当AI会写代码,什么能力才真正稀缺?吴军与脱不花畅谈未来教育
- 编程,主题好书精准赋能孩子19(2026年1月修订)
- 探索出了目前如何在纯血鸿蒙上写代码的模式
- PHP 8.5 支持常量态闭包和可调用对象