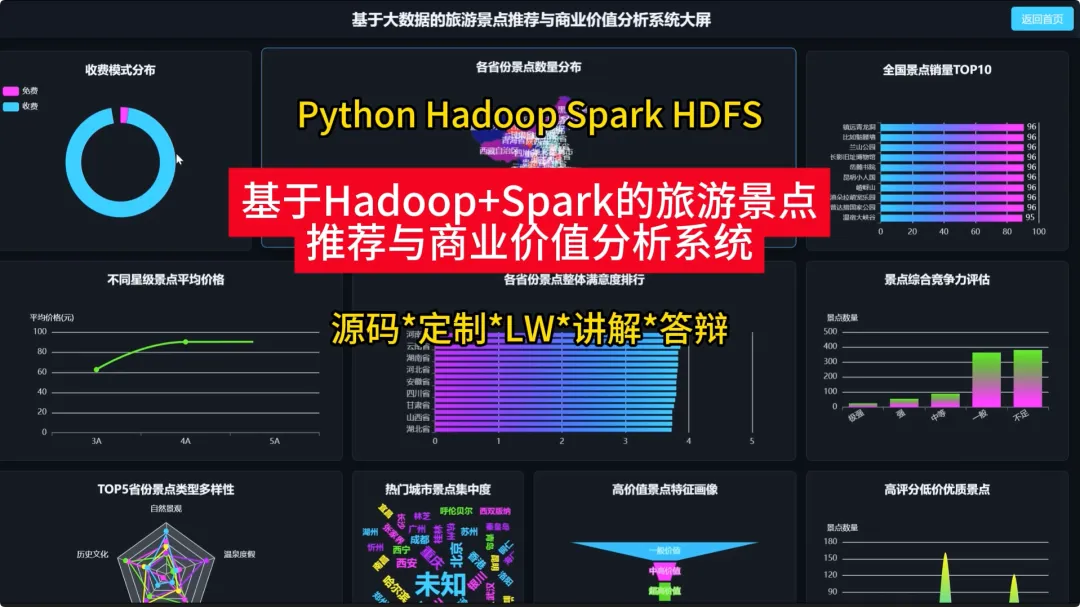
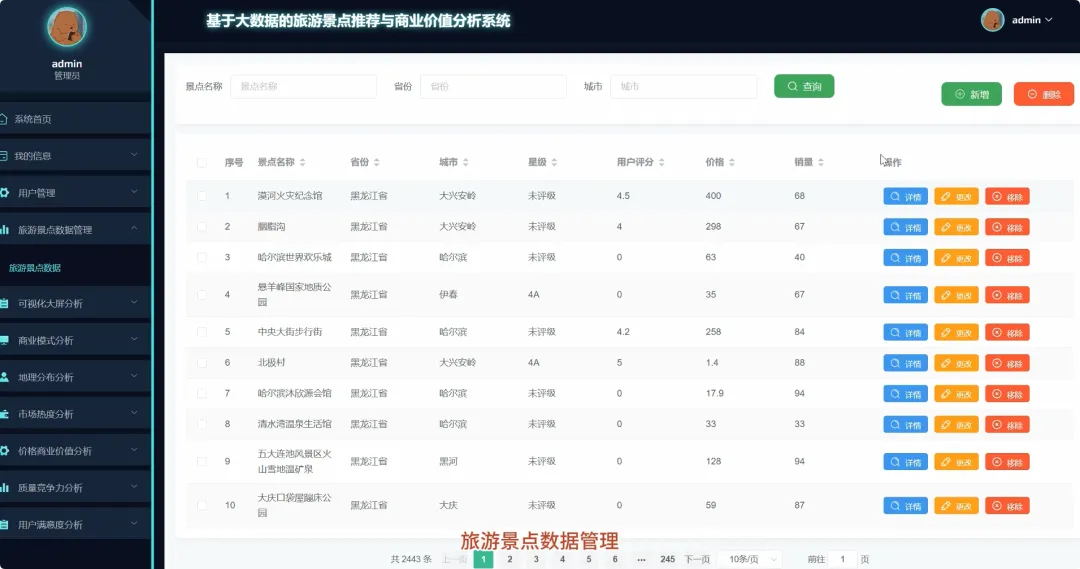
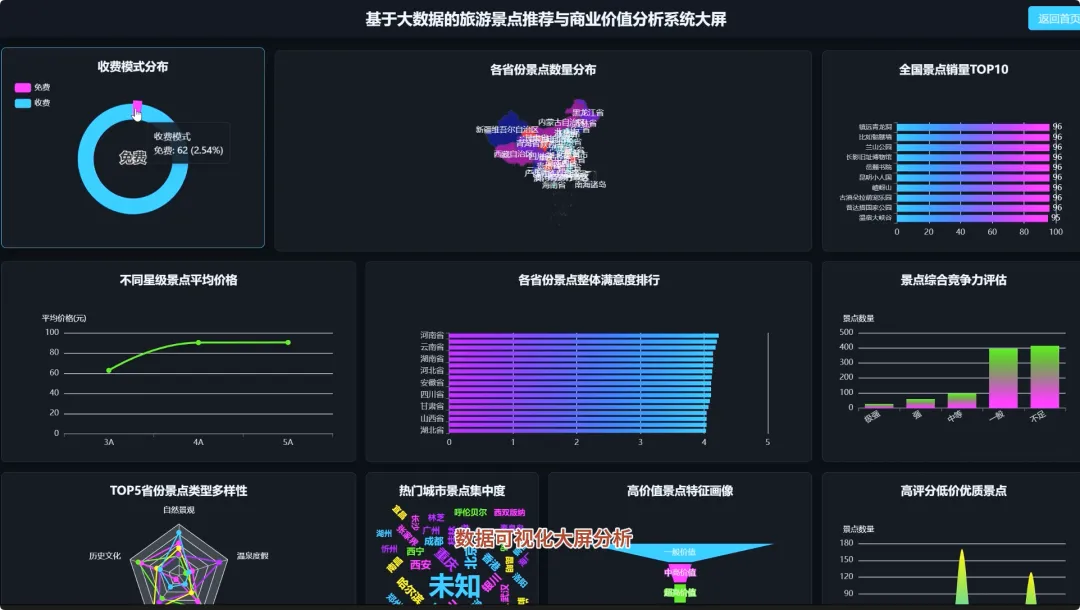
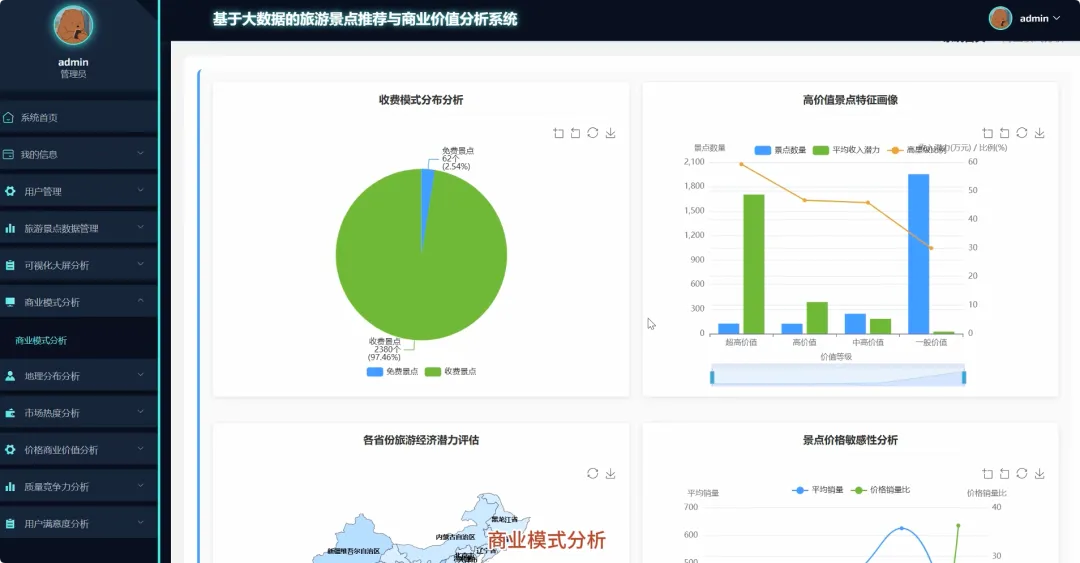
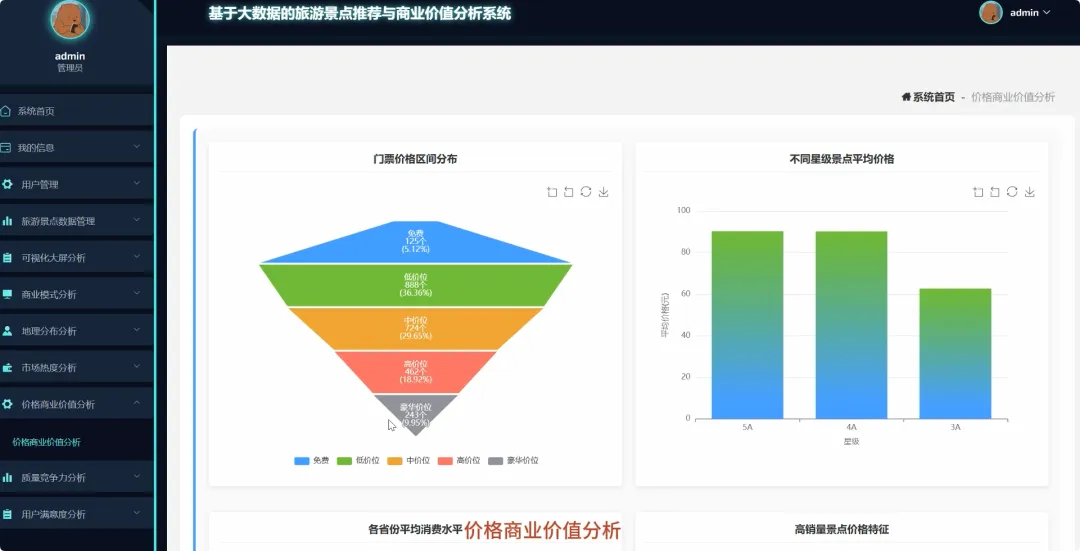
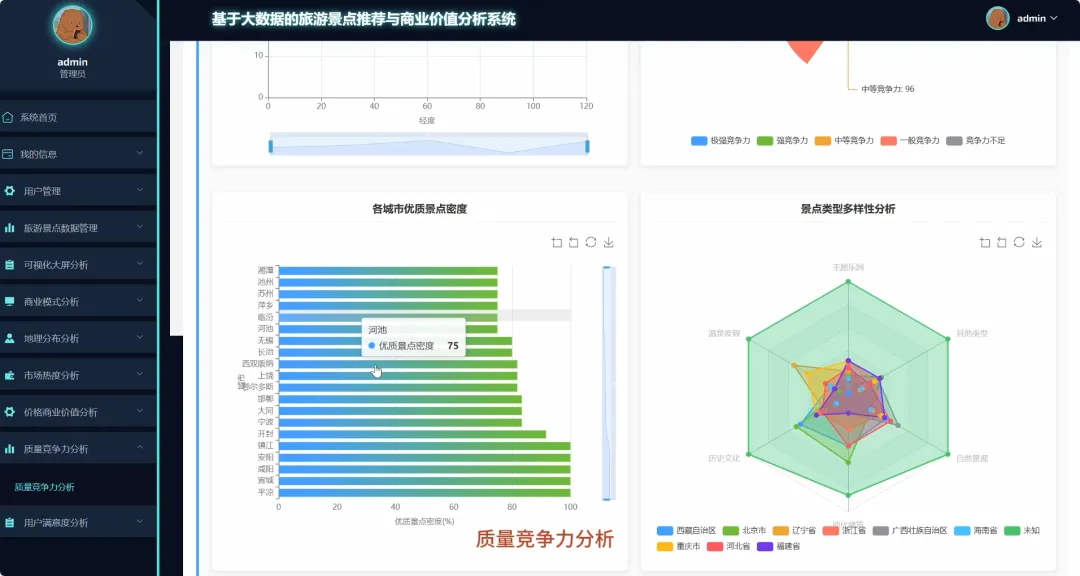
from pyspark.sql import SparkSessionfrom pyspark.sql.functions import col, avg, count, max as spark_max, row_numberfrom pyspark.sql.window import Windowspark = SparkSession.builder.appName("TourismAnalysis").getOrCreate()# 假设df是一个已加载的Spark DataFrame,包含字段:province, city, name, price, rating, sales, is_free# df = spark.read.csv("hdfs://path/to/data.csv", header=True, inferSchema=True)def find_high_value_spots(df): high_value_df = df.filter((col("rating") >= 4.5) & (col("price") > 0) & (col("price") <= 100)) return high_value_df.select("name", "province", "city", "price", "rating").orderBy(col("rating").desc(), col("price").asc())def analyze_province_avg_spending(df): province_spending = df.filter(col("price") > 0).groupBy("province").agg(avg("price").alias("avg_price"), count("name").alias("spot_count")) return province_spending.orderBy(col("avg_price").desc())def evaluate_competitiveness(df): max_sales = df.agg(spark_max("sales")).collect()[0][0] max_price = df.agg(spark_max("price")).collect()[0][0] competitiveness_df = df.withColumn("sales_norm", col("sales") / max_sales) competitiveness_df = competitiveness_df.withColumn("price_norm", col("price") / max_price) competitiveness_df = competitiveness_df.withColumn("competitiveness_score", (col("rating") * 0.6 + col("sales_norm") * 0.4) / (col("price_norm") + 0.1)) window_spec = Window.orderBy(col("competitiveness_score").desc()) final_df = competitiveness_df.withColumn("rank", row_number().over(window_spec)) return final_df.select("rank", "name", "province", "rating", "sales", "price", "competitiveness_score")from pyspark.sql import SparkSessionfrom pyspark.sql.functions import col, avg, count, max as spark_max, row_numberfrom pyspark.sql.window import Windowspark = SparkSession.builder.appName("TourismAnalysis").getOrCreate()# 假设df是一个已加载的Spark DataFrame,包含字段:province, city, name, price, rating, sales, is_free# df = spark.read.csv("hdfs://path/to/data.csv", header=True, inferSchema=True)def find_high_value_spots(df): high_value_df = df.filter((col("rating") >= 4.5) & (col("price") > 0) & (col("price") <= 100)) return high_value_df.select("name", "province", "city", "price", "rating").orderBy(col("rating").desc(), col("price").asc())def analyze_province_avg_spending(df): province_spending = df.filter(col("price") > 0).groupBy("province").agg(avg("price").alias("avg_price"), count("name").alias("spot_count")) return province_spending.orderBy(col("avg_price").desc())def evaluate_competitiveness(df): max_sales = df.agg(spark_max("sales")).collect()[0][0] max_price = df.agg(spark_max("price")).collect()[0][0] competitiveness_df = df.withColumn("sales_norm", col("sales") / max_sales) competitiveness_df = competitiveness_df.withColumn("price_norm", col("price") / max_price) competitiveness_df = competitiveness_df.withColumn("competitiveness_score", (col("rating") * 0.6 + col("sales_norm") * 0.4) / (col("price_norm") + 0.1)) window_spec = Window.orderBy(col("competitiveness_score").desc()) final_df = competitiveness_df.withColumn("rank", row_number().over(window_spec)) return final_df.select("rank", "name", "province", "rating", "sales", "price", "competitiveness_score")
 10个月宝宝每天需要喝多少奶粉?