破壁者DeepSeek,v4 代码能力超越GPT 和 Claude?下个月见分晓!
- 2026-10-21 13:27:35
关于创新,管理学大师彼得·德鲁克曾有过一段振聋发聩的论述:
❝有效的创新始于小处。它并不宏大。它只做一件具体的事,否则就会造成混淆。
今天,一家中国人工智能公司正在用最硬核的技术路线,为这段话写下最生动的注脚。它,就是 深度求索,产品 DeepSeek。
AI 界的“破壁者”与一场不按套路出牌的逆袭
还记得 2025 年春节那个震撼全球的“DeepSeek 周”吗?
当大多数人沉浸在节日的祥和中时,DeepSeek R1 横空出世。
短短数日,它不仅霸榜全球应用商店,更让硅谷陷入了一场前所未有的集体焦虑——从从业者的失眠到投资者的恐慌。
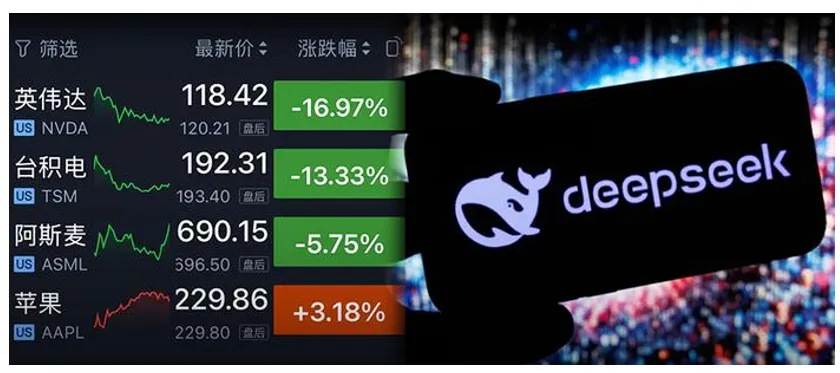
它引发的蝴蝶效应,直接导致以 Nvidia 为首的美国科技股在单日内蒸发万亿美元市值。DeepSeek 用实力打破了“美国领先”和“唯算力论”的神话,证明了国产 AI 在推理能力上已登峰造极。
如今,2026 年春节窗口即将开启,那个推崇“算法美学”、鄙夷单纯堆砌算力的“破壁者”又回来了。
行业多方爆料指向同一个时间点:2026 年 2 月中旬,DeepSeek v4 将正式揭开面纱。
《巅峰对决:DeepSeek V4 与 Kimi K3,谁才是国产第一 AI?》
这绝非一次常规的版本迭代,而是中国 AI 凭借底层创新,全球编程大模型发起的正面冲锋。
这一次,它的战略目标极其精准且冷酷:在“代码生成”这一 AI 皇冠上的明珠领域,彻底挑战 OpenAI 和 Anthropic 的双寡头霸权。好巧不巧,OpenAI近期也将上线新架构训练的GPT5.3,来个天王斗地虎!
2. 核心爆料:v4 的战力值与“三大秘密武器”
根据目前的行业泄露信息与内部基准测试,DeepSeek v4 展现出了令人惊叹的“越级挑战”姿态,甚至在某些维度上让硅谷巨头感到了“背脊发凉”。
在 AI 编程领域公认的黄金标准 HumanEval 测试中,战局已然改写:
DeepSeek v4: 约 90% Claude 系列: 88% GPT-4: 82%
为了适应不同的开发需求,传言 v4 将采用双版本策略:
旗舰版(Flagship): 专为重度开发设计。针对复杂的多文件项目、架构重构和仓库级(Repository-level)代码理解进行了极致优化。它支持百万级 Token 上下文,彻底终结“长代码遗忘”的行业痛点。
轻量版(Light): 专注于毫秒级响应,是快速编写脚本和实时 Debug 的神兵利器。
除了两个版本发布,DeepSeek 还将发布一个 AI 编程工具:
秘密武器 : 据悉,DeepSeek 将配套发布名为 LIC的命令行工具。 甚至传言 对标 Anthropic 的 Cowork。
这意味着 AI 不再只是对话框里的助手,而是将深度集成进开发者的底层流水线,成为真正“长在终端里”的生产力。
3. 超级战士的三件套:解构 v4 的底层“绝活”
如果将 DeepSeek v4 比作一名冷酷的“算法特种兵”,那么创始人梁文锋近期署名的三篇核心论文,便是赋予其超凡战力的三件顶级装备。
(1)外挂弹药(Engram 架构):知识与推理的深度解耦
传统的 Transformer 模型非常“笨拙”,即便识别一个简单的“戴安娜王妃”,也要动用多层神经网络进行重重计算。
Engram 架构实现了“记忆”与“计算”的分离。 它像是一个高效的“战场火药库”,将海量静态知识存入价格低廉的 CPU 内存(RAM) 中,而非昂贵的显存。
简言之,用相对低成本的 CPU 代替昂贵的 GPU!
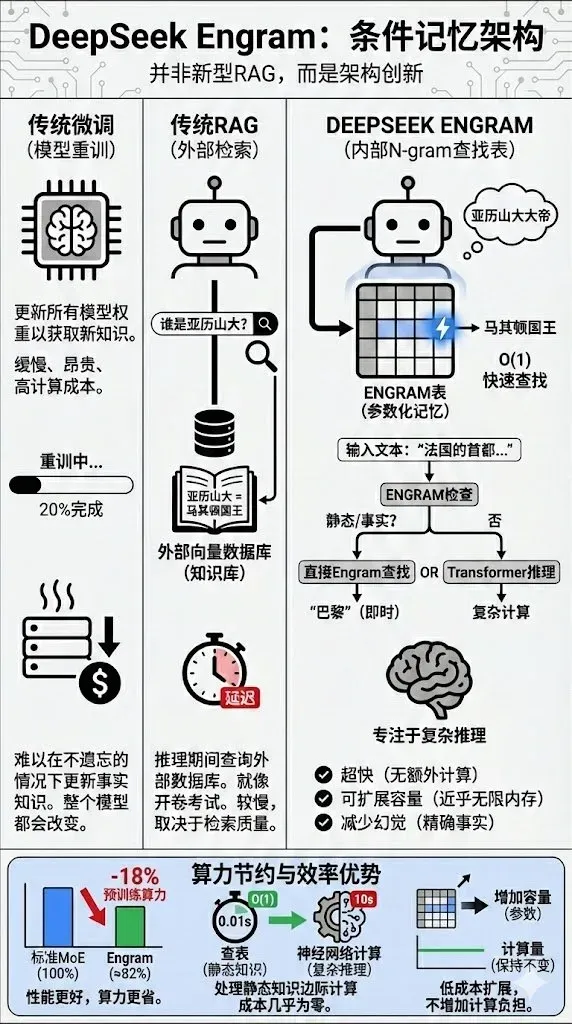
根据论文,这种“空间换智商”的做法将 25% 的参数分配给记忆,75% 的算力留给逻辑推理。这让模型在浅层就解决了“死记硬背”的活,腾出大脑专心刷“算法奥数题”。
(2)蜂群作战阵型(mHC 架构):拓扑结构的革命性突破
DeepSeek 展现了“杀死昨天”的勇气,对沿用了 10 年之久的“残差连接”进行了底层魔改。
mHC(流形约束超连接)引入了数学上的 Sinkhorn-Knopp 算法,利用双随机矩阵约束,攻克了宽模型训练不稳定的世纪难题。
图片
火力覆盖(吞吐量): 既然单个芯片(如 H20)的算力(单机引擎)被锁死了,但传输带宽(路宽)很大,那就搞“人海战术”。mHC 让模型变得极“宽”,就像成千上万架无人机并行冲锋,火力吞吐量极高。
蜂巢思维(流形约束): 无人机多了容易乱撞(梯度爆炸)。mHC 引入的“双随机矩阵”和 Sinkhorn 算法,就像是“蜂巢思维”或“上帝视角的交通指挥”。
它强制要求所有无人机保持能量守恒,队形极其严密,怎么飞都不会炸机(训练稳定),从而用便宜的硬件打出高端的效果。
这意味着 v4 可以做得极宽、极稳,信号在数百层网络中传输依然如履平地。
(3)脑(R1 强化学习):慢思考与知识蒸馏
V4 继承了 R1 的纯强化学习(RL)基因,通过长思维链(CoT)激发模型的“反思”能力。
更关键的是,基于那份著名的 86 页报告,DeepSeek 验证了“能力蒸馏”的可行性——推理能力可以从巨型模型无损迁移至小模型。这正是 v4 在保持极致能效比的同时,智商依然在线的终极秘诀。
4. 算法美学 vs. 暴力美学:戴着镣铐的独舞
长期以来,AI 界存在两条路线的博弈:OpenAI 崇尚的 Scale Law(暴力美学) 与 DeepSeek 坚持的算法创新。
面对比中国 AI 算力高出一个当量的硅谷,DeepSeek 坚定地选择了后者。
DeepSeek 的工程美学在于:“既然造不出重型卡车,那我们就把重卡拆解成一万辆摩托车并行狂飙。”
mHC 架构简直是针对特定硬件环境(算力封锁)的神级突破。它在“戴着镣铐”的极端环境下,通过极致的算法优化,实现了性能逆袭。
对于苦算力久矣的全球中小企业而言,完全开源免费的 DeepSeek v4 不仅仅是一个模型,它是真正的生产力解放,是开源软件的胜利。
结语:德鲁克式创新——重塑雕像的权利
DeepSeek v4 完美突破了“创新者的窘境”,没有随波逐流卷入盲“人傻钱多”的算力军备竞赛,而是通过对模型痛点的深度系统思考,给出了底层的技术解法。
这种敢于抛弃陈旧范式(如残差连接)、引入全新架构(Engram & mHC)的勇气,是中国 AI 团队对全球技术效率提升做出的独特贡献。
DeepSeek 向世界证明:创新不是运气的博弈,而是一种厚积薄发,敢于重构底层的勇气。
下个月,且看这名“算法战士”如何再次改写游戏规则!
最后,留给大家几个悬念:
这一次,DeepSeek v4 的发布,将为 AI 编程注入怎样的新鲜血液?
它是否会成为压垮“算力泡沫”的最后一根稻草?
全球资本市场又将如何重新定价“中国智慧”?
让我们拭目以待。把你的看法打在评论区!
DeepSeek V3 文章集锦:
人人都是销冠!DeepSeek R1 + 腾讯ima + 私有知识库,免费0代码打造销售团队'AI外脑',私有销售话术安全共享!
清华内部流出!DeepSeek神级操作手册集锦,月薪3万大厂员工都在偷偷学
教师新技能Get√!DeepSeek制作交互动画,枯燥公式秒变吸睛教具!(多学科适用)
DeepSeek 焕新升级,一键打造小红书/小绿书爆款卡片!
中国AI DeepSeek 升级,为什么印度人最开心?飞机又有了!
