当前位置:首页>python>【Python毕设】Hadoop+Django全球大学排名数据可视化系统完整实现 毕业设计 选题推荐 毕设选题 数据分析 机器学习 数据挖掘

【Python毕设】Hadoop+Django全球大学排名数据可视化系统完整实现 毕业设计 选题推荐 毕设选题 数据分析 机器学习 数据挖掘

  • 2026-10-21 13:27:07
【Python毕设】Hadoop+Django全球大学排名数据可视化系统完整实现 毕业设计 选题推荐 毕设选题 数据分析 机器学习 数据挖掘

基于Hadoop+Django的全球大学排名数据可视化分析系统

一
全球大学排名数据可视化分析系统-简介

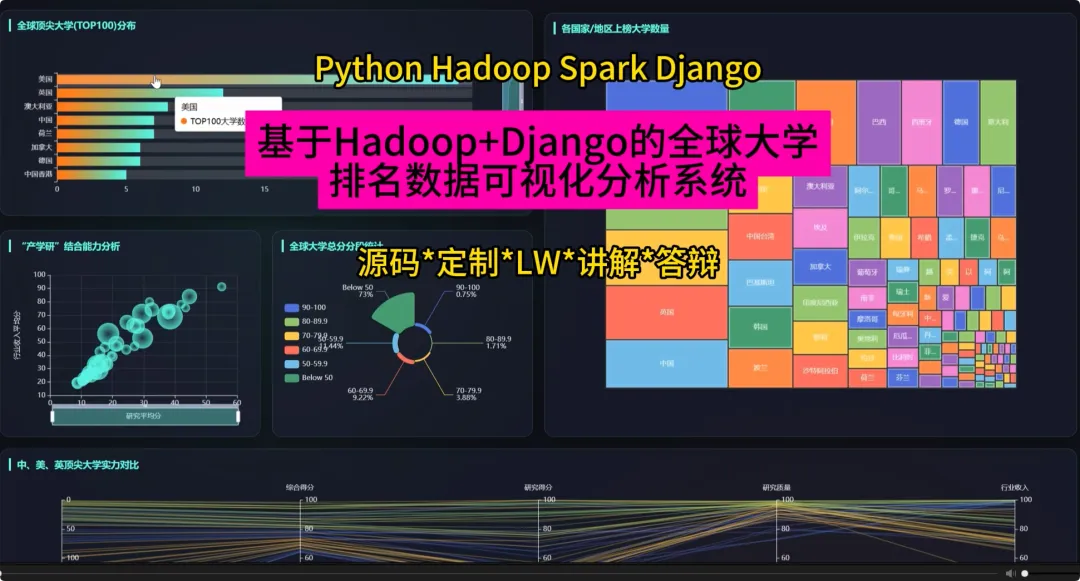
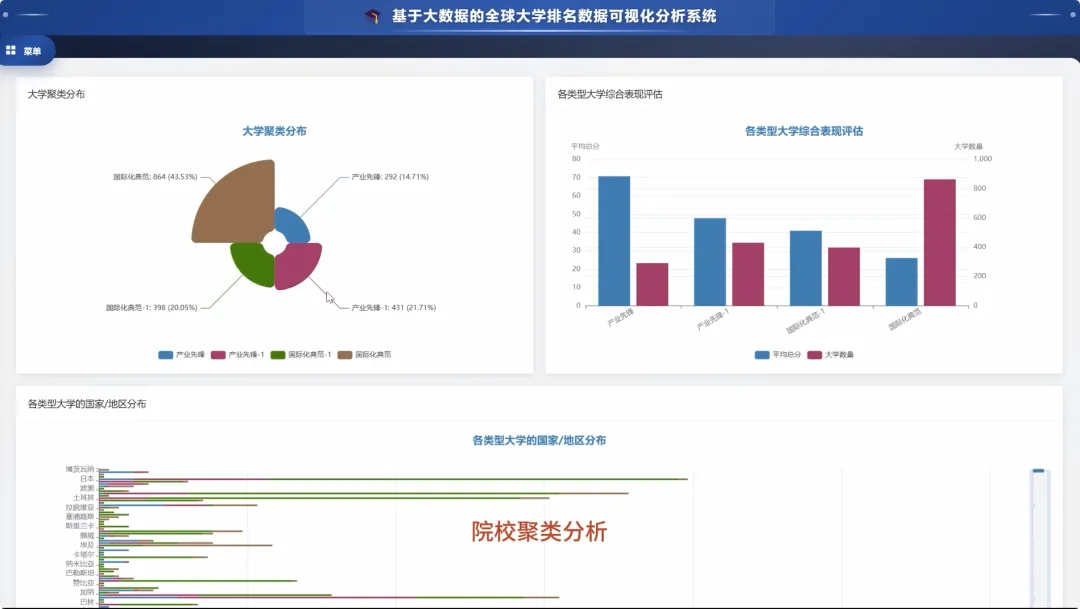
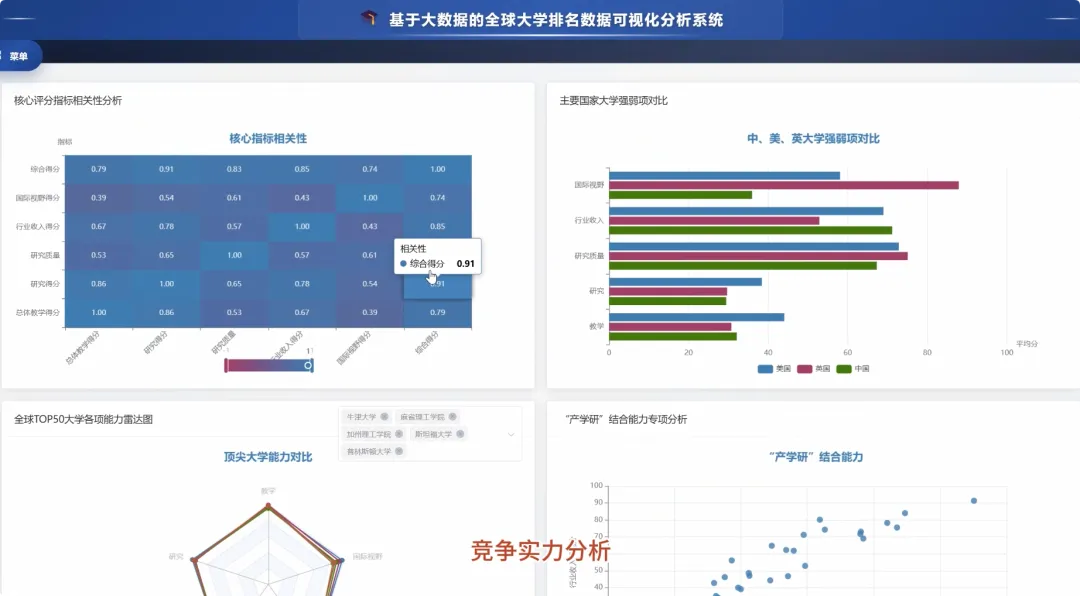
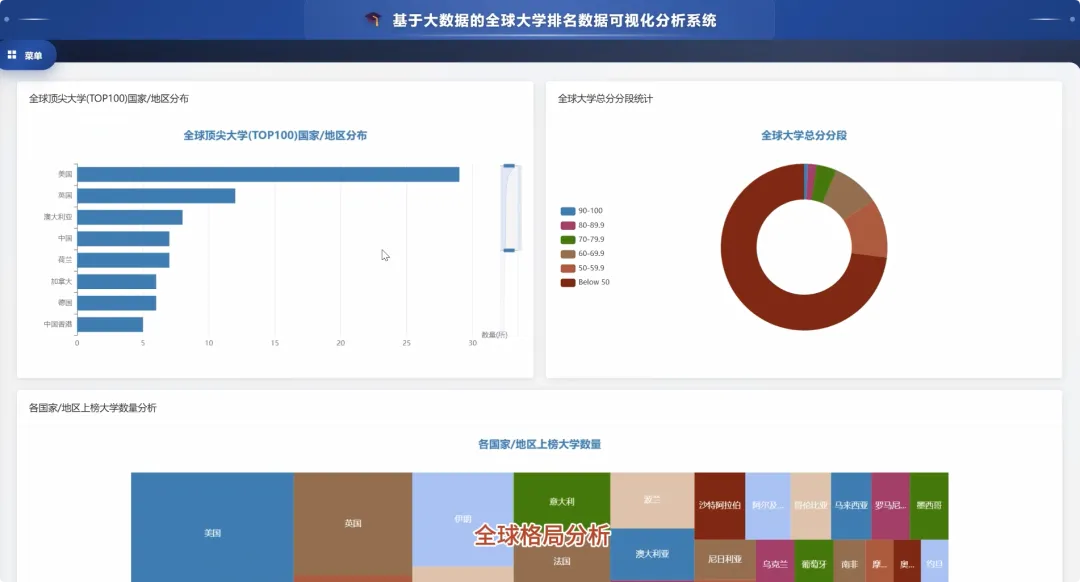
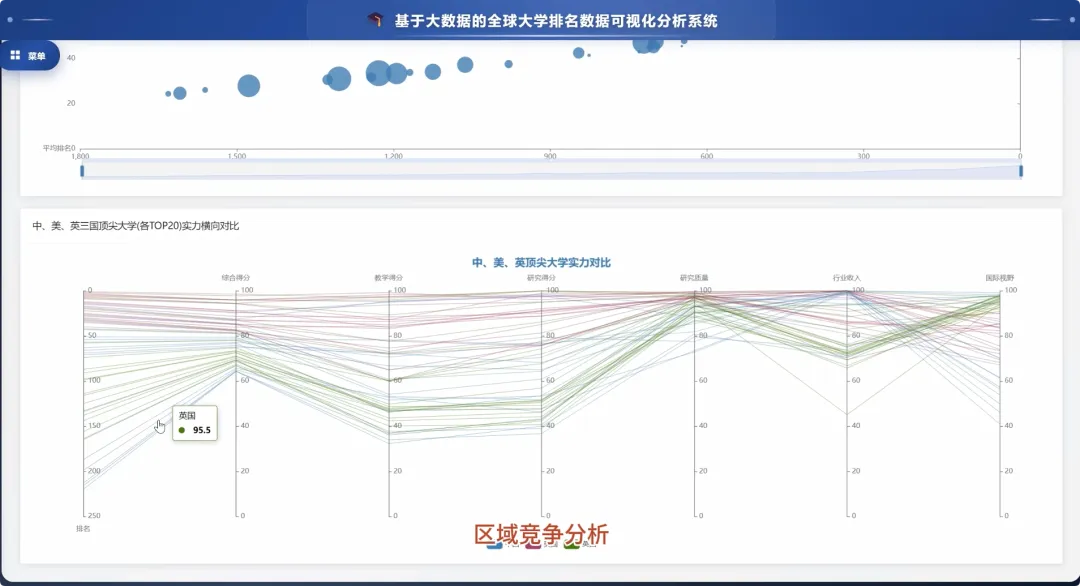
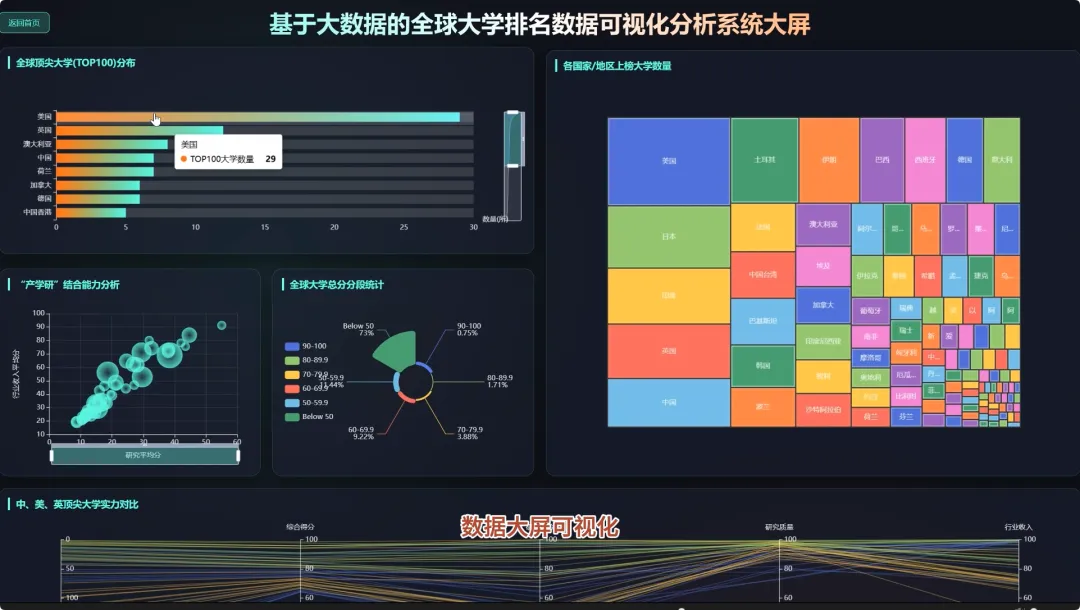
本系统“基于Hadoop+Django的全球大学排名数据可视化分析系统”是一个集大数据处理、分析与前端展示于一体的综合性解决方案。在技术架构上,系统采用Hadoop HDFS作为海量大学排名数据的分布式存储底座,确保数据的可靠性与高可用性。核心数据处理与分析环节则交由强大的Spark计算引擎执行,利用Spark SQL对存储在HDFS中的结构化数据进行高效的查询、聚合与转换,并结合Python生态中的Pandas与NumPy库进行复杂的数据清洗与预处理,最终将分析结果以CSV形式持久化。后端服务基于Python的Django框架搭建,负责响应前端请求,提供处理好的数据API接口。前端则采用现代化的Vue.js框架,结合ElementUI组件库与强大的Echarts可视化图表库,将后端传递的数据动态渲染为直观的交互式图表,如世界地图、柱状图、雷达图及散点图等。系统功能规划严谨,从宏观的全球大学排名总体格局分析,到深入的核心竞争力指标相关性剖析,再到聚焦特定区域与国家的教育竞争力专题,最后创新性地引入基于K-Means聚类算法的大学类型画像分析,实现了从数据到洞察、从宏观到微观、从描述到预测的多层次、全方位数据价值挖掘。

二
全球大学排名数据可视化分析系统-背景

选题背景

随着全球化进程的不断加深,跨国求学和学术交流已成为许多学生和学者的选择。面对纷繁复杂的各类世界大学排名,如何从海量数据中快速、直观地洞察全球高等教育的整体格局与竞争态势,成为了一个现实需求。现有的排名网站大多只提供简单的查询和排序功能,缺乏深度的、多维度的对比分析,用户很难形成一个系统性的认知。特别是对于关注特定国家或地区教育发展的人来说,想要了解不同国家大学的优势与短板,或者探究顶尖大学的成功特质,往往需要耗费大量时间手动整理和比较数据。这种信息处理上的不便,恰恰为计算机专业的学生提供了一个很好的实践机会,即利用大数据技术,对这类公开数据进行系统性的整合、分析与可视化,从而打造一个更加智能、直观的分析工具。

选题意义

本课题的意义在于,它将大数据技术应用于一个与公众生活息息相关的教育领域,具有不错的实践价值。对于即将面临升学选择的学生和家长而言,本系统提供了一个直观的决策辅助工具,能够帮助他们超越简单的排名数字,从教学、研究、国际化等多个维度全面了解大学,做出更符合自身发展规划的选择。从技术实践的角度看,这个项目完整地走过了从数据采集、存储、清洗、分析到可视化展示的全流程,是对Hadoop、Spark等主流大数据技术的一次综合运用,能有效锻炼开发者处理真实世界数据问题的能力。此外,系统中引入的聚类分析功能,尝试从数据中自动发现大学的类型特征,这为教育评估提供了一种新的、数据驱动的参考视角,虽然只是一个毕业设计,但也希望能为相关领域的研究者带来一些启发和便利。

三
全球大学排名数据可视化分析系统-技术框架展示

开发语言:Python或Java

大数据框架:Hadoop+Spark(本次没用Hive,支持定制)

后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)

前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery

详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy

数据库:MySQL

四
全球大学排名数据可视化分析系统-视频展示
已关注
关注
重播 分享 赞
【三重痛点】数据采集难+分析难+展示难?Hadoop+Django系统全搞定
五
全球大学排名数据可视化分析系统-图片展示
六
全球大学排名数据可视化分析系统-代码展示
from pyspark.sql import SparkSessionfrom pyspark.sql.functions import col, countDistinct, descfrom pyspark.ml.feature import VectorAssemblerfrom pyspark.ml.clustering import KMeansimport pandas as pdspark = SparkSession.builder.appName("UniversityRankingAnalysis").getOrCreate()def analyze_country_distribution(df):    country_counts_df = df.groupBy("Location").agg(countDistinct("University").alias("university_count"))    sorted_counts_df = country_counts_df.orderBy(desc("university_count"))    pandas_df = sorted_counts_df.toPandas()    pandas_df.to_csv("/output/country_distribution.csv", index=False)    print("各国上榜大学数量分析完成,结果已保存")    return pandas_dfdef analyze_core_metrics_correlation(df):    metrics_cols = ["Overall Teaching Score", "Research Score", "Research Quality", "Industry Income Score", "International Outlook Score", "Overall Score"]    metrics_df = df.select(metrics_cols).na.fill(0)    pandas_metrics_df = metrics_df.toPandas()    correlation_matrix = pandas_metrics_df.corr()    correlation_matrix.to_csv("/output/metrics_correlation.csv")    print("核心指标相关性分析完成,矩阵已保存")    return correlation_matrixdef perform_university_clustering(df):    feature_cols = ["Overall Teaching Score", "Research Score", "Research Quality", "Industry Income Score", "International Outlook Score"]    assembler = VectorAssembler(inputCols=feature_cols, outputCol="features")    assembled_data = assembler.transform(df.na.fill(0, subset=feature_cols))    kmeans = KMeans(k=4, seed=1, featuresCol="features", predictionCol="cluster")    model = kmeans.fit(assembled_data)    clustered_df = model.transform(assembled_data)    result_df = clustered_df.select("University", "Location", "cluster")    result_pandas_df = result_df.toPandas()    result_pandas_df.to_csv("/output/university_clusters.csv", index=False)    print("大学聚类分析完成,结果已保存")    return result_pandas_df
七
联系我们
扫码关注我们
商务合作
公众号:计算机编程指导师

~~感谢您抽出宝贵时间来阅读此文~~

最新文章

随机文章