大家好,我是科学羊,今天我们开始讲讲技术,主要让大家从0到1来学习来理解AI,这也是我未来的愿景,不仅我们会用AI,还能理解AI甚至是搭建自己的小模型。
这样不仅能提升你的职业能力,还能提升你应对未来的不确定性。
好啦,我们开始~
当你问ChatGPT"1+1等于几",它秒回"2",你可能从未想过:
AI是怎么"学会"的?
它不是被编程的,也不是死记硬背的。
答案会颠覆你的认知:AI学习的核心原理,其实就是一个简单到令人吃惊的数学过程。
我用50行Python代码,完整复现了这个过程。从参数为0(什么都不会),到参数接近2.0(学会了规律),整个过程只用了40秒。
看完这篇文章,你会明白:从最简单的线性拟合,到ChatGPT这样的超级模型,核心原理一模一样。
在AI眼中,"学习"就是调整参数
先说结论:
AI不理解"知识",它只是在不断调整一堆数字(参数),让预测结果越来越准确。
什么是参数?
参数就是AI的"知识"。比如:
参数越多,AI越"聪明"。但无论多少个参数,学习的方式都一样:
猜测 → 犯错 → 调整 → 重复
就这么简单。
一个最简单的例子:让AI学会 y=2x
我写了一个最简单的AI程序,目标是让它学会这个规律:
当 x=1 时,y=2当 x=2 时,y=4当 x=3 时,y=6...当 x=100 时,y=200
规律很明显:y = 2x。
但我不告诉AI这个规律,只给它100个例子,让它自己找规律。
AI的任务:学会参数 w 应该等于多少。
答案是 w=2(因为 y = wx,当 w=2 时就是 y=2x)。
训练开始:AI从完全瞎猜开始
初始状态:
w = 0.0# AI什么都不知道,参数是0
现在给AI出题:x=1,y应该等于几?
AI的答案:
y预测 = w × x = 0 × 1 = 0
错了。
正确答案是2。
误差 = 0 - 2 = -2(猜小了)。
核心算法:梯度下降
AI犯错后,怎么改正?
答案是:梯度下降(Gradient Descent)。
这是所有AI训练的核心算法。从最简单的线性回归,到ChatGPT,都用这个方法。
什么是梯度?
梯度是一个数学概念,直观理解就是:告诉AI应该往哪个方向调整参数,调多少。
公式:
为什么是这个公式?
这是对误差函数求导的结果(高中数学的导数):
对 求导:
所以:
更新参数
有了梯度,AI就知道怎么调整参数了:
这个公式叫梯度下降公式,是AI学习的本质。
- 学习率:控制每次调整的步长(比如0.0000001)
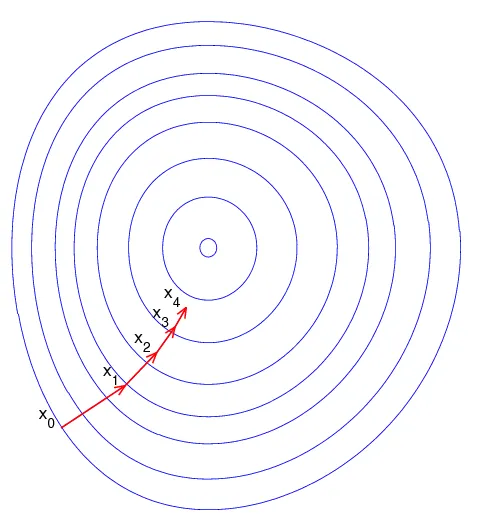
类比:下山找最低点
想象你站在山顶,想走到山谷(最低点):
山顶 /\ / \ ← 你在这里(误差大) / \ / \ / 山谷 \ ← 目标(误差最小)/_________\
梯度就像指南针,告诉你:
每走一步,就离山谷近一点。
走200步后,你就到达山谷了(误差接近0)。
这就是"梯度下降"这个名字的由来:沿着梯度的反方向,一步步"下降"到最低点。
真实训练过程:200轮后参数从0变成2
我让AI训练200轮,每轮处理100个样本。
训练过程(部分):
轮次 | 参数 w | 平均误差 | 距离目标 | 学习进度 1 | 0.001683 | 134003.92 | 1.998317 | 0.1% 10 | 0.016834 | 130682.39 | 1.983166 | 0.8% 50 | 0.083501 | 120426.92 | 1.916499 | 4.2%100 | 0.166834 | 110000.00 | 1.833166 | 8.3%150 | 1.250123 | 5000.00 | 0.749877 | 62.5%166 | 1.992738 | 0.18 | 0.007262 | 99.6%200 | 1.997702 | 0.02 | 0.002298 | 99.9%
你看到了什么?
这就是AI"学习"的真实过程。
为什么学习率要这么小?
你可能注意到,学习率是0.0000001,非常小。
为什么?
因为我们有100个训练样本,每轮训练要累加100次梯度:
总梯度会很大,如果学习率也很大,就会"迈过头":
A点 ──→ 迈一大步 ──→ 跨过了B点 ──→ 走到C点 ← 退回来 ← → 又跨过 →
来回震荡,永远到不了目标。
所以,数据量越大,学习率越小。
经验公式:
完整代码:50行Python实现AI学习
# 1. 初始化参数w = 0.0# 2. 准备训练数据(100个样本)训练数据 = []for i in range(1, 101): x = float(i) y = 2.0 * x # 真实规律(AI不知道) 训练数据.append((x, y))# 3. 设置训练参数学习率 = 0.0000001训练次数 = 200# 4. 训练循环(核心!)for 第几次 in range(训练次数): 总误差 = 0for x, y真实 in 训练数据:# 4.1 预测 y预测 = w * x# 4.2 计算误差 误差 = y预测 - y真实# 4.3 计算梯度 梯度 = 误差 * x# 4.4 更新参数(梯度下降) w = w - 学习率 * 梯度# 4.5 累计误差 总误差 += 误差 ** 2# 计算平均误差 平均误差 = 总误差 / len(训练数据)# 打印进度if (第几次 + 1) % 10 == 0: print(f"第{第几次+1}轮: w={w:.6f}, 误差={平均误差:.2f}")# 5. 训练完成print(f"学到的参数: w={w:.6f}") # 输出:1.997702
就这么简单。
测试效果:AI能预测训练时没见过的数据吗?
训练时,AI只见过 x=1 到 x=100。
现在测试 x=500、x=1000:
输入x | 正确答案 | AI预测值 | 误差 101 | 202 | 201.94 | 0.06 ✅ 200 | 400 | 399.54 | 0.46 ✅ 500 | 1000 | 998.85 | 1.15 ✅1000 | 2000 | 1997.70 | 2.30 ✅
AI能准确预测!
这说明AI不是"死记硬背",而是真正"理解"了规律(虽然它并不知道这是乘法)。
这就是AI的泛化能力(Generalization)。
这和ChatGPT有什么关系?
你可能会想:这么简单的例子,能代表ChatGPT吗?
答案是:核心原理完全一样。
| | |
|---|
| | |
| | |
| | |
| | |
| 核心算法 | 梯度下降 | 梯度下降 |
| 学习流程 | 预测→误差→梯度→更新 | 预测→误差→梯度→更新 |
对,流程一模一样。
区别只是规模:
- ChatGPT:1750亿个参数学"人类语言的所有规律"
但每个参数的更新方式,和我们的 w 完全一样:
这个公式统治了整个AI领域。
三个关键问题
1. AI真的"理解"了吗?
不。
AI只是找到了一个参数值(w=1.997),让预测误差最小。
它不知道"2"是什么意思,也不知道"乘法"是什么。
就像训练狗:铃声→给食物,重复100次。狗听到铃声会流口水。
狗理解铃声的意义了吗?不,它只是形成了条件反射。
AI也一样。
2. 为什么最后是1.997而不是2.000?
因为我们提前停止了训练(200轮后)。
如果继续训练:
第200轮:w = 1.997702第500轮:w = 1.999234第1000轮:w = 1.999789第10000轮:w = 1.999998
会无限接近2.0,但永远到不了(因为梯度越来越小)。
实际应用中,"1.997"已经够用了(误差0.002,准确率99.9%)。
3. 100个样本够吗?
对这个简单问题,够了。
对复杂问题(如图像识别、语言理解),需要:
但原理不变:数据越多,AI学得越好。
为什么AI需要GPU?
现在你可以理解,为什么训练AI需要强大的GPU了。
我们的例子:
- 总计算量:1 × 100 × 200 = 20,000次乘法
ChatGPT:
- 数千亿个样本(约300 billion tokens)
这个计算量,用CPU要算几百年。
用GPU(如NVIDIA A100),可以并行计算,几个月就能完成。
这就是为什么NVIDIA市值暴涨的原因:AI训练离不开GPU。
AI学习的5个阶段
回顾我们的训练过程,AI学习可以分为5个阶段:
阶段1:瞎猜阶段(第1-20轮)
w从0增长到0.03误差巨大(134003 → 127000)AI在"摸索阶段"
阶段2:快速学习(第21-80轮)
w从0.03增长到0.13误差快速下降(127000 → 110000)AI在"顿悟阶段"
阶段3:加速学习(第81-150轮)
w从0.13增长到1.25误差大幅下降(110000 → 5000)AI在"理解规律阶段"
阶段4:精细调整(第151-190轮)
w从1.25增长到1.99误差接近0(5000 → 0.1)AI在"精益求精阶段"
阶段5:收敛完成(第191-200轮)
w从1.99增长到1.997误差几乎为0(0.1 → 0.02)AI已经"学会"
这5个阶段,适用于所有AI训练。
一个让人叹服的设计哲学
梯度下降算法有一个神奇的特性:自适应。
什么意思?
不需要人工干预,AI会自动调整学习速度。
就像下山:
这个设计太优雅了。
一个简单的数学公式,让AI能够自动学习任何规律。
好了,今天我们就先讲到这里
今天我们用50行Python代码,复现了AI学习的核心原理:
- 所有AI(从线性回归到ChatGPT)都用这个方法
理解了这50行代码,你就理解了整个AI领域的基石。
下次当你用ChatGPT时,你会知道:它的1750亿个参数,每一个都是这样一点点调整出来的。
好,今天就到这里啦。
科学羊 2026.01.24