当前位置:首页>python>Python+Hadoop大数据项目:道路交通事故数据可视化分析系统源码 毕业设计 选题推荐 毕设选题 数据分析 机器学习 数据挖掘

Python+Hadoop大数据项目:道路交通事故数据可视化分析系统源码 毕业设计 选题推荐 毕设选题 数据分析 机器学习 数据挖掘

  • 2026-08-25 15:05:22
Python+Hadoop大数据项目:道路交通事故数据可视化分析系统源码 毕业设计 选题推荐 毕设选题 数据分析 机器学习 数据挖掘
基于Hadoop的道路交通事故数据可视化分析系统
一

道路交通事故数据可视化分析系统-简介

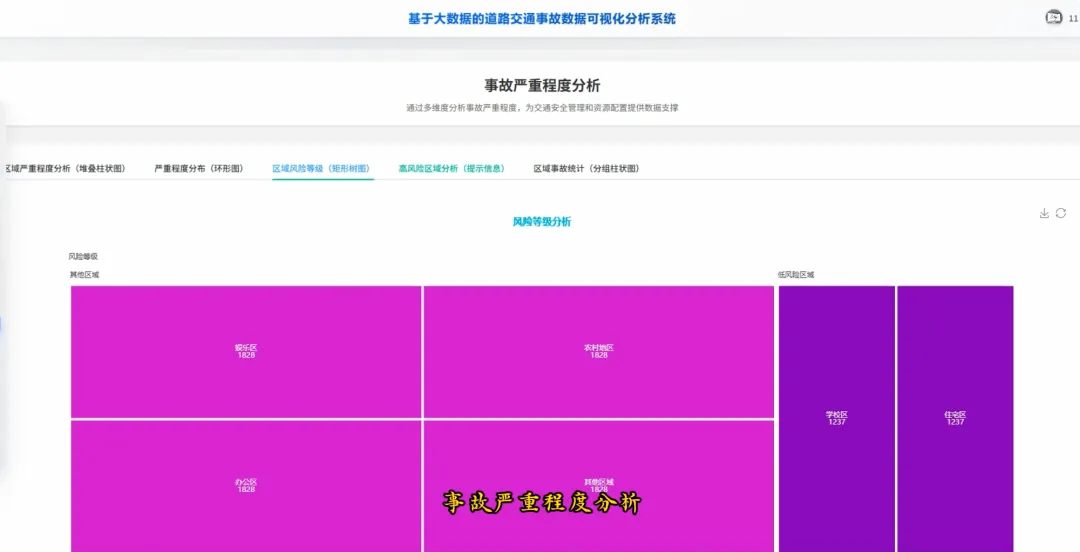
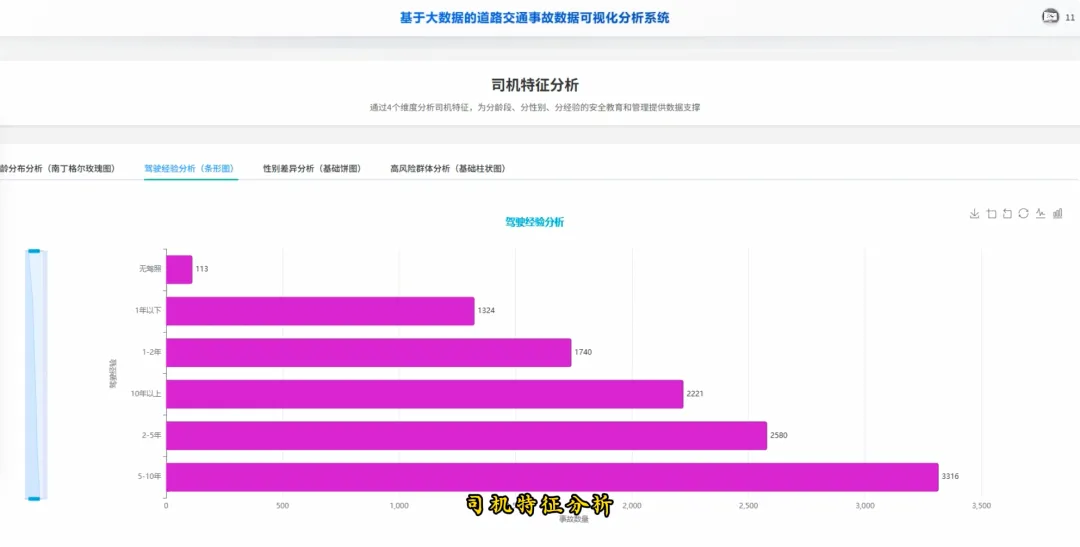
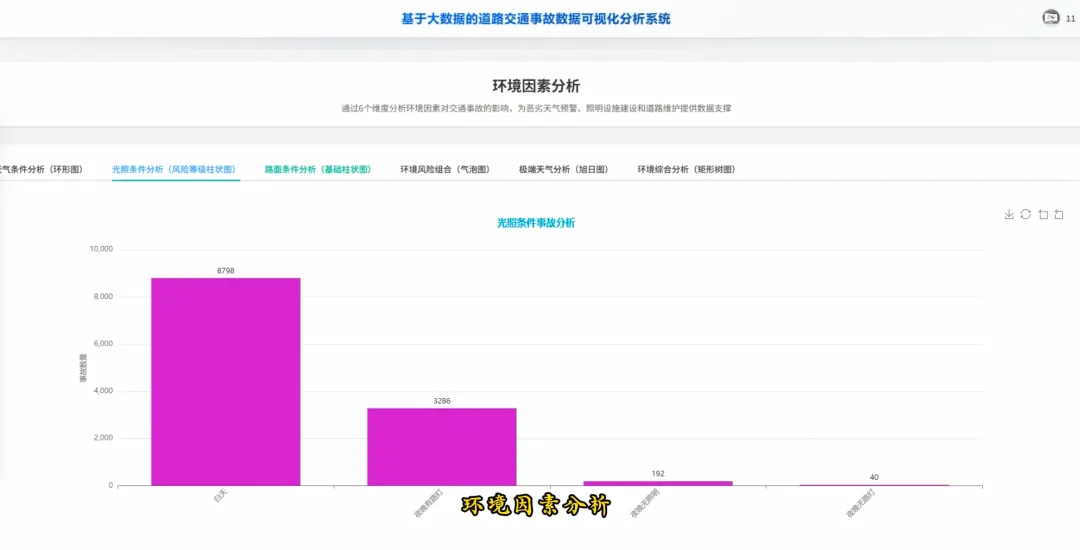
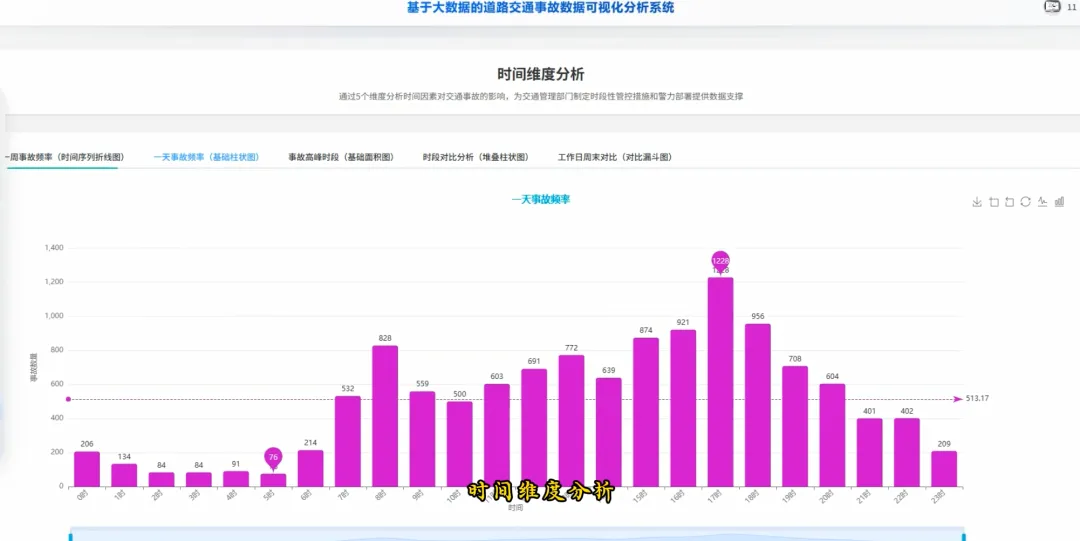
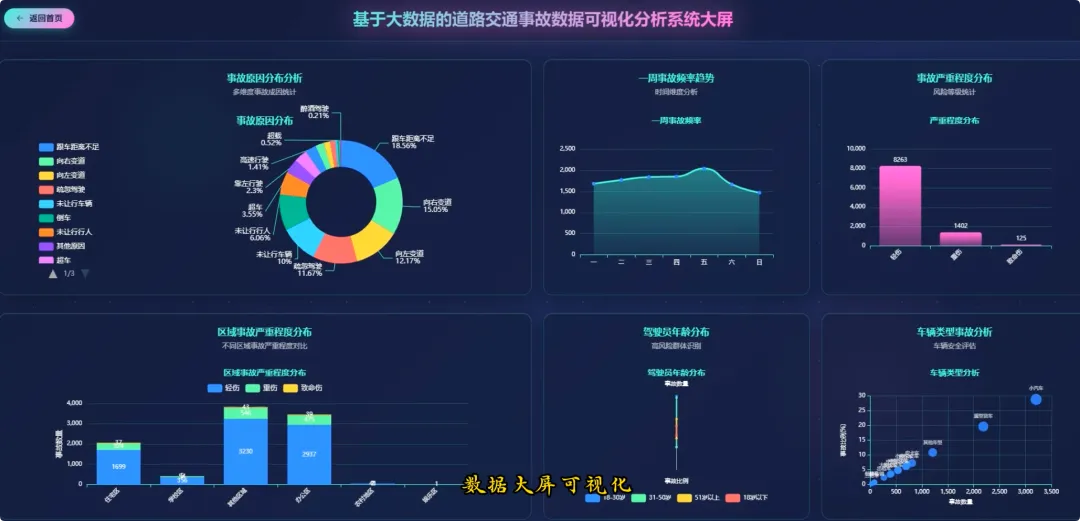
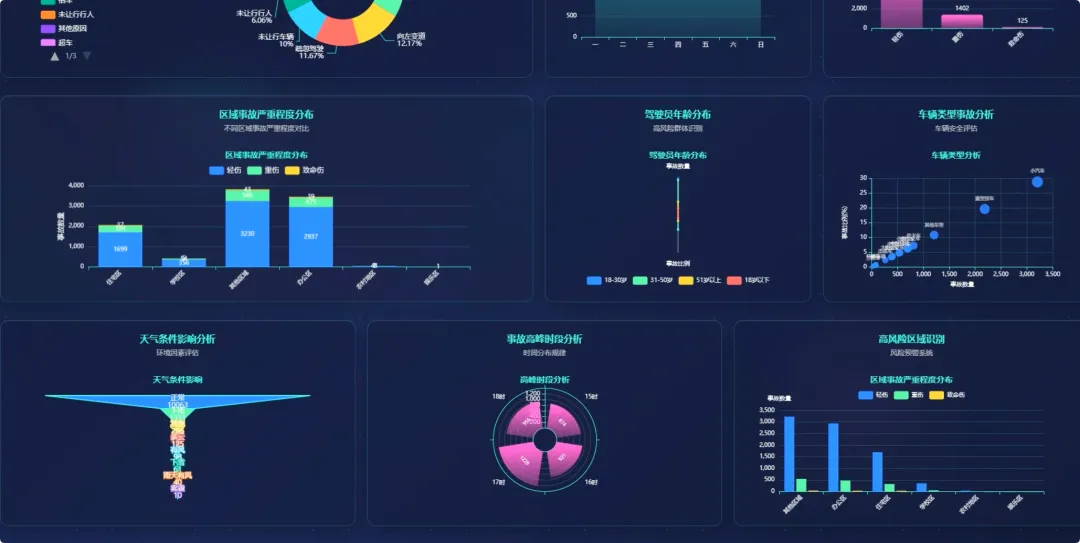
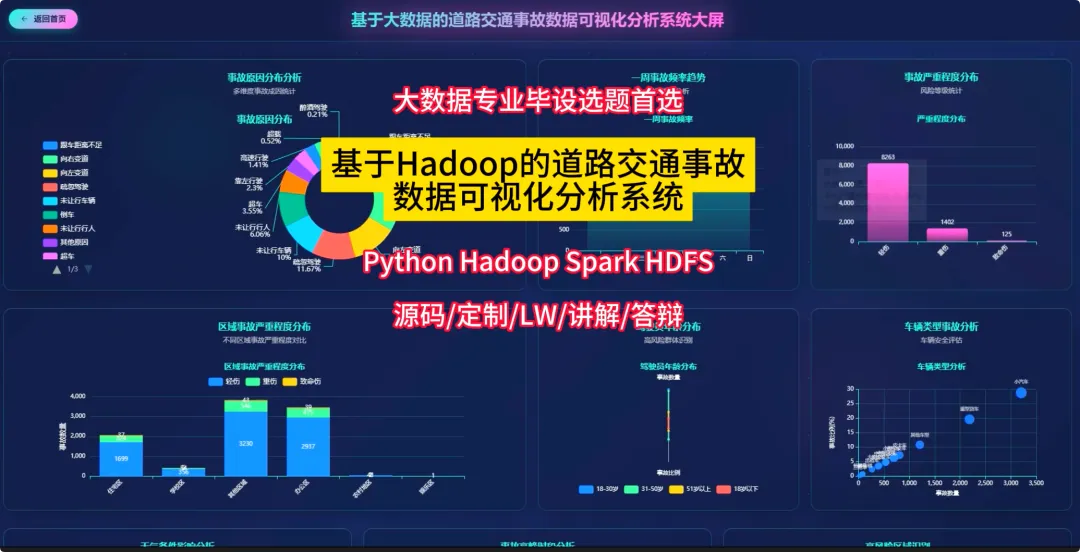
本系统“基于Hadoop的道路交通事故数据可视化分析系统”旨在构建一个高效、可扩展的大数据分析平台,以应对海量交通事故数据的处理挑战。系统整体架构基于Hadoop生态,利用HDFS作为底层分布式文件系统,实现对原始事故数据的海量存储与高容错性。核心计算引擎采用Apache Spark,通过其内存计算能力和强大的RDD、DataFrame API,结合Spark SQL进行交互式查询,对存储在HDFS中的数据进行快速清洗、转换和多维度聚合分析,极大地提升了数据处理效率。后端服务采用Python语言及Django框架开发,负责业务逻辑处理、与Spark集群交互获取分析结果,并通过RESTful API的形式向前端提供数据接口。前端界面则基于Vue.js框架,结合ElementUI组件库与Echarts可视化图表库,将Spark分析出的复杂结果,如时间维度的事故频率、司机特征的风险分布、环境因素的影响程度等,以直观、动态的图表形式呈现给用户,实现了从数据存储、分布式计算到前端可视化展示的完整大数据分析流程。

二

道路交通事故数据可视化分析系统-背景

选题背景

随着城市化进程的加快和机动车保有量的持续增长,道路交通安全问题日益凸显,交通事故数据量也随之急剧增加。这些数据蕴含着丰富的信息,比如事故发生的时间规律、涉事司机的特征、环境因素的影响等。然而,传统的数据处理方式面对如此庞大且复杂的数据集时,往往显得力不从心,难以进行深层次、多维度的有效分析,导致许多有价值的规律被淹没在海量数据中。交通管理部门虽然积累了大量的数据,但缺乏高效的分析工具来将这些数据转化为指导实际工作的决策依据,这使得交通管理和事故预防工作在一定程度上存在盲目性。因此,如何利用现代大数据技术,对这些事故数据进行系统性的挖掘与分析,找出事故背后的深层原因和规律,成为一个亟待解决的现实问题。

选题意义

本课题的研究具有一定的理论价值和实际应用意义。从理论层面看,它完整地实践了Hadoop与Spark技术栈在特定领域数据分析中的应用,为处理类似大规模、多维度数据集提供了一个可行的技术方案参考,对学习大数据技术的同学来说是一个很好的综合性项目案例。从实际应用层面来看,本系统能够帮助交通管理部门更清晰地了解辖区内的交通安全状况。例如,通过时间维度分析,可以合理调配警力资源;通过司机特征分析,可以开展更具针对性的安全宣传教育;通过环境因素分析,可以为道路基础设施的改善提供数据支持。虽然这只是一个毕业设计,但其分析结果可以为相关决策提供一些参考,有助于提升交通管理的科学性和精准性,对预防和减少交通事故的发生有着积极的推动作用,体现了技术服务于社会的理念。

三

道路交通事故数据可视化分析系统-技术框架

开发语言:Python+Java

后端框架大数据框架:Hadoop+Spark(本次没用Hive,支持定制)

:Django+Spring Boot(Spring+SpringMVC+Mybatis)

前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery

数据库:MySQL

四

道路交通事故数据可视化分析系统-视频展示

已关注
关注
重播 分享 赞

大数据毕设没方向?基于Hadoop的道路交通事故分析系统帮你一次通过

五

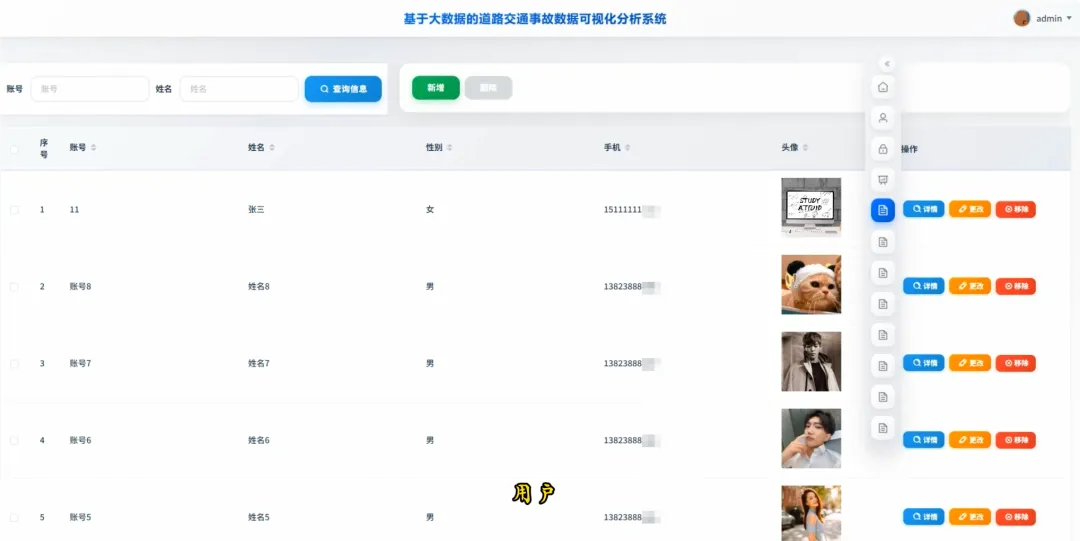
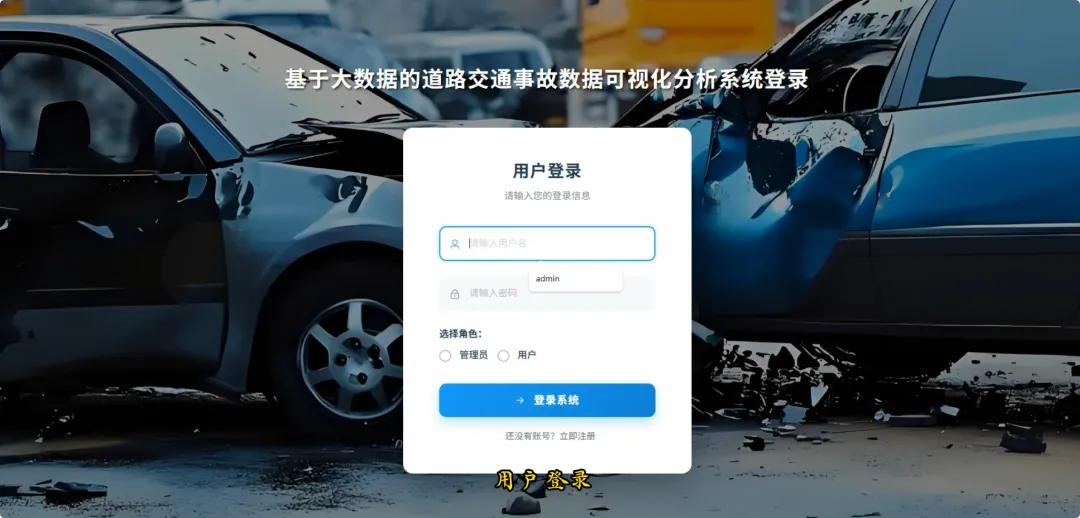
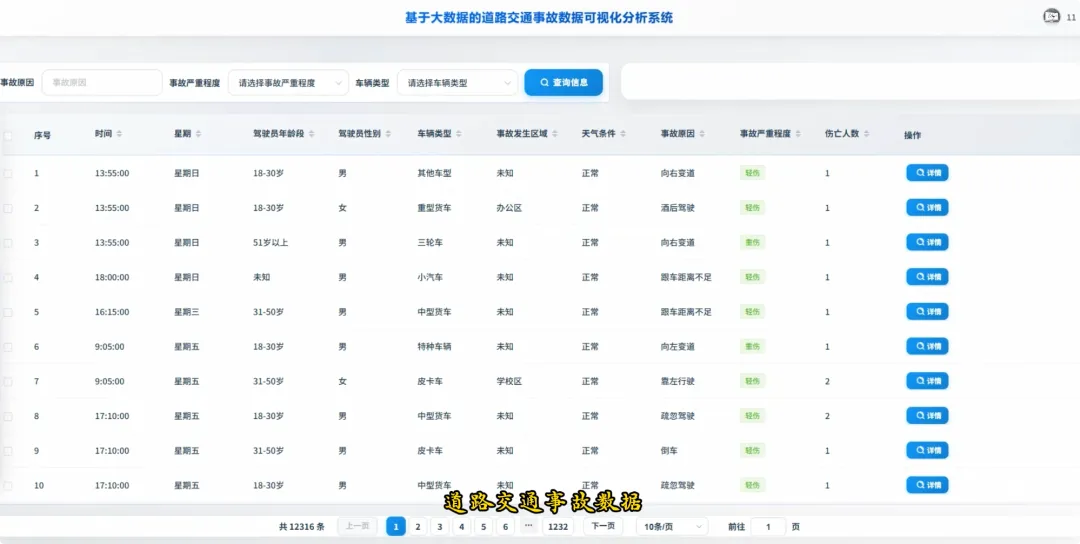
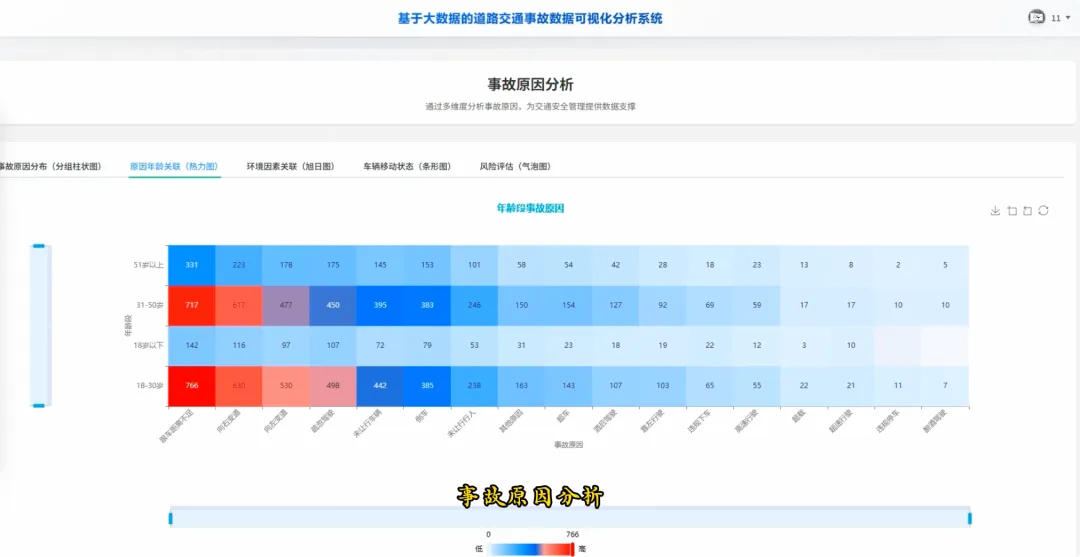
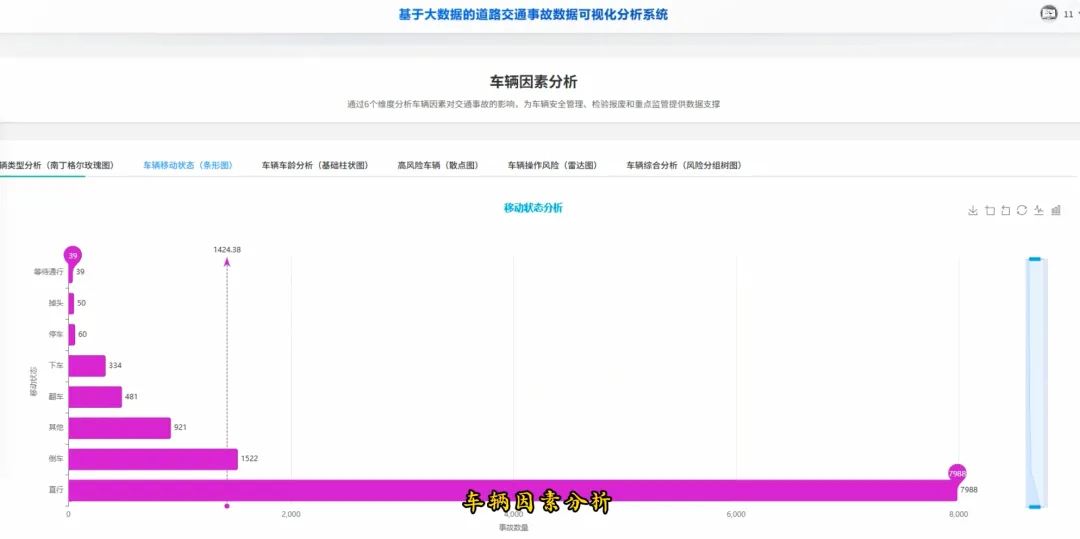
道路交通事故数据可视化分析系统-图片展示

六

道路交通事故数据可视化分析系统-代码展示

from pyspark.sql import SparkSessionspark = SparkSession.builder.appName("TrafficAccidentAnalysis").getOrCreate()df = spark.read.csv("hdfs://localhost:9000/accident_data.csv", header=True, inferSchema=True)df.createOrReplaceTempView("accidents")def analyze_weekly_accidents():    print("开始分析一周内事故发生频率...")    result_df = spark.sql("SELECT Day_of_week, COUNT(*) as accident_count FROM accidents WHERE Day_of_week IS NOT NULL GROUP BY Day_of_week ORDER BY accident_count DESC")    results = result_df.collect()    print("分析完成,结果如下:")    for row in results:        print(f"星期{row['Day_of_week']}: {row['accident_count']}起事故")    return resultsdef analyze_driver_age():    print("开始分析不同年龄段司机事故率...")    result_df = spark.sql("SELECT Age_band_of_driver, COUNT(*) as accident_count FROM accidents WHERE Age_band_of_driver IS NOT NULL AND Age_band_of_driver != 'Unknown' GROUP BY Age_band_of_driver ORDER BY accident_count DESC")    results = result_df.collect()    print("分析完成,结果如下:")    for row in results:        print(f"年龄段 {row['Age_band_of_driver']}: {row['accident_count']}起事故")    return resultsdef analyze_weather_severity():    print("开始分析天气条件对事故严重程度的影响...")    result_df = spark.sql("SELECT Weather_conditions, Accident_severity, COUNT(*) as count FROM accidents WHERE Weather_conditions IS NOT NULL AND Accident_severity IS NOT NULL GROUP BY Weather_conditions, Accident_severity ORDER BY Weather_conditions, count DESC")    results = result_df.collect()    print("分析完成,结果如下:")    for row in results:        print(f"天气: {row['Weather_conditions']}, 严重程度: {row['Accident_severity']}, 事故数: {row['count']}")    return results
七

联系我们

商务合作

关注公众号:

计算机毕设指导师

~~感谢您抽出时间来阅读此文~~

最新文章

随机文章