工作中一个博士同事,代码写的一坨屎,需求不了解就直接开搞,埋了很多坑.明明做的效果不怎么样,但是领导还是很看重,无解了
- 2026-10-14 11:51:40
将Python客栈设为“星标⭐” 第一时间收到最新资讯
刚看到个贴子,说有网友吐槽公司里一个博士同事,代码写得乱七八糟,需求也不懂就上,坑都是别人填,效果一般,领导却对他格外上心,楼主直接感叹:学历面前,能力不值钱。
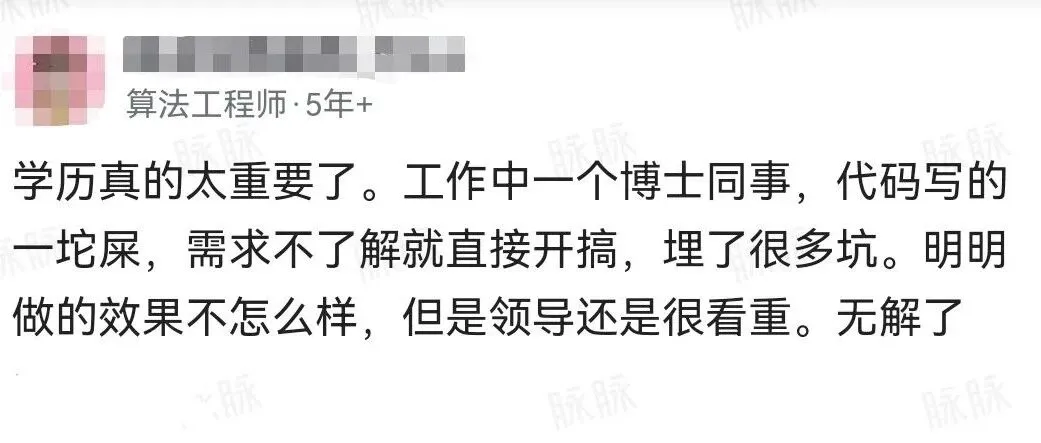
网友们的回复我看了看,有骂领导只认学历的,有说博士会来事的,也有人劝楼主看开点。我觉得这事吧,学历确实很重要,它就像一块长期有效的推荐信,领导天然更信任,这很现实。
但换个角度,真正在团队里站得住的,还是稳定输出的价值。博士可能负责对外交接、写方案、撑门面,这些东西你未必看得见;而你加班写的代码,领导也未必懂得评估。
面试题:多线程网页爬虫
那天晚上快十点,我在公司楼下便利店买泡面,手机那头我们组小李一通抱怨:单线程那个网页爬虫跑一千多页,电脑风扇快起飞了,人还得干等。领导说一句很轻松:“搞成多线程的嘛”,转身就走了,留下我们仨面面相觑,典型甩锅现场。
你想想啊,一个线程从种子网址开始,一页一页往下爬,就像一个人挨家挨户送快递,速度肯定感人。多线程其实特别像拉一车同事一块儿送,只要你把路线分配好、不撞车、不重复就行。核心其实就三样东西:一个“待爬队列”、一个“已访问集合”、再加一池子“干活的线程”。这个模型跟我之前写数据库那篇里说的高并发访问是一个思路
我当时在工位上画了个小草图:中间一个任务桶,左边丢进去一个种子 URL,右边围了一圈工人,每人拿一个小桶,捞到 URL 就去干活。干啥?三步:下载网页、解析新的链接、把没爬过的链接再扔回大桶。所以算法的主流程可以口水话说完:不停从队列里拿 URL → 看看以前爬没爬过 → 没爬过就标记一下 → 抓页面、解析链接 → 新链接丢回队列,直到队列空了或者达到你设的上限。
说人话还不够,得给你看点真家伙代码,不然面试官一问就露馅了。我那天就在项目里写了这么一个简化版,用 Java 写下来的,大概长这个样子(伪业务,但套路是真的):
import java.util.Set;import java.util.concurrent.*;import java.util.concurrent.atomic.AtomicInteger;publicclassMultiThreadCrawler{// 待爬 URL 队列,多线程安全privatefinal BlockingQueue<String> urlQueue = new LinkedBlockingQueue<>();// 已访问 URL 集合,防止重复爬privatefinal Set<String> visited = ConcurrentHashMap.newKeySet();// 线程池privatefinal ExecutorService executor;privatefinal AtomicInteger pageCount = new AtomicInteger(0);privatefinalint maxPages;publicMultiThreadCrawler(int threadNum, int maxPages){this.executor = Executors.newFixedThreadPool(threadNum);this.maxPages = maxPages; }publicvoidstart(String seedUrl)throws InterruptedException { urlQueue.offer(seedUrl);// 开一批 workerfor (int i = 0; i < ((ThreadPoolExecutor) executor).getCorePoolSize(); i++) { executor.submit(new Worker()); }// 等一会儿,实际项目里可以用更优雅的退出条件 executor.shutdown(); executor.awaitTermination(30, TimeUnit.MINUTES); }privateclassWorkerimplementsRunnable{@Overridepublicvoidrun(){try {while (!Thread.currentThread().isInterrupted()) {// 1 秒拿不到任务就认为没活了 String url = urlQueue.poll(1, TimeUnit.SECONDS);if (url == null) {break; }// 去重if (!visited.add(url)) {continue; }// 控制最大页数int current = pageCount.incrementAndGet();if (current > maxPages) {break; }try { crawlPage(url); } catch (Exception e) {// 线上最好打日志,这里简单打印 System.err.println("crawl error: " + url + " " + e.getMessage()); } } } catch (InterruptedException e) {// 收尾退出 Thread.currentThread().interrupt(); } } }// 真正的“爬一页”的逻辑privatevoidcrawlPage(String url)throws Exception {// 这里你可以换成 HttpClient + Jsoup,下面只是个示意 System.out.println("[" + Thread.currentThread().getName() + "] crawling: " + url); String html = download(url); // 下载页面for (String link : extractLinks(html)) { // 解析出新的链接if (!visited.contains(link)) { urlQueue.offer(link); // 丢回任务队列 } } }// 模拟下载private String download(String url)throws Exception {// 真实环境就是发 HTTP 请求了 Thread.sleep(100); // 假装网络延时return"<a href=\"http://example.com/a\">a</a>"; }// 模拟解析链接private Iterable<String> extractLinks(String html){// 真实环境里用 Jsoup.parse(html)... 之类的return java.util.List.of("http://example.com/a"); }publicstaticvoidmain(String[] args)throws InterruptedException { MultiThreadCrawler crawler = new MultiThreadCrawler(8, 100); crawler.start("http://example.com"); }}你看,这段里有几个点是面试官爱抠细节的,我顺嘴帮你捋一下:
一个是 BlockingQueue。为啥不用普通的 List?因为多线程环境下 List 要自己加锁,很容易整成死锁或者性能拉胯;用阻塞队列,线程没任务的时候会老老实实等在那儿,不会 while(true) 疯狂空转把 CPU 烧了。
另一个是 ConcurrentHashMap.newKeySet() 当去重集合。这里千万别写成 new HashSet<>() 然后 synchronized (set) 一把大锁,线程一多直接退化成单线程。并发 set 底层帮你把锁拆好了,你只管 visited.add(url) 就行。
再一个是 AtomicInteger pageCount。你会发现我不是等队列空了再退出,而是全局数了一下“我爬了多少页”,超过某个阈值就不干了。这个在面试官问“怎么控制规模、防止把别人网站扒秃噜皮”的时候很好用,顺便还能说两句礼貌爬虫:限速、加 User-Agent、尊重 robots 协议之类的,显得你不是野蛮人。
真实项目里,你还会加几个约束:比如域名白名单(只爬某个站)、深度控制(不能从首页一路点到用户个人隐私页)、简单的限流(每个域名之间 sleep 一下,或者用 Semaphore 控制同时访问的线程数)。这些都不难,基本都是在 crawlPage 里往里塞逻辑而已,整体算法骨架不用动。
哦还有一个特别容易踩坑的点,我得提醒一下:不要在线程里随便 System.exit(0) 或者捕获 Exception 什么都不做,线程静悄悄死了,爬虫卡在半路你都不知道。起码要打个日志,把 URL 打出来,后面你才能复盘是哪一页老出问题,这一点跟排查数据库主从、MQ 丢消息那种事故是一个思路,痕迹要留够。
行,我嘴有点干了,先写到这儿,你要真打算把这个多线程爬虫丢到生产环境里用,记得先跟运维打个招呼,不然半夜网管看到你机器对外疯狂发请求,还以为哪台中毒了…我去冲杯咖啡先。
点击关注公众号,阅读更多精彩内容