【Python时序预测系列】建立DT-LSTM融合模型实现多变量时序预测(案例+源码)
- 2026-10-13 21:33:02
【Python时序预测系列】建立DT-LSTM融合模型实现多变量时序预测(案例+源码)写在前面 

热门原创文章推荐阅读点击标题可跳转 写在后面 
免费电子书籍,带你入门人工智能:
这是我的第450篇原创文章。
『数据杂坛』以Python语言为核心,垂直于数据科学领域,专注于(可戳👉)Python程序设计|数据分析|特征工程|机器学习分类|机器学习回归|深度学习分类|深度学习回归|单变量时序预测|多变量时序预测|语音识别|图像识别|自然语音处理|大语言模型|软件设计开发等技术栈交流学习,涵盖数据挖掘、计算机视觉、自然语言处理等应用领域。(文末有惊喜福利)
一、引言
下面通过一个具体的案例,融合DT + LSTM进行多变量输入单变量输出单步时间序列预测,包括模型构建、训练、预测等等。
二、实现过程
2.1 原始数据集加载
核心代码:
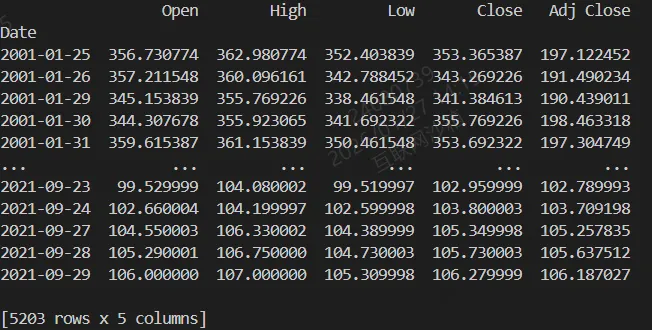
df = pd.read_csv('/workspaces/Data-Miscellany-Forum/src/多变量时序预测系列-股票预测/多输入+单输出+单步/data.csv', parse_dates=["Date"], index_col=[0])df = pd.DataFrame(df)var_num = len(df.columns)print(df)
结果:
2.2 数据集划分
核心代码:
test_split=round(len(df)*0.20)df_for_training=df[:-test_split]df_for_testing=df[-test_split:]
2.3 数据归一化
核心代码:
scaler = MinMaxScaler(feature_range=(0, 1))df_for_training_scaled = scaler.fit_transform(df_for_training)df_for_testing_scaled=scaler.transform(df_for_testing)
2.4 构造时序数据集
核心代码:
train_dataset = TimeSeriesDataset(df_for_training_scaled, seq_len=seq_len, pred_len=pred_len)test_dataset = TimeSeriesDataset(df_for_testing_scaled, seq_len=seq_len, pred_len=pred_len)train_loader = DataLoader(train_dataset, batch_size=batch_size, shuffle=True)test_loader = DataLoader(test_dataset, batch_size=batch_size, shuffle=False)
2.5 LSTM模型
核心代码:
class LSTMRegressor(nn.Module):def __init__(self, input_size=5, hidden_size=50, num_layers=1, output_size=1, dropout=0.2):"""input_size: 输入特征维度(多变量个数)hidden_size: LSTM隐藏层维度num_layers: LSTM层数"""super(LSTMRegressor, self).__init__()self.hidden_size = hidden_size# LSTM层self.lstm = nn.LSTM(input_size,hidden_size,num_layers,batch_first=True)# 全连接层self.fc = nn.Sequential(nn.Linear(hidden_size, hidden_size // 2),nn.ReLU(),nn.Dropout(dropout),nn.Linear(hidden_size // 2, output_size))def forward(self, x):"""x: (batch_size, seq_length, input_dim)return: (batch_size, output_dim)"""lstm_out, (hidden, cell) = self.lstm(x) # lstm_out: (batch, seq, hidden)last_hidden = lstm_out[:, -1, :] # (batch, hidden)取最后一个时间步的隐藏状态(或可用 hidden[-1])out = self.fc(last_hidden) # (batch, output_dim)return out
2.6 模型训练与融合增强
核心代码:
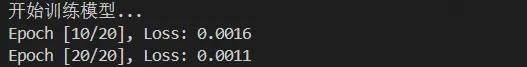
model = LSTMRegressor(input_size=var_num, hidden_size=hidden_size, num_layers=num_layers, output_size=pred_len, dropout=dropout).to(device)print("开始训练模型...")loss_history, train_preds, train_trues = train_model(model, train_loader, num_epochs=num_epochs, learning_rate=learning_rate, device=device)# 决策树基于LSTM残差训练residuals = np.array(train_trues).reshape(-1, 1)- np.array(train_preds).reshape(-1, 1)X_tree_train = train_preds.reshape(-1, 1)model_tree = DecisionTreeRegressor(max_depth=3)model_tree.fit(X_tree_train, residuals)
结果:
2.7 模型评估
核心代码:
preds, trues = evaluate_model(model, test_loader, device=device)X_tree_test = preds.reshape(-1, 1)residual_preds = model_tree.predict(X_tree_test)final_preds = preds + residual_preds
2.8 结果可视化
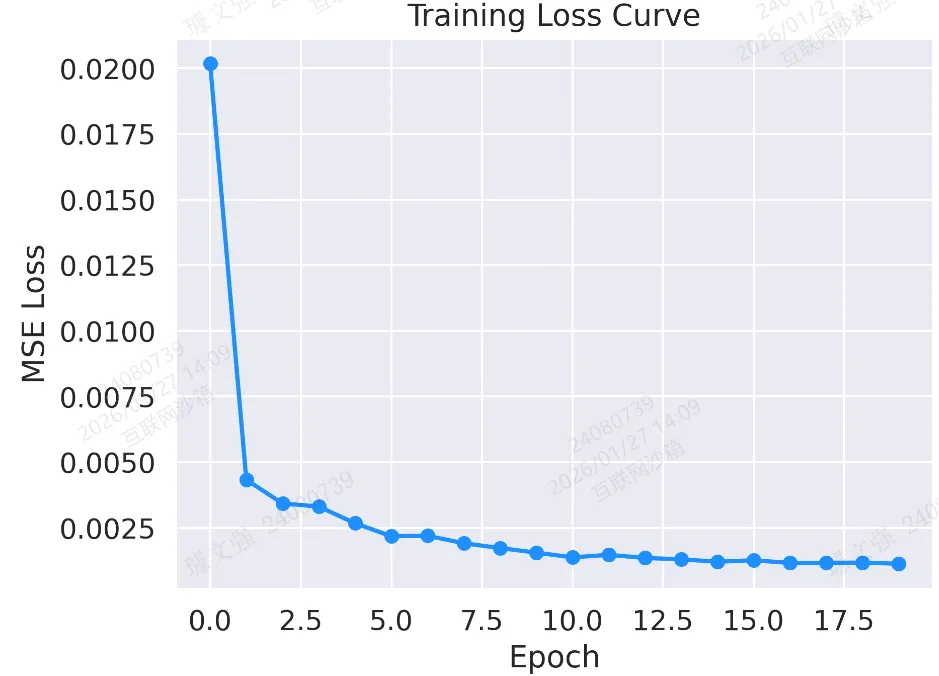
图 1:训练损失曲线
plt.plot(loss_history, marker='o', color='dodgerblue', linestyle='-', linewidth=2)plt.title("Training Loss Curve")plt.xlabel("Epoch")plt.ylabel("MSE Loss")plt.tight_layout()plt.savefig('output_image1.png', dpi=300, format='png')plt.show()
结果:
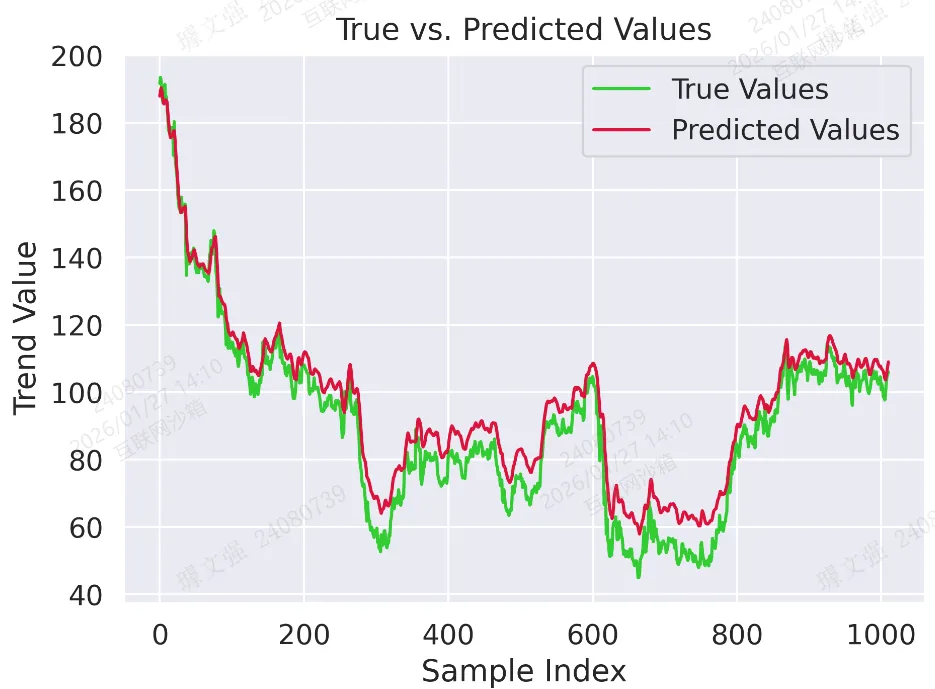
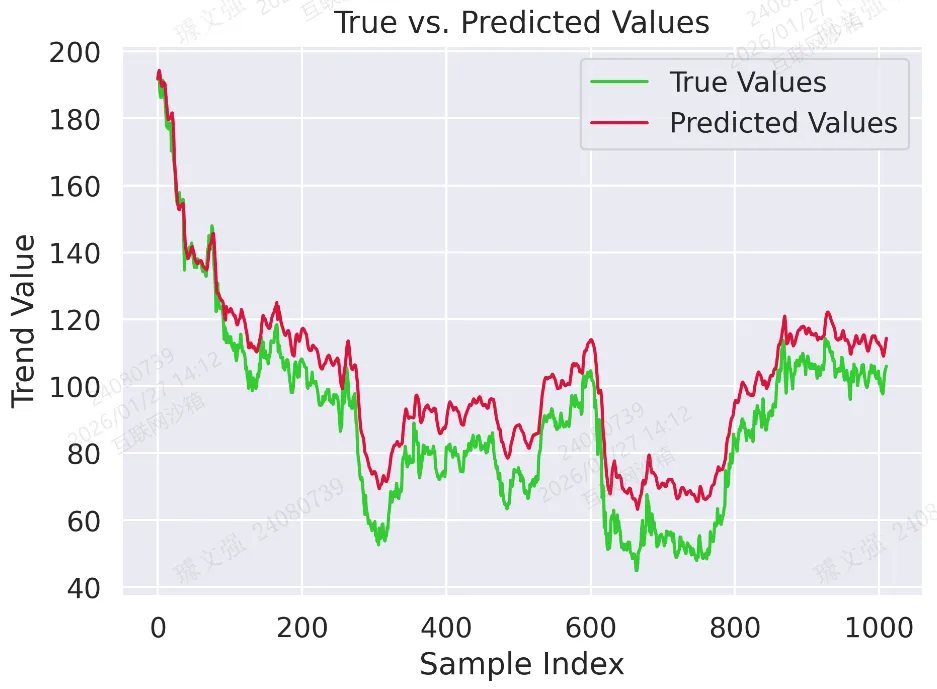
图 2:真实值与预测值对比曲线(LSTM)
plt.plot(trues, label="True Values", color='limegreen')plt.plot(preds, label="Predicted Values", color='crimson')plt.title("True vs. Predicted Values")plt.xlabel("Sample Index")plt.ylabel("Trend Value")plt.legend()plt.tight_layout()plt.savefig('output_image2.png', dpi=300, format='png')plt.show()
结果:
图 3:真实值与预测值对比曲线(融合模型)
plt.plot(trues, label="True Values", color='limegreen')plt.plot(final_preds, label="Predicted Values", color='crimson')plt.title("True vs. Predicted Values")plt.xlabel("Sample Index")plt.ylabel("Trend Value")plt.legend()plt.tight_layout()plt.savefig('output_image3.png', dpi=300, format='png')plt.show()
结果:
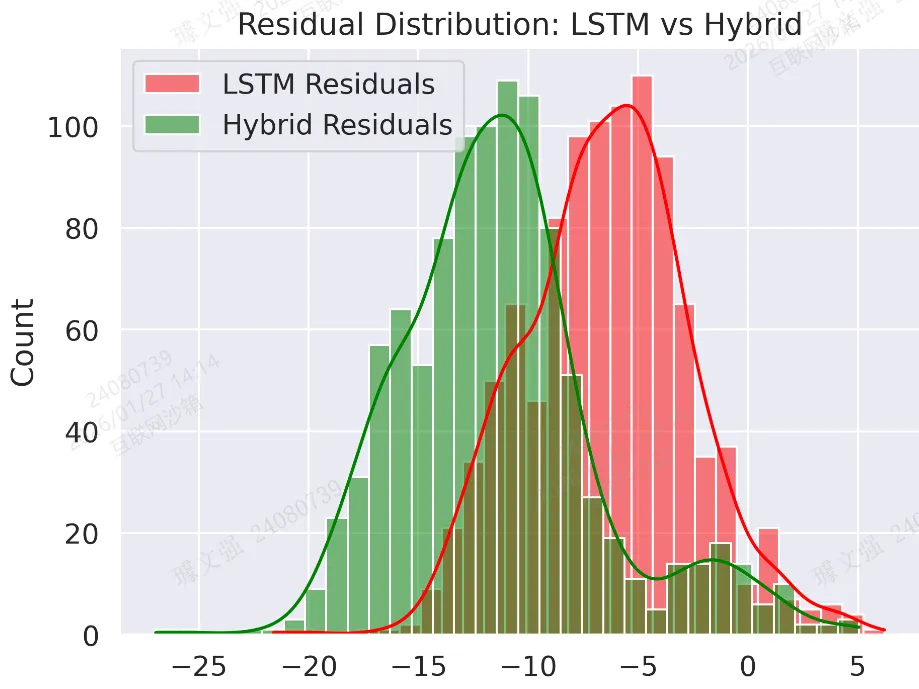
图 4:残差分布图(增强前后)
sns.histplot(trues - preds, color='red', label='LSTM Residuals', kde=True)sns.histplot(trues - final_preds, color='green', label='Hybrid Residuals', kde=True)plt.title("Residual Distribution: LSTM vs Hybrid")plt.legend()plt.tight_layout()plt.savefig('output_image4.png', dpi=300, format='png')plt.show()
结果:
2.9 指标计算
核心代码:
def evaluate_metrics(y_true, y_pred):y_true = y_true.reshape(-1)y_pred = y_pred.reshape(-1)eps = 1e-8mse = np.mean((y_true - y_pred)**2)rmse = np.sqrt(mse + eps)mae = np.mean(np.abs(y_true - y_pred))mape = np.mean(np.abs((y_true - y_pred)/(np.abs(y_true)+eps)))smape = np.mean(2*np.abs(y_true - y_pred)/(np.abs(y_true)+np.abs(y_pred)+eps))# R2ss_res = np.sum((y_true - y_pred)**2)ss_tot = np.sum((y_true - np.mean(y_true))**2) + epsr2 = 1 - ss_res/ss_tot# Pearsoncorr = np.corrcoef(y_true, y_pred)[0,1]return dict(MSE=mse, RMSE=rmse, MAE=mae, MAPE=mape, sMAPE=smape, R2=r2, Corr=corr)
结果:
建立CNN与Transformer融合模型实现单变量时序预测(案例+源码)
建立Transformer-LSTM-TCN-XGBoost融合模型多变量时序预测(源码)
利用SHAP进行特征重要性分析-决策树模型为例(案例+源码)
梯度提升集成:LightGBM与XGBoost组合预测油耗(案例+源码)
一文教你建立随机森林-贝叶斯优化模型预测房价(案例+源码)
建立随机森林模型预测心脏疾病(完整实现过程)
建立CNN模型实现猫狗图像分类(案例+源码)
使用LSTM模型进行文本情感分析(案例+源码)
基于Flask将深度学习模型部署到web应用上(完整案例)
新版Dify 开发自定义工具插件在工作流中直接调用(完整步骤)
作者简介:
读研期间发表6篇SCI数据算法相关论文,目前在某研究院从事数据算法相关研究工作,结合自身科研实践经历不定期持续分享关于Python、数据分析、特征工程、机器学习、深度学习、人工智能系列基础知识与案例。
致力于只做原创,以最简单的方式理解和学习,关注我一起交流成长。
1、关注下方公众号,点击“领资料”即可免费领取电子资料书籍。
2、文章底部点击喜欢作者即可联系作者获取相关数据集和源码。
3、数据算法方向论文指导或就业指导,点击“联系我”添加作者微信直接交流。
4、有商务合作相关意向,点击“联系我”添加作者微信直接交流。
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:596563534@qq.com 。
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- 专业理论 | 多智能体在面向对象编程课程设计中的应用
- 第132期 Oracle Linux 10.1操作系统Oracle 26ai 2节点RAC搭建步骤(保姆级)
- MATLAB代码:图形的二维几何变换(平移、旋转和缩放)基础篇
- 大模型微调评测入门指南:指标解读、代码实操与避坑要点
- AI编程段位表,你在哪一级?
- 高碑店机械厂招聘【文员、加工中心编程、铣工、钳工、数控车、加工中心操作工】
- 3-1:X线的产生(代码104、206、376,初中级通用)
- 代码之外周刊(第165期):泛泛之交,才是你最该经营的关系
- 谈C编程---宁愿编译和连接时出错,也不要执行时才错
- 告别选择困难:Linux 主流文件系统特性与适用场景全梳理