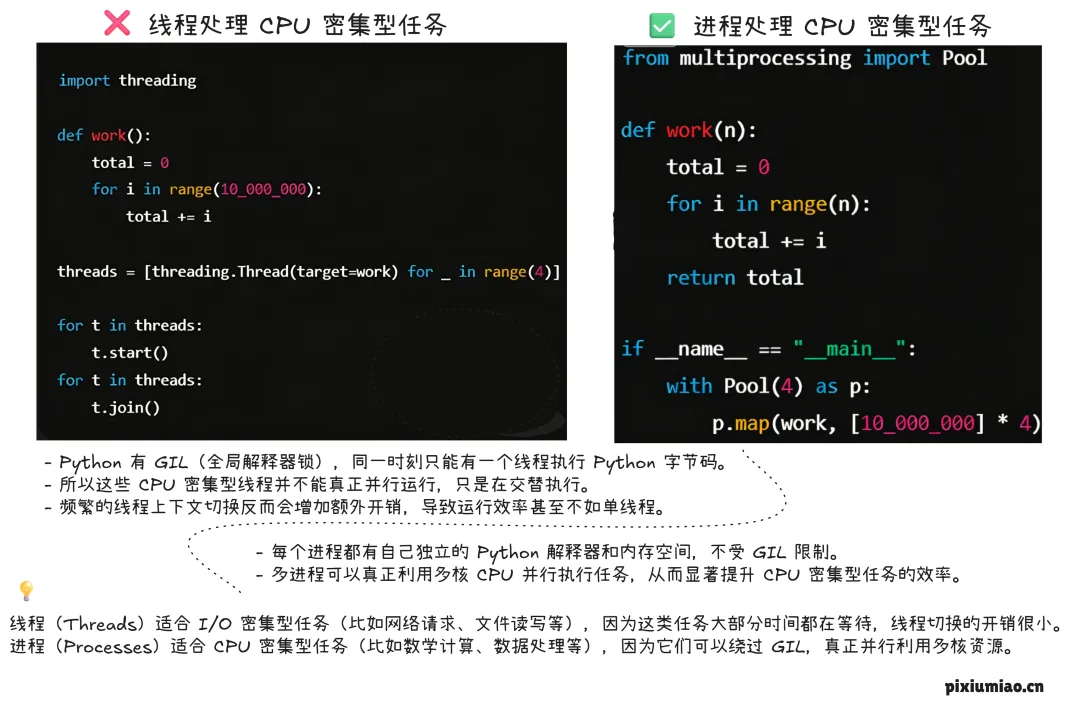
在Python并发编程中,有一个非常常见的误区——很多新手会习惯性用线程(threading)处理CPU密集型任务,以为这样能提升效率,殊不知反而会适得其反。今天就带大家清晰拆解这个误区,同时给出对应的正确解决方案,记住核心原则,再也不踩坑!
1. ❌ 错误做法
左边的代码使用了threading模块创建多个线程,用来执行一个累加计算的CPU密集型任务(循环累加1000万次)。
import threading

def work():
    total = 0
    for i in range(10_000_000):
        total += i

threads = [threading.Thread(target=work) for _ in range(4)]
for t in threads:
    t.start()
for t in threads:
    t.join()
看似用了4个线程并行处理,但实际运行起来会发现,效率并没有提升,甚至比单线程更慢。问题的核心在于Python的GIL(全局解释器锁):
GIL限制了同一时刻,只能有一个线程执行Python字节码;
这些CPU密集型线程并不能真正并行运行,只是在交替执行(伪并行);
频繁的线程上下文切换,反而会增加额外的系统开销,拖慢整体运行速度。
2. ✅ 正确做法
针对CPU密集型任务,正确的做法是改用多进程(multiprocessing)。右边的代码使用multiprocessing.Pool,通过多进程来处理同一个累加任务。
from multiprocessing import Pool

def work(n):
    total = 0
    for i in range(n):
        total += i
    return total

if __name__ == "__main__":
    with Pool(4) as p:
        p.map(work, [10_000_000] * 4)
多进程能解决问题,关键原因有2点:
3. 💡 核心原则
记住这一句话,再也不搞混线程和进程的使用场景:
总结一下:Python并发编程,先判断任务类型——I/O密集用线程,CPU密集用进程,避开GIL的坑,才能真正提升程序效率~