Python从入门到精通day30
- 2026-09-06 03:09:32
正则表达式的应用
正则表达式相关知识
简洁高效:一行正则规则,替代多行条件判断代码;
功能强大:支持复杂的匹配逻辑(如 “手机号前不能有数字”“邮箱必须是 xxx@xxx.xxx 格式”);
跨语言通用:几乎所有编程语言(Python/Java/JavaScrip/Go)都支持正则表达式,语法基本一致,学会一通百通。
通配符:仅支持简单的模糊匹配,适合文件查找;
正则表达式:支持精准的规则匹配(如 “匹配 11 位手机号,首位必须是 1,第二位是 3-9”),适合字符串精细化处理。
格式验证:手机号、邮箱、身份证号、用户名、密码的有效性验证;
内容提取:从文本 / 网页中提取电话号码、邮箱、URL、身份证号等指定信息;
字符替换:屏蔽不良词汇、批量替换指定格式的字符、清洗文本数据;
文本拆分:按非固定的分隔符拆分字符串(如按 “逗号、句号、感叹号” 拆分句子)。
关于正则表达式的相关知识,大家可以阅读一篇非常有名的博文叫《正则表达式30分钟入门教程》,读完这篇文章后你就可以看懂下面的表格,这是我们对正则表达式中的一些基本符号进行的扼要总结。
. | b.t | ||
\w | b\wt | ||
\s | love\syou | ||
\d | \d\d | ||
\b | \bThe\b | ||
^ | ^The | ||
$ | .exe$ | ||
\W | b\Wt | ||
\S | love\Syou | ||
\D | \d\D | ||
\B | \Bio\B | ||
[] | [aeiou] | ||
[^] | [^aeiou] | ||
* | \w* | ||
+ | \w+ | ||
? | \w? | ||
{N} | \w{3} | ||
{M,} | \w{3,} | ||
{M,N} | \w{3,6} | ||
| | foo|bar | ||
(?#) | |||
(exp) | |||
(?<name>exp) | |||
(?:exp) | |||
(?=exp) | \b\w+(?=ing) | ||
(?<=exp) | (?<=\bdanc)\w+\b | ||
(?!exp) | |||
(?<!exp) | |||
*? | a.*ba.*?b | ||
+? | |||
?? | |||
{M,N}? | |||
{M,}? |
说明: 如果需要匹配的字符是正则表达式中的特殊字符,那么可以使用
\进行转义处理,例如想匹配小数点可以写成\.就可以了,因为直接写.会匹配任意字符;同理,想匹配圆括号必须写成\(和\),否则圆括号被视为正则表达式中的分组。
Python对正则表达式的支持
Python 提供了re模块来支持正则表达式相关操作,下面是re模块中的核心函数。
compile(pattern, flags=0) | |
match(pattern, string, flags=0) | None |
search(pattern, string, flags=0) | None |
split(pattern, string, maxsplit=0, flags=0) | |
sub(pattern, repl, string, count=0, flags=0) | count指定替换的次数 |
fullmatch(pattern, string, flags=0) | match |
findall(pattern, string, flags=0) | |
finditer(pattern, string, flags=0) | |
purge() | |
re.I/ | |
re.M/ |
说明: 上面提到的
re模块中的这些函数,实际开发中也可以用正则表达式对象(Pattern对象)的方法替代对这些函数的使用,如果一个正则表达式需要重复的使用,那么先通过compile函数编译正则表达式并创建出正则表达式对象无疑是更为明智的选择。
理论结合实践是掌握正则表达式的最佳方式,以下是 4 个实际开发中高频出现的案例,包含完整代码、详细注解和易错点提示,所有代码均可直接运行,建议亲手敲一遍。
案例1:验证输入用户名和QQ号是否有效并给出对应的提示信息。
"""要求:用户名必须由字母、数字或下划线构成且长度在6~20个字符之间,QQ号是5~12的数字且首位不能为0"""import reusername = input('请输入用户名: ')qq = input('请输入QQ号: ')# match函数的第一个参数是正则表达式字符串或正则表达式对象# match函数的第二个参数是要跟正则表达式做匹配的字符串对象m1 = re.match(r'^[0-9a-zA-Z_]{6,20}$', username)ifnot m1:print('请输入有效的用户名.')# fullmatch函数要求字符串和正则表达式完全匹配# 所以正则表达式没有写起始符和结束符m2 = re.fullmatch(r'[1-9]\d{4,11}', qq)ifnot m2:print('请输入有效的QQ号.')if m1 and m2:print('你输入的信息是有效的!')提示: 上面在书写正则表达式时使用了“原始字符串”的写法(在字符串前面加上了
r),所谓“原始字符串”就是字符串中的每个字符都是它原始的意义,说得更直接一点就是字符串中没有所谓的转义字符啦。因为正则表达式中有很多元字符和需要进行转义的地方,如果不使用原始字符串就需要将反斜杠写作\\,例如表示数字的\d得书写成\\d,这样不仅写起来不方便,阅读的时候也会很吃力。
案例2:从一段文字中提取出国内手机号码。
下面这张图是截止到 2017 年底,国内三家运营商推出的手机号段。
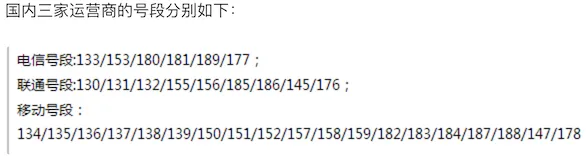
import re# 创建正则表达式对象,使用了前瞻和回顾来保证手机号前后不应该再出现数字pattern = re.compile(r'(?<=\D)1[34578]\d{9}(?=\D)')sentence = '''重要的事情说8130123456789遍,我的手机号是13512346789这个靓号,不是15600998765,也不是110或119,王大锤的手机号才是15600998765。'''# 方法一:查找所有匹配并保存到一个列表中tels_list = re.findall(pattern, sentence)for tel in tels_list:print(tel)print('--------华丽的分隔线--------')# 方法二:通过迭代器取出匹配对象并获得匹配的内容for temp in pattern.finditer(sentence):print(temp.group())print('--------华丽的分隔线--------')# 方法三:通过search函数指定搜索位置找出所有匹配m = pattern.search(sentence)while m:print(m.group()) m = pattern.search(sentence, m.end())说明: 上面匹配国内手机号的正则表达式并不够好,因为像 14 开头的号码只有 145 或 147,而上面的正则表达式并没有考虑这种情况,要匹配国内手机号,更好的正则表达式的写法是:
(?<=\D)(1[38]\d{9}|14[57]\d{8}|15[0-35-9]\d{8}|17[678]\d{8})(?=\D),国内好像已经有 19 和 16 开头的手机号了,但是这个暂时不在我们考虑之列。
案例3:替换字符串中的不良内容
import resentence = 'Oh, shit! 你是傻逼吗? Fuck you.'purified = re.sub('fuck|shit|[傻煞沙][比笔逼叉缺吊碉雕]','*', sentence, flags=re.IGNORECASE)print(purified) # Oh, *! 你是*吗? * you.说明:
re模块的正则表达式相关函数中都有一个flags参数,它代表了正则表达式的匹配标记,可以通过该标记来指定匹配时是否忽略大小写、是否进行多行匹配、是否显示调试信息等。如果需要为flags参数指定多个值,可以使用按位或运算符进行叠加,如flags=re.I | re.M。
案例4:拆分长字符串
import repoem = '窗前明月光,疑是地上霜。举头望明月,低头思故乡。'sentences_list = re.split(r'[,。]', poem)sentences_list = [sentence for sentence in sentences_list if sentence]for sentence in sentences_list:print(sentence)新手避坑指南与实用技巧
1. 新手常见坑
- 忘记使用原始字符串
r导致正则中的 \d/\w失效,报转义错误; - 混淆
match和searchmatch仅匹配开头,若需全局查找,用search/findall; - 格式验证未用完全匹配
忘记加 ^/$,或未用fullmatch,导致部分匹配也判定为有效; - 贪婪匹配与非贪婪匹配混淆
默认贪婪匹配,若需匹配最短子串,在重复符号后加 ?; - 转义符使用错误
匹配 ./(/[等特殊字符时,未用\转义,导致规则失效。
2. 实用技巧
- 正则规则复用必编译
若一个正则规则需要多次使用,用 re.compile编译为正则对象,提升代码执行效率; - 复杂规则分步写
对于复杂的正则规则(如匹配邮箱、身份证号),可拆分为多个简单规则,分步验证,提升代码可读性; - 利用在线工具调试
新手写正则规则时,可使用在线正则表达式测试工具(如 Regex101、菜鸟工具正则测试),实时查看匹配结果,快速调试; - 优先使用
findall提取内容
findall直接返回匹配结果列表,无需处理匹配对象,是提取内容的最优选择;- 分组提取指定内容
若需从匹配结果中提取子串(如从邮箱中提取用户名和域名),用 ()分组,通过groups()获取分组结果。
3. 推荐在线工具
- Regex101
https://regex101.com/(支持 Python 语法,实时调试,标注匹配规则); - 菜鸟工具正则测试
https://c.runoob.com/front-end/854/(中文界面,适合新手); - 正则表达式 30 分钟入门教程
经典博文,快速掌握正则核心语法,建议新手阅读。
总结
正则表达式是 Python 字符串处理的核心工具,其本质是用符号定义匹配规则,实现对字符串的验证、提取、替换、拆分。对于新手来说,无需死记硬背所有语法,只需掌握常用符号和re 模块核心函数,结合实际案例练习,就能快速上手。
本文的核心重点可总结为 3 句话:
书写规则用原始字符串r,避免转义冲突;
格式验证用完全匹配(fullmatch或match+^$),提取内容用findall;
复杂匹配用分组 / 前瞻 / 后顾,文本清洗用re.sub,规则拆分用re.split。
正则表达式的熟练度,取决于实际练习的次数。在实际开发中,遇到字符串处理问题时,先思考是否能用正则解决,再结合在线工具调试规则,久而久之,就能做到 “随手写正则,高效处理字符串”。
国内直接使用顶级AI工具
谷歌浏览器访问:https://www.nezhasoft.cloud/r/vMPJZr
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- 解决Linux内核内存问题:MMU机制实操解析
- Linux 文件系统(一) --- ext4文件系统简介
- 2026年2月TIOBE编程语言排行:Python下滑2.08%但仍领先10点,R强势回归Top10
- Python 永久激活安装教程和中文安装包下载(附全部版本安装包)
- Python编程实战100例-7
- Python全面速查表!3.8万Star的Cheatsheet,一页搞定Python语法
- 【时间序列机器学习】Python06时间序列XGBoost(eXtreme Gradient Boosting)模型拟合及可视化
- 【教程】AI-Python多技术融合下双碳与生态水文关键技术(蒸散发组分解析/GPP估算)实践应用
- Mac版Python编辑开发PyCharm Pro 2025 for mac v2025.2.2中文激活版 附安装包【网盘下载】
- 你的 Python 代码,正在裸奔?