Python+LangChain/LangGraph框架开发Ai智能体系列(七) | 为 Agent 添加短期记忆策略
- 2026-09-10 19:32:50
Python+LangChain/LangGraph框架开发Ai智能体系列(七) | 为 Agent 添加短期记忆策略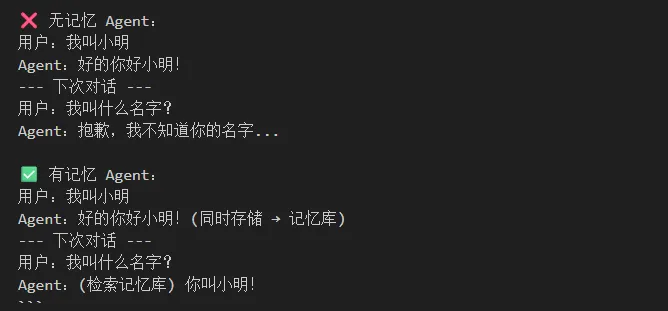
环境:win11+python3.11+vscode编辑器 3.代码运行:
热点文章推荐: 小白10分钟搭建腾讯版龙虾WorkBuddy环境并绑定微信控制电脑干活生成一个agent应用
1. 学习目标
- 为 Agent 智能体添加短期记忆,掌握agent短期记忆三种策略。
2.核心概念速览
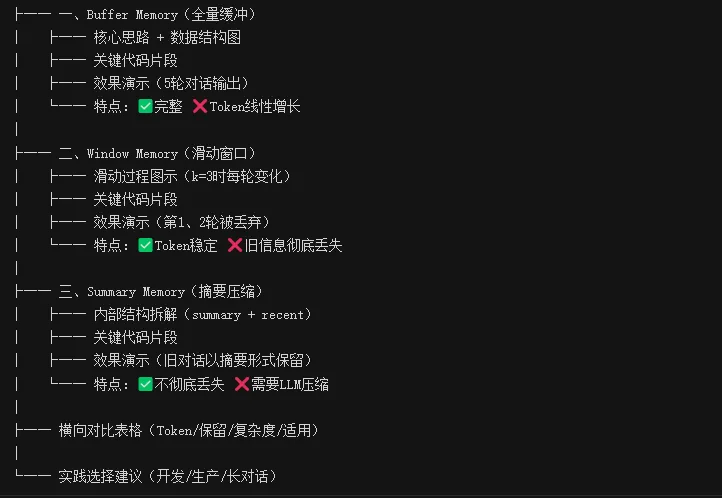
-策略1:BufferMemory(全量缓冲)
-策略2:WindowMemory(滑动窗口,k=3)
-策略3:SummaryMemory(摘要压缩)
为什么 Agent 需要记忆?
默认的 LLM (大语言模型)是无状态的:每次调用都是全新的对话,不记得之前说了什么。
### 核心特点
-短期记忆三种策略:
3.代码实现
3.1 ConversationBufferMemory(短期)
from langchain.memory import ConversationBufferMemorymemory = ConversationBufferMemory(return_messages=True, # 返回 Message 对象列表(不是字符串)memory_key="chat_history" # 注入 prompt 的 key)# 存入记忆memory.save_context({"input": "我叫小明"},{"output": "你好小明!"})# 读取记忆history = memory.load_memory_variables({})# {'chat_history': [HumanMessage('我叫小明'), AIMessage('你好小明!')]}
3.2 ConversationBufferWindowMemory(滑动窗口)
from langchain.memory import ConversationBufferWindowMemorymemory = ConversationBufferWindowMemory(k=5, # 只保留最近 5 轮return_messages=True)
"""短期记忆类型对比演示演示三种短期记忆策略:Buffer / Window / Summary无需 LLM,直接运行即可看到效果"""# ============================================================# 方式一:手动实现,理解底层原理(推荐先看这个)# ============================================================class BufferMemory:"""全量缓冲记忆:保留所有历史对话"""def __init__(self):self.history = [] # 存储 (human, ai) 元组列表def save(self, human_msg: str, ai_msg: str):self.history.append({"role": "human", "content": human_msg})self.history.append({"role": "ai", "content": ai_msg})def load(self) -> list:return self.history.copy()def format_for_prompt(self) -> str:"""格式化为 prompt 字符串"""lines = []for msg in self.history:prefix = "用户" if msg["role"] == "human" else "助手"lines.append(f"{prefix}: {msg['content']}")return "\n".join(lines)def token_count(self) -> int:"""粗略估算 Token 数(实际用 tiktoken)"""total = sum(len(m["content"]) for m in self.history)return total // 2 # 中文约 2 字符/tokendef clear(self):self.history = []class WindowMemory:"""滑动窗口记忆:只保留最近 k 轮"""def __init__(self, k: int = 3):self.k = k # 保留最近 k 轮self.rounds = [] # 每个元素是一轮 (human, ai)def save(self, human_msg: str, ai_msg: str):self.rounds.append((human_msg, ai_msg))# 超出窗口就丢掉最早的if len(self.rounds) > self.k:self.rounds = self.rounds[-self.k:]def load(self) -> list:messages = []for human, ai in self.rounds:messages.append({"role": "human", "content": human})messages.append({"role": "ai", "content": ai})return messagesdef format_for_prompt(self) -> str:lines = []for human, ai in self.rounds:lines.append(f"用户: {human}")lines.append(f"助手: {ai}")return "\n".join(lines)class SummaryMemory:"""摘要压缩记忆:将历史对话压缩为摘要"""def __init__(self):self.summary = "" # 当前摘要self.recent = [] # 最近几轮完整保留self.max_recent = 2 # 最近 2 轮不压缩def save(self, human_msg: str, ai_msg: str):self.recent.append((human_msg, ai_msg))# 超出 max_recent 就压缩旧的(这里 mock 压缩,真实要用 LLM)if len(self.recent) > self.max_recent:oldest = self.recent.pop(0)self._compress_to_summary(oldest[0], oldest[1])def _compress_to_summary(self, human: str, ai: str):"""Mock 压缩:真实场景用 LLM 生成摘要"""new_info = f"之前对话中:用户说'{human[:20]}...',助手回复'{ai[:20]}...'"if self.summary:self.summary += f"\n{new_info}"else:self.summary = new_infodef format_for_prompt(self) -> str:parts = []if self.summary:parts.append(f"[历史摘要]\n{self.summary}")if self.recent:parts.append("[最近对话]")for human, ai in self.recent:parts.append(f"用户: {human}")parts.append(f"助手: {ai}")return "\n".join(parts)# ============================================================# 演示主函数# ============================================================def demo_buffer_memory():print("=" * 60)print("📦 演示一:BufferMemory(全量缓冲)")print("=" * 60)mem = BufferMemory()conversations = [("我叫小明,今年25岁", "你好小明!很高兴认识你。"),("我喜欢喝咖啡", "了解,你喜欢咖啡!"),("我在西安工作", "西安是个不错的城市。"),("我的爱好是编程", "编程真是个好爱好!"),("我最喜欢 Python", "Python 确实很强大!"),]for human, ai in conversations:mem.save(human, ai)print(f"存储了 {len(conversations)} 轮对话")print(f"Token 估算:约 {mem.token_count()} tokens")print("\n--- 格式化为 Prompt ---")print(mem.format_for_prompt())print()def demo_window_memory():print("=" * 60)print("🪟 演示二:WindowMemory(滑动窗口,k=3)")print("=" * 60)mem = WindowMemory(k=3)conversations = [("我叫小明,今年25岁", "你好小明!"),("我喜欢喝咖啡", "了解,你喜欢咖啡!"),("我在西安工作", "西安是个不错的城市。"),("我的爱好是编程", "编程真是个好爱好!"),("我最喜欢 Python", "Python 确实很强大!"),]for i, (human, ai) in enumerate(conversations, 1):mem.save(human, ai)print(f"[第{i}轮后] 保留 {len(mem.rounds)} 轮 | "f"{'(已丢弃旧对话)'if i > 3else''}")print("\n--- 最终保留的对话(仅最近3轮)---")print(mem.format_for_prompt())print("\n⚠️ 注意:第1、2轮已被丢弃!'我叫小明'的信息丢失了")print()def demo_summary_memory():print("=" * 60)print("📝 演示三:SummaryMemory(摘要压缩,保留最近2轮)")print("=" * 60)mem = SummaryMemory()conversations = [("我叫小明,今年25岁", "你好小明!"),("我喜欢喝咖啡", "了解,你喜欢咖啡!"),("我在西安工作", "西安是个不错的城市。"),("我的爱好是编程", "编程真是个好爱好!"),("我最喜欢 Python", "Python 确实很强大!"),]for i, (human, ai) in enumerate(conversations, 1):mem.save(human, ai)print("--- 最终格式化(旧对话被压缩为摘要)---")print(mem.format_for_prompt())print("\n✅ 优点:旧信息被压缩保留,不会彻底丢失")print()def compare_strategies():print("=" * 60)print("📊 三种策略对比总结")print("=" * 60)print("""策略 优点 缺点 适用场景----------------------------------------------------------------------Buffer 完整保留所有对话 Token 随对话增长 短对话、调试Window(k=N) Token 稳定可控 旧信息直接丢失 一般聊天机器人Summary 保留摘要+最近轮次 需要 LLM 压缩 长对话、生产环境""")print("💡 实践建议:")print(" 开发阶段:Buffer(方便调试)")print(" 生产环境:Window 或 Summary + 外部长期记忆")if __name__ == "__main__":demo_buffer_memory()demo_window_memory()demo_summary_memory()compare_strategies()print("\n✅ 运行完毕!理解了短期记忆的三种策略后,")print("去看极简工具盒公众号下一篇文章学习agent长期持久化记忆。")
后续分享更系列教程关注“极简工具盒”公众号探索更多精彩内容,谢谢!
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:596563534@qq.com 。
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- 技术分享//遥感影像自适应降位拉伸(附python代码及测试数据)
- 不看后悔!19个Linux运维常用一键脚本
- Linux 运维命令系列 10 | 磁盘与存储(上)
- 一瓶毒药与几只小鼠?用Python和二进制思维破解经典测试题
- 千里传音:我在 Python 聊天室里看懂了代码的“外交”
- 武汉科技大学:基于QNX/Linux的汽车ECU安全升级模式的研究
- 嵌入式 Linux 开发必学:内核与用户空间的通信机制该如何实现?
- AI Agent 框架全景对比:Python vs TypeScript,2026 年该怎么选?
- 无痛学Python,就靠这6个网站!!!
- 从入门到进阶——Python基础知识梳理07篇