做嵌入式 Linux 项目时,串口几乎是绕不开的基础能力。最开始我只是想做一个“能从串口读数据的小程序”,但后面发现,事情并没有那么简单: 串口数据是异步到达的,解析有耗时,日志写文件又比较慢,如果全都堆在一个线程里,代码很快就会变得混乱,而且不利于扩展。
于是,我把这个小项目逐步做成了一个更完整的版本:基于 Embedded Linux 的串口数据采集与处理程序,实现了多线程采集、环形缓冲区解耦、按行拆包、协议解析、时间戳日志记录,以及条件变量同步与优雅退出。
一、项目要解决的问题
目标很明确:
为了让结构更合理,我把整个程序拆成了几个功能模块:
二、为什么这个项目不能只用一个线程?
一开始会写成这样:
这种写法看起来简单,但很快就会遇到问题。
因为串口读取是实时的,数据什么时候来并不由你控制。 如果这个时候程序正在做复杂解析,或者正在执行文件写入,就可能导致读取不及时,严重时甚至丢数据。
所以这个项目采用了多线程架构:
这样做的好处是:
一句话总结就是:
多线程不是为了“炫技”,而是为了把不同速度、不同职责的任务拆开,让系统结构更清晰。
三、项目整体架构是什么样的?
整个程序的数据流如下:
数据源 -> uart_thread -> raw ring buffer -> parse_thread -> log_write -> app.log
也就是说:
- 拼成一条完整消息后调用
parse_line() 解析
从结构上看,这其实就是一个很典型的生产者-消费者模型。
四、为什么中间要加 ring buffer?
这是整个项目里非常关键的一点。
串口收到的数据,本质上不是“一条一条消息”,而是连续字节流。 比如你希望收到的是:
TEMP:25,HUM:60
但真实情况可能是:
- 第二次
read() 又拿到 5,HUM:60\n
也可能一次读到两条甚至更多消息。
所以,线程之间不能简单地“拿字符串传来传去”,而应该先用一个更适合字节流的缓冲结构把数据存起来。
这就是 ring buffer 的意义。
环形缓冲区为什么适合这个场景?
因为它有几个天然优势:
这也是为什么很多串口、网络、驱动相关的程序,都会选择环形缓冲区来做中间层。
五、这个项目里 ring buffer 怎么设计的?
在这个项目里,环形缓冲区内部维护了几个关键字段:
not_empty / not_full:条件变量
升级后的逻辑是:
六、为什么解析线程要按字节读取?
原因很简单:串口读到的是字节流,不保证一次 read() 就刚好是一整条消息。
所以解析线程必须做两件事:
例如接收到:
TEMP:25,HUM:60\n
解析线程会:
这种方式虽然看起来“慢一点”,但更符合真实串口场景,也更稳妥。
七、协议解析是怎么做的?
当解析线程拿到一整行字符串后,就会调用 parse_line()。
当前项目中,先实现了一个简单协议格式:
TEMP:25,HUM:60
解析完成后,结构化结果大概是这样:
在代码中,parse_line() 使用 sscanf() 完成解析。 如果格式匹配成功,就返回成功;如果格式不对,就返回失败。
所以终端最终会看到类似这样的输出:
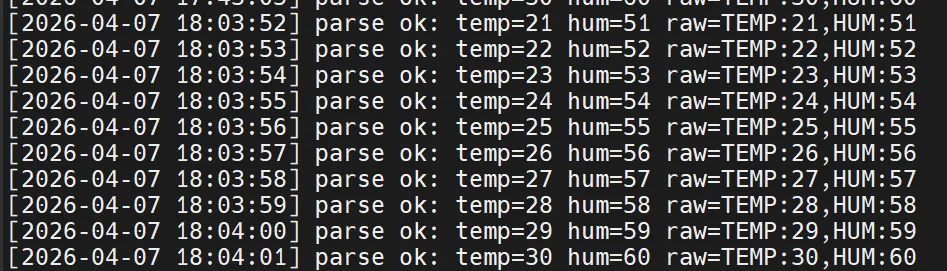
parse ok: temp=25 hum=60 raw=TEMP:25,HUM:60
如果数据格式不合法,就会输出:
parse failed: raw=......
这样做的好处是:
八、为什么还要加日志模块?
因为终端输出只是临时可见,程序一结束,很多关键信息就没了。 而日志文件可以帮助我们:
所以这个项目专门加了 log 模块,把每次解析成功或失败的结果都写入 logs/app.log。
后来又进一步加了时间戳,日志从原来的:
parse ok: temp=21 hum=51 raw=TEMP:21,HUM:51
升级成:
[2026-04-07 17:31:55] parse ok: temp=21 hum=51 raw=TEMP:21,HUM:51
九、为什么程序退出还要专门设计?
这是多线程程序中非常容易被忽视的一点。
如果线程正在等待条件变量,而主线程直接退出,子线程就可能永远卡住,导致 pthread_join() 无法返回,程序无法干净结束。
所以这个项目增加了:
pthread_cond_broadcast() 广播唤醒机制
退出流程大概是这样:
rb_stop() 内部设置 stop = true
这一步的意义在于:
避免线程永久阻塞,实现优雅退出。
十、项目目录结构长什么样?
整个项目目录结构如下:
serial_project/├── Makefile├── README.md├── include/│ ├── common.h│ ├── config.h│ ├── uart.h│ ├── ring_buffer.h│ ├── parser.h│ ├── log.h│ └── worker.h├── src/│ ├── main.c│ ├── uart.c│ ├── ring_buffer.c│ ├── parser.c│ ├── log.c│ └── worker.c├── build/└── logs/
这样的目录划分有几个好处:
十一、项目最终实现了什么?
目前这个项目已经完成了以下内容:
十二、这个项目还能怎么继续优化?
虽然现在已经能跑、能讲、能展示,但如果继续扩展,还可以做很多事情,比如:
1. 接入真实串口数据源
目前为了验证流程,有一部分测试是用假数据生成器完成的。 后续可以彻底切回真实串口输入,让项目更贴近实际设备场景。
2. 增加 CRC 或校验机制
很多实际协议不会只靠字符串格式判断,还会带校验位,防止数据出错。
3. 支持配置文件
例如把串口设备名、波特率、日志路径等放到配置文件中,而不是写死在头文件里。
4. 增加独立日志线程
当前是解析线程直接写日志,后续可以真正启用第三个线程,把日志写入进一步解耦。
5. 增加日志级别
比如支持 INFO / WARN / ERROR,让日志内容更清晰。
十三、这个项目最大的收获是什么?
如果只看功能,这个项目做的是“串口采集 + 数据解析 + 日志记录”。 但如果从工程训练角度看,它真正锻炼的是下面这些能力:
这也是很多人写项目时最容易忽略的一点:
真正有价值的,不只是“功能跑起来”,而是你有没有把结构设计清楚。
十四、写在最后
这个项目从最开始的“先把目录搭起来”,一步一步做到了:
整个过程其实很像真实开发: 不是一口气把所有代码写完,而是先搭骨架,再逐步补全功能,最后再做工程化优化。
源代码地址:https://gitee.com/GIT-Tammy/serial_project
运行效果:TEMP 温度 HUM 湿度
 10个月宝宝每天需要喝多少奶粉?