大家好,我是木木。
今天给大家分享一个强劲的 Python 库,scrapy。
scrapy
如果只是抓一个页面,几行 requests 加选择器就够了;但当任务变成多入口、分页、限速、重试、数据清洗和长期维护时,就需要一个真正的抓取框架。scrapy 做的正是这件事:把网页抽取从脚本推进成可配置、可扩展、可观察的工程流程。
项目地址:https://github.com/scrapy/scrapy
官方文档:https://docs.scrapy.org
三大特点
框架完整
Spider、Request、Response、调度器、下载器、中间件和 Pipeline 都已经有清晰分工,适合持续维护的抓取项目。
抽取灵活
内置 Selector 支持 CSS 和 XPath,列表页、详情页、链接发现和字段提取都能用统一方式表达。
生产友好
并发、重试、限速、robots、日志、导出和扩展机制比较成熟,适合从单机脚本逐步升级到稳定采集任务。
最佳实践
安装方式:python -m pip install Scrapy==2.15.2
我的建议是:先把页面抽取逻辑写成可测试的小函数或 Spider.parse,再接入真正的 crawler。这样页面结构变了以后,问题会暴露在样本测试里,而不是埋在长时间运行的任务里。
功能一:用 Selector 抽字段
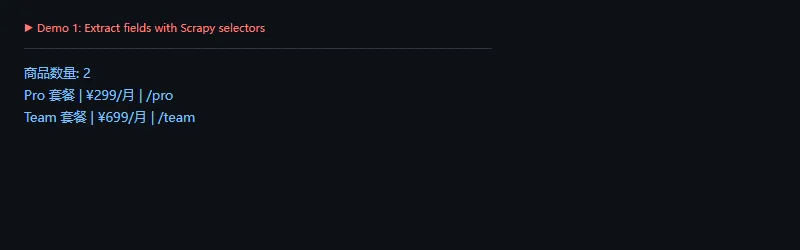
这段代码解决什么问题:先不启动 Scrapy 引擎,只用 Selector 验证 CSS 选择器和字段抽取。这个步骤很适合在写 Spider 前做页面样本测试。
fromscrapyimportSelectorhtml="""<html><body><article class="product"><h2>Pro 套餐</h2><span class="price">¥299/月</span><a href="/pro">详情</a></article><article class="product"><h2>Team 套餐</h2><span class="price">¥699/月</span><a href="/team">详情</a></article></body></html>"""selector=Selector(text=html)cards=selector.css("article.product")print("商品数量:",len(cards))forcardincards:name=card.css("h2::text").get()price=card.css(".price::text").get()href=card.css("a::attr(href)").get()print(f"{name} | {price} | {href}")
这种写法能把“选择器是否可靠”单独拎出来验证。正式项目里,可以把样本 HTML 放进测试目录,页面改版时第一时间知道哪几个字段失效。
功能二:把解析逻辑放进 Spider
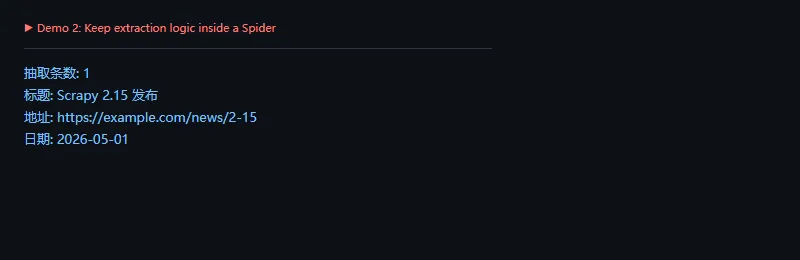
这段代码解决什么问题:Scrapy 项目真正可维护的地方在 Spider。把解析、URL 拼接和字段命名放进 parse,后面接调度、下载和导出时,结构会清楚很多。
importscrapyfromscrapy.httpimportTextResponsehtml="""<html><body><article class="news"><h2>Scrapy 2.15 发布</h2><a href="/news/2-15">阅读全文</a><time>2026-05-01</time></article></body></html>"""classNewsSpider(scrapy.Spider):name="news_demo"defparse(self,response):forrowinresponse.css("article.news"):yield{"title":row.css("h2::text").get(),"url":response.urljoin(row.css("a::attr(href)").get()),"date":row.css("time::text").get(),}response=TextResponse(url="https://example.com/news/",body=html.encode(),encoding="utf-8")items=list(NewsSpider().parse(response))print("抽取条数:",len(items))print("标题:",items[0]["title"])print("地址:",items[0]["url"])print("日期:",items[0]["date"])
这里没有真的发起网络请求,只是把一段 HTML 包成 TextResponse。这个技巧非常适合写单元测试:Spider 的解析逻辑可以脱离网络独立验证。
环境与版本信息
- Demo 环境:Windows 11,Python 3.11
- 关键依赖版本:
Twisted 25.5.0、parsel 1.11.0、w3lib 2.4.1 - 数据管道相关依赖:
itemadapter 0.13.1、itemloaders 1.4.0 - GitHub 最近一次推送时间:
2026-04-30T14:26:57Z
高级功能
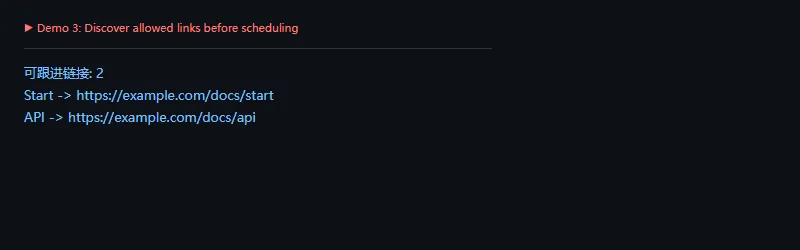
这段代码解决什么问题:真实抓取不能见链接就跟。LinkExtractor 可以在调度前按域名、路径和拒绝规则筛选链接,让 Spider 的边界更清楚。
fromscrapy.httpimportTextResponsefromscrapy.linkextractorsimportLinkExtractorhtml="""<html><body><a href="/docs/start">Start</a><a href="/docs/api">API</a><a href="/logout">Logout</a><a href="https://example.org/offsite">Offsite</a></body></html>"""response=TextResponse(url="https://example.com/",body=html.encode(),encoding="utf-8")extractor=LinkExtractor(allow=(r"/docs/",),deny=(r"/logout",),allow_domains=("example.com",))links=extractor.extract_links(response)print("可跟进链接:",len(links))forlinkinlinks:print(f"{link.text} -> {link.url}")
上线时不要只依赖代码里的判断。建议同时设置 allowed_domains、ROBOTSTXT_OBEY、并发数、下载延迟和最大深度,避免爬虫越界或访问过猛。
适用场景
- 你需要分页、详情页、链接发现、导出和数据清洗形成完整流程
不适用场景
- 只是抓一个简单页面,
requests、httpx 或 mechanicalsoup 更轻 - 页面主要依赖浏览器 JavaScript 渲染,且没有稳定接口可用
上线检查
- 明确 robots、服务条款、访问频率和数据使用边界,不要把框架能力当成默认许可。
- 给 Spider.parse 准备样本 HTML 测试,覆盖空字段、分页、详情链接和页面改版。
- 配好并发、限速、重试、缓存、日志和导出格式,再接入生产调度。
总结
scrapy 是一个偏工程化的抓取框架。它不只是“帮你拿网页”,而是把抓取任务拆成可维护的组件。小任务可以不用它,但当抓取链路开始变长、变多、变重要时,Scrapy 的价值就会很明显。
 10个月宝宝每天需要喝多少奶粉?