你是否遇到过服务器运行一段时间后,性能陡降、连接数莫名耗尽、应用频繁oom等诡异问题,很多时候,根源就藏在linux内核的某个参数里。
一、为什么要懂内核参数?
不知道大家是否遇到过这样的问题:
为什么nginx配置连接上限为backlog=511,高并发时还是有很多连接被拒绝?
为什么内存还很充足,系统就开始用swap,导致性能骤降?
为什么短连接服务跑一段时间就报"端口耗尽",无法建立新连接?
这些问题的答案,都藏在Linux内核参数里。今天,我就结合实际情况来聊聊那些运维必须知道的内核"开关"。
二、内核中网络相关参数
1. 半连接队列:net.ipv4.tcp_max_syn_backlog
作用:控制tcp半连接队列的最大长度
适用场景:服务器遭遇syn flood攻击,或者正常高并发时,大量连接卡在syn_recv状态
典型症状:
执行以下命令,数值持续居高不下;正常用户连接超时、建连失败。
netstat -ant | grep SYN_RECV | wc -l
如何设置:
#查看当前值cat /proc/sys/net/ipv4/tcp_max_syn_backlog#临时调整(重启失效)echo 2048 > /proc/sys/net/ipv4/tcp_max_syn_backlog#永久生效echo "net.ipv4.tcp_max_syn_backlog = 2048" >> /etc/sysctl.confsysctl -p
一般情况下,这个参数要和net.core.somaxconn配合使用,建议设为somaxconn的2倍左右。2. 全连接队列:net.core.somaxconn
作用:控制tcp已完成三次握手的全连接队列最大长度,是线上最容易踩坑的内核参数之一。
默认值:128(对高并发的web服务器来说严重偏小)
典型症状:
日志频繁出现"connection reset by peer"
nginx错误日志:"accept() failed (11: Resource temporarily unavailable)"
ss -lnt查看监听端口,Recv-Q 持续积压很高
#增大到65535echo 65535 > /proc/sys/net/core/somaxconn
Recv-Q:已建立连接但尚未被应用层 accept() 取走的数量。
3. time-wait复用:net.ipv4.tcp_tw_reuse
作用:复用time-wait状态的socket,解决短连接端口耗尽问题。
适用场景:api网关、反向代理、微服务短连接架构,产生大量time-wait连接。
症状:
netstat -ant | grep TIME_WAIT | wc -l
数量达到几千甚至上万;客户端报错 Address already in use、服务器本地端口耗尽。
配置要求必须同时开启时间戳,新内核彻底废弃 tcp_tw_recycle,严禁继续使用:#需要同时开启tcp_timestampsecho 1 > /proc/sys/net/ipv4/tcp_timestampsecho 1 > /proc/sys/net/ipv4/tcp_tw_reuse
三、内存篇:OOM与性能的平衡术
4. 交换倾向:vm.swappiness
最大的误区:以为设为0就是最好的!
作用:控制内核使用swap的倾向程度(0-100)
核心真相:
- 设为 0:并不是完全禁用 Swap,极端内存压力下仍会使用,旧版本易引发内存死锁;
- 设为 100:积极使用 Swap,磁盘替代内存,业务性能暴跌。
业务建议值(具体需要开发根据业务情况确定,默认推荐值):
数据库服务器(mysql、redis):10-20
应用服务器:30-50
开发测试机:60-80
#查看当前值cat /proc/sys/vm/swappiness#数据库服务器建议echo 10 > /proc/sys/vm/swappiness
5. 内存分配策略:vm.overcommit_memory
三种模式的通俗解释:
0(默认):启发式检查
内核会预测:"这个程序会不会申请太多内存?"
如果觉得"太多",就拒绝分配
可能误杀,但相对安全
1(总是允许):
要多少给多少
redis官方推荐用此模式
风险 oom killer可能误杀重要进程
2(严格检查):
分配的内存不能超过 swap + 物理内存 * overcommit_ratio
最安全,但也最严格
redis的推荐配置:
echo 1 > /proc/sys/vm/overcommit_memory
普通的业务,java程序保存默认0即可。
6. 脏页控制:vm.dirty_ratio 和 vm.dirty_background_ratio
先搞清楚两个概念:
脏页:数据在内存中修改了,但还没写到磁盘
刷脏:把脏页写到磁盘
两个参数的区别:
vm.dirty_background_ratio(比如10%):
当脏页达到内存的10%时,内核在后台开始刷脏
对应用基本无感
vm.dirty_ratio(比如20%):
当脏页达到内存的20%时,强制应用程序暂停写入
这时候应用就卡住了!
典型问题:
数据库大批量更新、消息队列写入时,业务突然卡顿十几秒,磁盘 IO 并不高,本质就是触发了同步刷脏阈值。
写密集业务优化建议:
#降低阈值,早点开始刷echo 5 > /proc/sys/vm/dirty_background_ratioecho 10 > /proc/sys/vm/dirty_ratio
四、文件篇:磁盘IO的优化开关
7. 文件句柄数:fs.file-max
症状:"Too many open files",这个是我们运维日常高频故障之一。
需同时修改系统级 + 用户级限制,用户级限制优先级更高。
1. 系统级限制:
#查看当前限制cat /proc/sys/fs/file-max# 增加限制echo 1000000 > /proc/sys/fs/file-max
编辑 /etc/security/limits.conf:
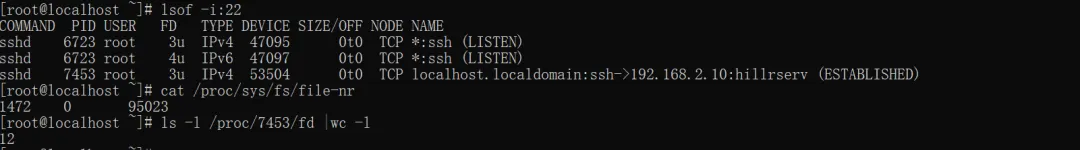
* soft nofile 65535* hard nofile 65535#查看句柄使用情况用了多少 cat /proc/sys/fs/file-nr#输出:1536 0 1000000#分别表示:已分配 已使用 最大值# 查看单个进程用了多少ls -l /proc/<PID>/fd | wc -l
8. 文件监控数:fs.inotify.max_user_watches
故障场景:
ide打开大项目,提示"文件监控数达到上限"
监控agent(如filebeat)报错退出
节点应用跑在容器里,监听文件变化失效
#默认通常是8192,可以增大echo 524288 > /proc/sys/fs/inotify/max_user_watches
五、内核篇:系统稳定的守护者
9. 崩溃重启:kernel.panic
相信几乎每个运维都遇到过这个场景:
凌晨3点,服务器内核panic。运维手机收到告警,打车到机房,发现屏幕卡在错误信息,需要手动按电源键。
避免方法:
#panic后60秒自动重启echo 60 > /proc/sys/kernel/panic#遇到Oops也触发panic(更激进)echo 1 > /proc/sys/kernel/panic_on_oops
注意:自动重启会丢失现场日志,故障排查阶段建议临时关闭,根据业务稳定性需求取舍。10. 救命键:kernel.sysrq
服务器卡死了,键盘鼠标都没反应,怎么办?
开启内核魔术键SysRq(PrtSc):
echo 1 > /proc/sys/kernel/sysrq
救命组合键(在物理机或虚拟机控制台有效,SSH 无效):
按住 Alt+SysRq(PrtSc) 不放,再按以下字母
六、常用内核参数查询
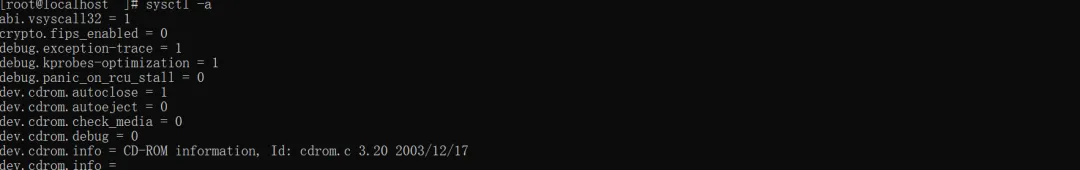
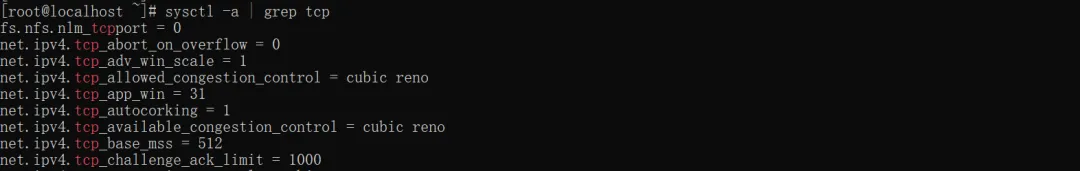
#查看所有参数sysctl -a#查看特定参数sysctl -a | grep tcp#直接查看cat /proc/sys/net/core/somaxconn
修改参数
#临时生效sysctl -w net.core.somaxconn=65535#或者用下面命令也可以 echo 65535 > /proc/sys/net/core/somaxconn#永久生效echo "net.core.somaxconn = 65535" >> /etc/sysctl.confsysctl -p
网络相关监控命令
#监控网络连接状态watch -n 1 'ss -n | awk '\''/^tcp/ {++S[$NF]} END {for(a in S) print a, S[a]}'\'''#监控TIME_WAITwatch -n 1 'ss -ant | grep TIME_WAIT | wc -l'#监控文件句柄watch -n 1 'cat /proc/sys/fs/file-nr'
八、最佳实践:安全地调整内核参数
先备份:cp /etc/sysctl.conf /etc/sysctl.conf.bak
测试环境验证:不要直接在生产环境改
渐进调整:一次只改1-2个参数,观察效果
监控告警:改之前设好监控,改之后盯着
记录文档:为什么改、什么时候改、预期效果
有人总结的内核参数就像汽车的变速箱:
不懂的人,只会踩油门硬抗
懂的人,知道什么时候换挡调参
我觉得非常形象。内核参数知识点繁杂,不用死记硬背,工作中边用边学、踩坑积累,慢慢就能吃透。如果这篇内容对你运维工作有帮助,记得点赞 + 关注。
#运维 #linux运维 #linux内核参数学习




 10个月宝宝每天需要喝多少奶粉?