当前位置:首页>python>一文讲清楚SQL和Python到底怎么选

一文讲清楚SQL和Python到底怎么选

  • 2026-10-11 08:04:22
一文讲清楚SQL和Python到底怎么选

一文讲清楚SQL和Python到底怎么选

在学习数据分析的路上,你是否会有这样的困惑:到底该先学SQL还是Python?处理某个具体需求时,是用SQL处理更高效,还是用Python更合适?明明知道两者都很重要,却始终摸不清它们的分工与配合逻辑……

今天就一次性把这些问题讲透:明确SQL与Python各自的核心场景,搞懂什么时候用SQL取数,什么时候用Python清洗建模,让两大工具真正协同发力,实现1+1>2的数据分析效果。

01

SQL和Python如何分工

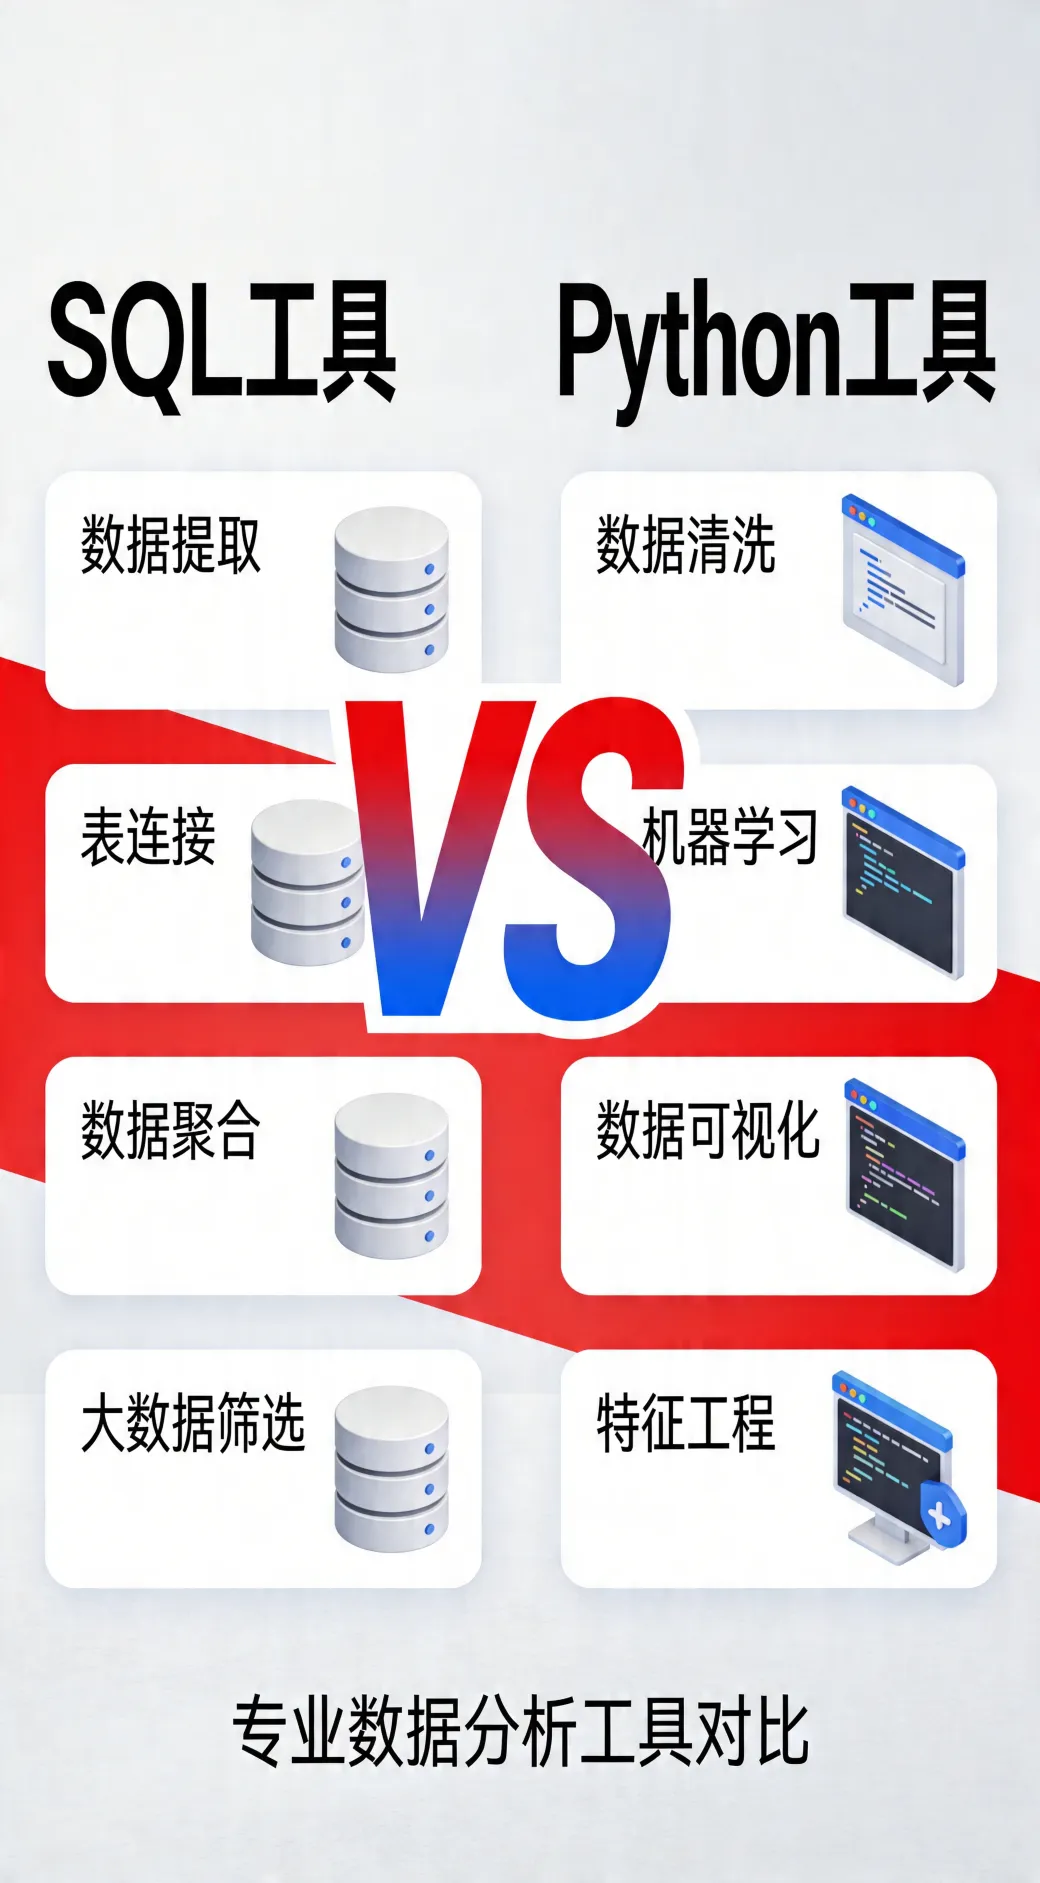
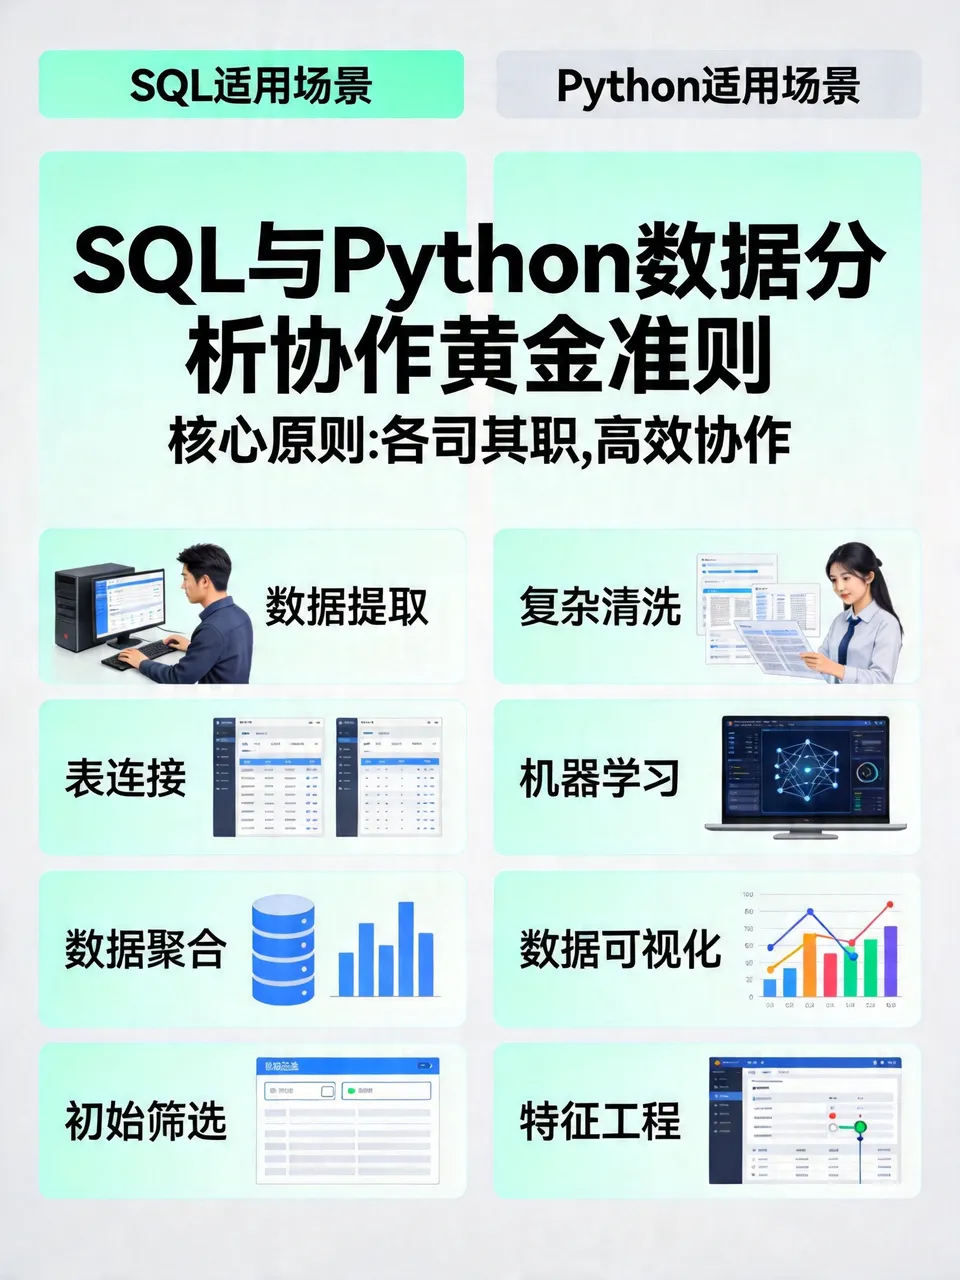
简单来说,SQL负责取数和初加工,Python负责深加工和建模。

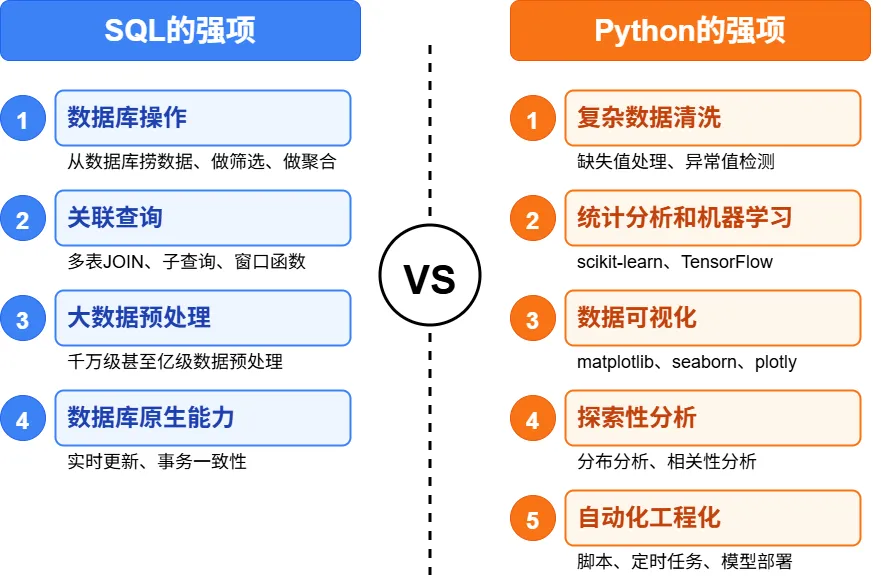
如果你要和数据库打交道,从海量数据里捞东西出来,SQL是当之无愧的主角。它专注于在数据库中快速检索你需要的数据,还能高效完成同类数据的归类、统计等基础处理工作。

具体来说,当你需要从数据库里提取数据、做筛选、做聚合时,SQL的速度优势非常明显。特别是面对百万级甚至千万级的数据量时,SQL的查询效率比Python高出不止一个量级。而且对于多表JOIN、子查询、窗口函数这类操作,SQL的语法设计就是为此量身定做的,写起来直观,跑起来飞快。此外,如果你的数据需要实时更新,或者要保证事务的一致性,这些数据库的原生能力也是SQL的强项。

而当数据从数据库里拿出来,需要做更深入的处理时,就该Python出场了。Python的优势在于它能做那些SQL做起来很费劲,甚至根本做不到的事情。

比如说复杂的数据清洗,缺失值怎么填补、异常值怎么处理、多步转换的逻辑怎么实现,这些用pandas写起来直观多了。再比如统计分析和机器学习,scikit-learn、TensorFlow这些库的能力是SQL完全无法比拟的。数据可视化也是Python的强项,matplotlib、seaborn、plotly让你想画什么图就能画什么图,定制化程度高,而且能快速做探索性分析,看看数据的分布和相关性。至于写脚本、做定时任务、部署模型这些工程化的工作,Python更是当仁不让。
02

典型的数据分析工作流

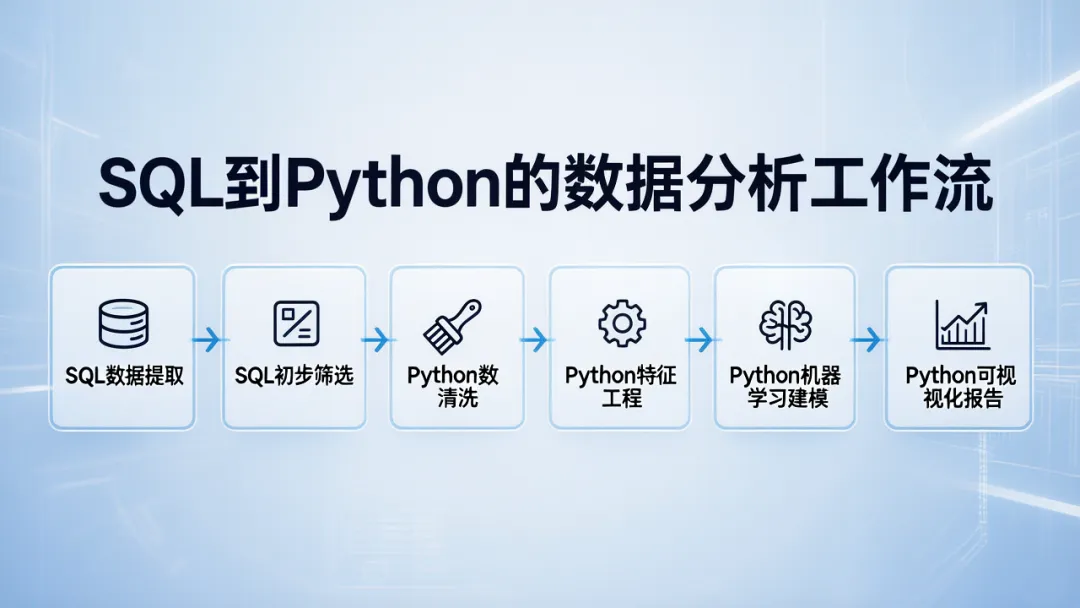
在实际的数据分析项目中,SQL和Python会在不同阶段各司其职,形成完整的工作流程。

首先,SQL先上场。它从数据库里提取原始数据,做初步的筛选和过滤,把那些明显不需要的数据剔除掉,把需要的数据准备好。这一步很关键,因为只有把原材料选对了,后面的加工才有意义。接下来Python接过接力棒,开始处理数据的细节——填补缺失值、识别并处理异常值、统一数据格式。这些"脏活累活"虽然看起来不那么高大上,但却是保证分析质量的基础。

数据清洗干净后,Python继续构建特征、做编码、生成衍生变量,为建模做准备。然后是模型训练和评估,这一步Python的机器学习库就派上用场了。最后,Python生成可视化图表,写分析报告,把整个分析过程的结果呈现出来。

整个流程下来你会发现,没有最好的工具,只有最合适的工具。每个阶段用什么工具,完全取决于任务的特点。

03

实战案例:用户流失预测项目

光说理论可能还不够直观,我们看一个真实的案例。

某互联网产品需要分析海量用户数据,其中包含2000万条用户行为日志和500万条用户画像数据,目的是精准预测潜在流失用户,以便提前实施挽留措施。这个项目正是SQL与Python配合的典型场景。

01

SQL搞定数据提取

-- 从用户行为日志中提取关键指标SELECT    user_id,    MAX(login_date) as last_login_date,    COUNT(*) as total_actions,    COUNT(DISTINCTDATE(login_date)) as active_days,    SUM(CASEWHEN action_type ='purchase'THEN1ELSE0END) as purchase_countFROM user_behavior_logWHERE login_date >='2024-01-01'GROUPBY user_id;

这段SQL代码看起来简单,但它做的事情可不简单:从2000万条行为日志里,把每个用户的关键行为指标提取出来,聚合成一行一行的特征数据。如果用Python来做这个事情,光是JOIN和GROUP BY就能跑半天,而且内存占用会非常夸张。

SQL的优势在这里发挥得淋漓尽致——它不需要把所有数据都加载到内存里,直接在数据库层面完成聚合,最后只输出一个精简的结果集。2000万条数据,经过SQL处理后可能就变成了几十万条,数据量一下子降到了Python能轻松处理的规模。

02

Python接手数据清洗和建模

import pandas as pdfrom sklearn.model_selection import train_test_splitfrom sklearn.ensemble import RandomForestClassifier# 读取SQL提取的数据user_features = pd.read_csv('user_features.csv')# 数据清洗:处理缺失值和异常值user_features['avg_session_duration'].fillna(    user_features['avg_session_duration'].median(), inplace=True)# 构建标签(30天内无登录定义为流失)user_features['churn'] = (    (pd.to_datetime('today') - pd.to_datetime(user_features['last_login_date'])).dt.days > 30).astype(int)# 特征工程user_features['activity_intensity'] = (    user_features['total_actions'] / (user_features['active_days'] + 1))# 建模X = user_features[['total_actions', 'active_days', 'purchase_count', 'activity_intensity']]y = user_features['churn']model = RandomForestClassifier(n_estimators=100)model.fit(X_train, y_train)

Python在这里做了几件事:首先处理数据质量问题,填补缺失值、处理异常值;然后构建标签和特征,把原始数据变成模型能用的格式;最后训练模型并评估效果。这些工作如果用SQL来做,要么根本做不到,要么代码会复杂到难以维护。

这个项目的最佳实践就是SQL+Python的组合。 SQL负责数据提取和初步聚合,把2000万条数据压缩到可管理的规模;Python负责数据清洗、特征工程、建模和可视化,把分析做深做透。两者配合,效率比单独用任何一个工具都要高得多。

04

常见误区

在掌握了两者的分工与协作流程后,实际操作中还容易陷入一些典型误区,直接影响分析效率与结果质量,常见的有以下四类:

01

误区一:什么都用Python处理

直接将千万级数据读取到内存中,极易导致设备卡顿,原本只需一句SQL关联语句就能解决的问题,却用大量pandas代码复杂实现,既浪费时间又降低效率。

高效的做法是,能用SQL处理的尽量用SQL,Python只处理SQL做不了的部分。

02

误区二:数据全靠SQL处理

一个SQL写了几百行,全是嵌套子查询。或是本该用Python做可视化,却硬要在SQL里折腾。不仅代码难以维护,也无法实现复杂的分析效果。

所以,应该让SQL和Python各司其职,让SQL专注数据提取,复杂分析与建模任务交给Python。

03

误区三:忽视数据一致性

把数据从数据库拉到Python之后,就完全脱离了数据库的约束,容易出现数据类型不匹配,数据更新后Python和SQL的结果对不上等问题。

那么怎么避免呢?建立数据同步机制,确保Python处理后的结果能写回数据库。

04

误区四:不会用连接池

每次查询都重新建立数据库连接,效率低下,增加数据库压力。

因此,使用SQLAlchemy建立连接池,复用连接。

from sqlalchemy import create_engineengine = create_engine(    "mysql+pymysql://user:pass@localhost/db",    pool_size=10, max_overflow=20, pool_recycle=3600)

05

性能优化小技巧

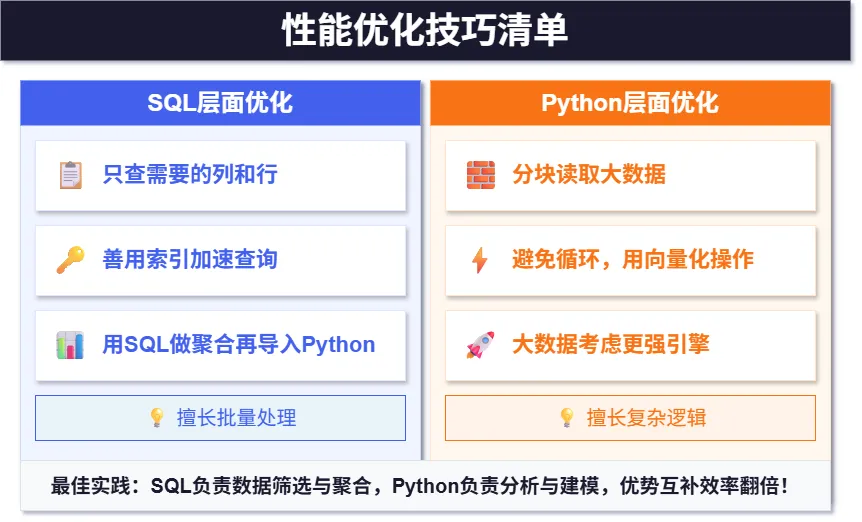
掌握了基本的分工原则,再分享一些性能优化的小技巧,帮你把效率再提升一个档次。

SQL层面

  1. 最基础但也最重要的:只查询你需要的列和行。很多人习惯用 SELECT \*,觉得方便,但这样会把所有列都读出来,数据量大的时候非常影响性能。养成好习惯,只查询需要的字段。

  2. 其次,善用索引。确保WHERE条件和JOIN条件的字段有合适的索引,查询速度可能会有数量级的提升。如果发现某个查询特别慢,第一件事就是检查索引。

  3. 另外,能用SQL做的聚合,就别把原始数据拉到Python再聚合。SQL的GROUP BY是在数据库层面执行的,效率远高于在Python内存里做同样的操作。

Python层面

  1. 遇到百万级以上的数据,不要一次性全部读进内存。pandas提供了分块读取的功能,可以按批次处理数据:

    chunks = pd.read_sql_query('SELECT * FROM large_table',    engine,    chunksize=10000)for chunk in chunks:    process(chunk)
  2. 避免用循环处理数据,尽量用pandas的向量化操作。比如计算两列的和,用 df['new_col'] = df['a'] + df['b'] 而不是循环遍历每一行。向量化操作底层是C语言实现的,速度比Python循环快很多。
  3. 如果你的数据量实在太大,pandas处理起来吃力,可以考虑用Polars、Dask或PySpark这些更强大的工具。Polars比pandas快很多,而且API很相似,上手成本低;Dask和PySpark则适合分布式处理超大规模数据。

06

最后总结

SQL与Python从来不是非此即彼的选择,而是各有所长、互补配合的黄金搭档。SQL擅长高效提取、筛选与聚合海量数据库数据,是数据工作的基础入口;而Python则能胜任复杂的数据清洗、统计建模、机器学习与可视化分析,是深度挖掘数据价值的全能工具。

在实际数据分析工作中,最佳实践便是让二者各司其职:基础的数据提取、多表关联与初步筛选交给SQL,复杂的数据清洗逻辑、建模分析则交由Python完成。发挥各自优势,不强行用Python处理大数据量的预处理工作,也不在SQL中硬做复杂的统计运算。同时兼顾数据量与性能,大数据先通过SQL完成预处理,Python处理时尽量采用向量化方式,才能让整体流程更高效。对于新手而言,建议先学好SQL夯实数据基础,再逐步掌握Python拓展分析能力,二者结合才能真正实现效率最大化。

总而言之,SQL帮你找到数据,Python帮你读懂数据,只有用好这对组合,才能让数据真正为业务赋能。

最新文章

随机文章