Python爬虫入门连载09:综合实战项目——新闻自动采集并保存Excel完整项目
到现在我们已经全部学完:
requests请求、bs4网页解析、单页/分页爬取、图片下载、数据存Excel、基础反爬伪装。今天把所有知识点全部整合,做一个可以直接拿来用的:
新闻自动采集爬虫完整项目具备功能:
1.伪装浏览器反爬,防拦截
2.自动分页爬取多页新闻
3.提取新闻标题、新闻链接
4.自动过滤无效空数据
5.全部数据自动保存到Excel
6.每页延时访问,礼貌爬取不封IP
一套代码,以后换个网址就能直接复用。
一、项目整体流程
1.配置请求头 + 开启会话保持
2.循环分页1~N页
3.拼接每一页URL
4.请求网页、解析源码
5.提取标题、链接
6.过滤无效数据
7.逐行写入Excel
8.每页延时1秒防反爬
9.全部爬完保存Excel文件
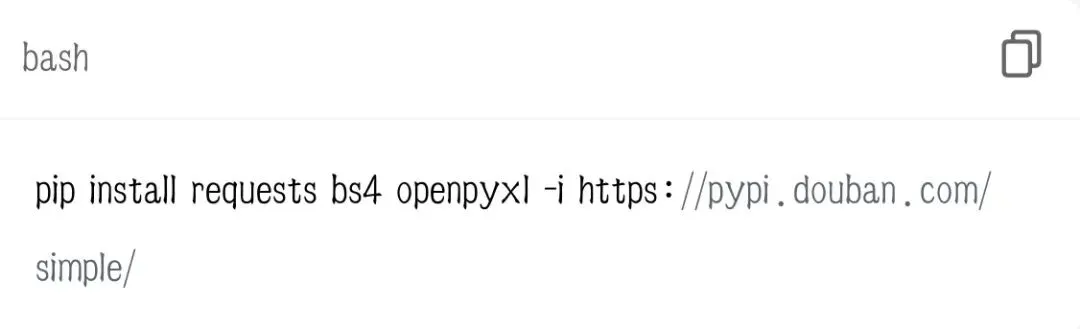
二、提前确认已安装库
没装的执行:
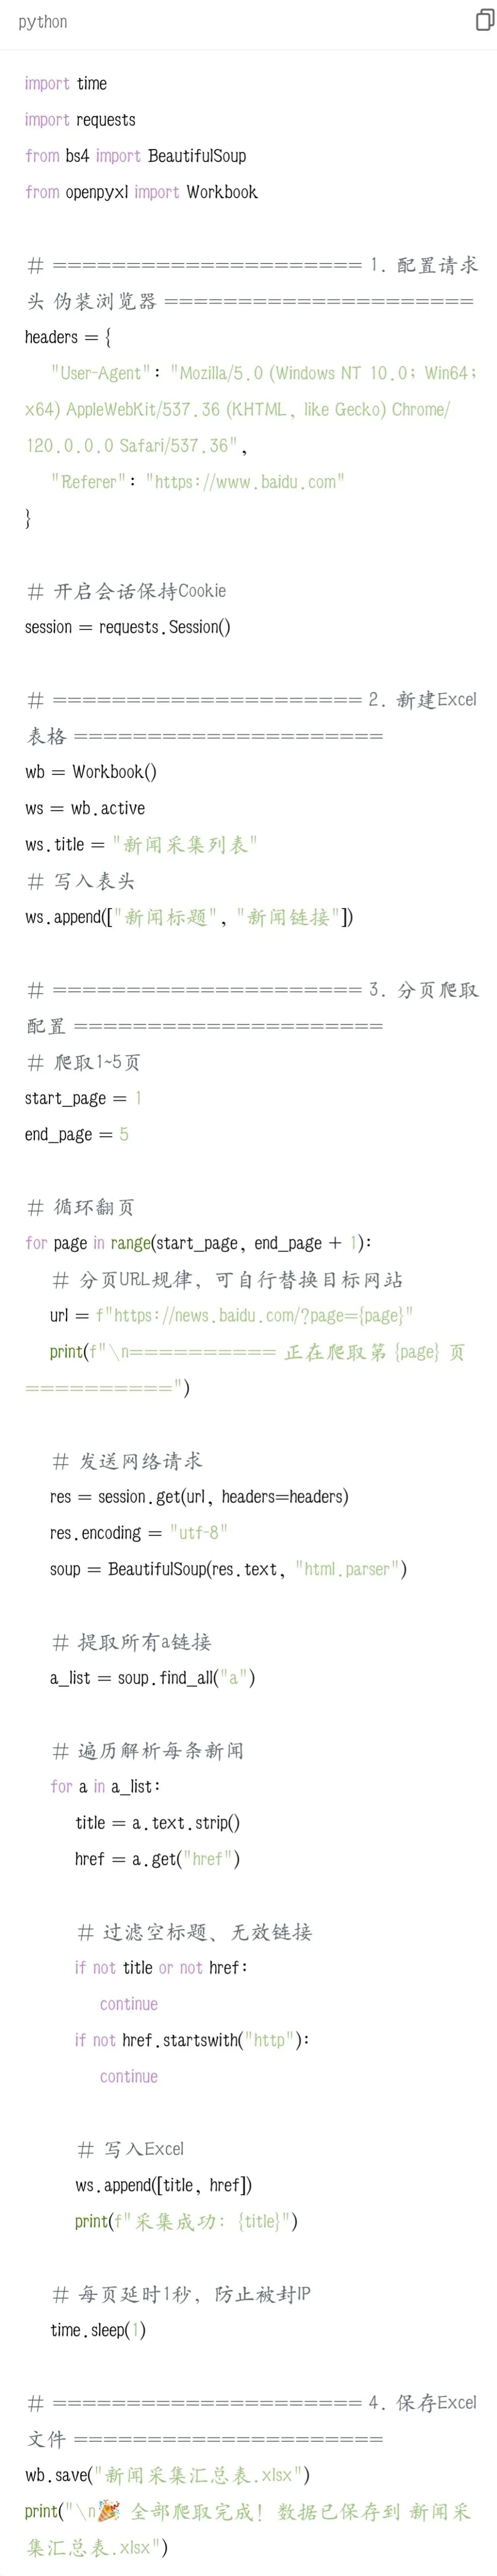
三、完整可直接运行源码四、核心模块拆解讲解
1. 反爬配置
·加 User-Agent 伪装浏览器
·加 Referer 防盗链
·用 Session 保持会话Cookie
·每页 time.sleep(1) 延时访问
2. Excel初始化
提前建好表头,循环中不断 append 追加行,最后统一保存。
3. 分页逻辑
for page in range(起始页, 结束页+1)
用 f-string 动态拼接每页网址,结构统一,无需重复写代码。
4. 数据过滤
过滤空标题、过滤非http链接,保证Excel里数据干净无垃圾。
五、如何换成其他网站使用
只需要改2个地方:
1.修改分页URL模板 url = f"你的网址?page={page}"
2.若网页标签不一样,微调 find_all 匹配的标签和class
整体框架完全不用改,直接套用即可。
六、新手常见问题排查
❌ Excel已经打开,代码保存失败 → 关闭Excel再运行
❌ 爬取为空 → URL规律不对、标签没找对
❌ 被网站拦截 → 检查是否加了UA、是否加了延时
❌ 中文乱码 → 一定要设置 res.encoding = "utf-8"
七、本期项目可扩展升级方向
你可以自己继续拓展:
1.增加爬取发布时间、简介存入Excel
2.改成爬取壁纸网站,分页批量下载图片
3.增加异常捕获,爬错自动跳过不崩溃
4.把页数、网址改成可配置,不用改代码
本期小结
1.整合爬虫全套技能:请求、解析、分页、反爬、存Excel
2.项目结构标准,可直接当模板复用
3.自动分页采集、自动过滤脏数据、一键生成报表
4.延时+请求头+会话三重反爬,访问更稳定
5.学会这套框架,大部分普通资讯站都能轻松爬
小作业
替换成另一个资讯网站,修改URL规律,实现1~3页新闻采集并保存Excel。
下期预告
Python爬虫连载10:爬虫全套完结总结 + 后续进阶学习路线汇总爬虫全部知识点、避坑大全、告诉你接下来学什么:异步爬虫、解析神器XPath、Scrapy框架等进阶方向!
 10个月宝宝每天需要喝多少奶粉?