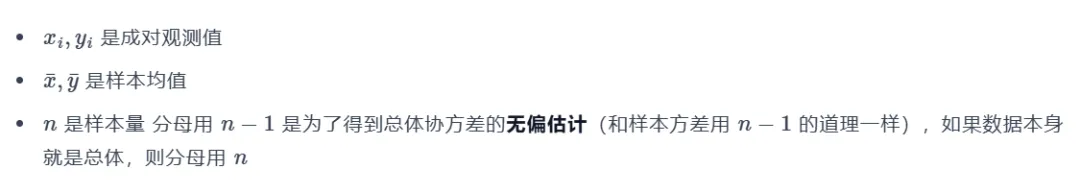
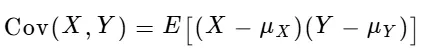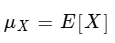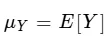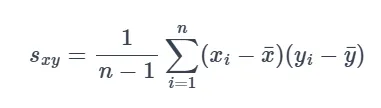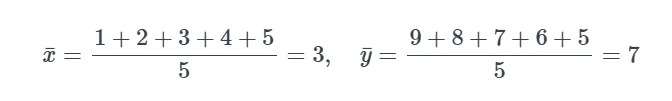深入理解“偏差叉积”
公式的核心是 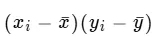 ,常称它为偏差的交叉乘积,简称“偏差叉积”
“叉积”在这里不是向量外积(cross product),而是指把一个变量的偏差和另一个变量的偏差相乘,突出“交叉”的含义
与之对照:
- 方差用的是偏差平方:
 ——自己乘自己
- 协方差用的是偏差叉积:
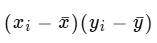 ——一个乘另一个
这个乘积的正负号非常有信息量:
- 当
x 高于均值(偏差为正),y 也高于均值(偏差为正),乘积为正 - 当
x 高于均值,而 y 低于均值(偏差为负),乘积为负 - 正负号反映了该数据点上两个变量相对于均值是同向偏离还是反向偏离
把所有点的偏差叉积加起来再平均,若大部分点同向偏离,总和为正,协方差大于零;若大部分反向偏离,总和为负,协方差小于零,所以,协方差就是“平均化的偏差叉积”
手算实例:完全负相关的例子
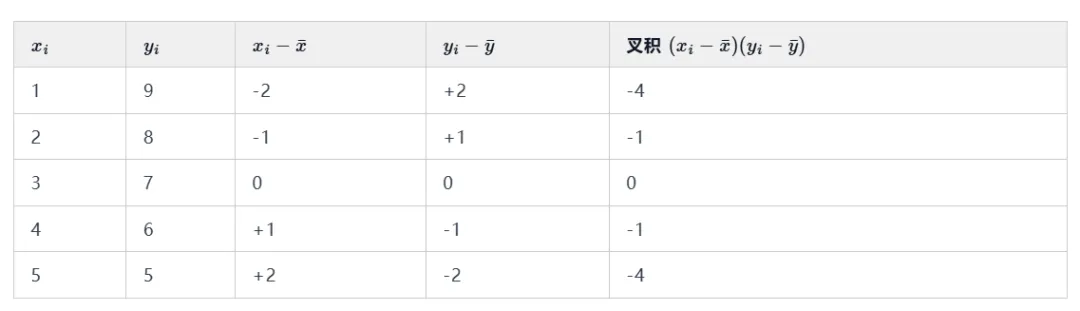
用一组具体数据演示计算过程:
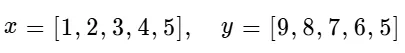
第一步:计算均值
第二步:计算每一点的偏差叉积
第三步:求和并平均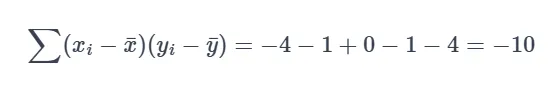
样本协方差(除以  ):
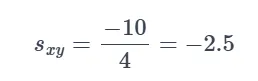
结果为负值,说明 x 和 y 存在负向变化关系,事实上这组数据完全满足 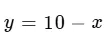 ,是完美的线性负相关
协方差的局限性与相关系数
协方差的大小受变量测量尺度的影响,如果把 x 和 y 的单位扩大100倍,协方差会放大 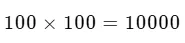 倍,但两者关系的强弱完全没有改变
因此,不宜直接用协方差的大小来比较不同数据集的关联强度
为消除量纲影响,将协方差“标准化”,得到 皮尔逊相关系数: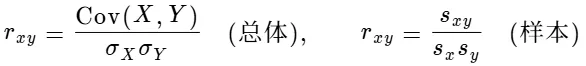 相关系数永远在[-1, 1]之间,便于解读
对于上例,可以算出标准差 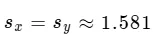 ,相关系数
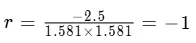 ,印证了完全负相关
利用 Python 计算协方差
数据分析中当然不会每次都手算,下面介绍三种 Python 计算方法
1、纯 Python 手动实现
直接按照公式编写函数,帮助理解计算过程。
defcovariance(x, y, sample=True): n = len(x) mean_x = sum(x) / n mean_y = sum(y) / n cross_prod_sum = sum((xi - mean_x) * (yi - mean_y) for xi, yi in zip(x, y)) denom = n - 1if sample else nreturn cross_prod_sum / denomx = [1, 2, 3, 4, 5]y = [9, 8, 7, 6, 5]print(covariance(x, y)) # 样本协方差,输出 -2.5print(covariance(x, y, sample=False)) # 总体协方差,输出 -2.0
2、使用 NumPy
numpy.cov 默认计算样本协方差矩阵,可通过参数 ddof 调整
import numpy as npx = np.array([1, 2, 3, 4, 5])y = np.array([9, 8, 7, 6, 5])# 协方差矩阵,对角线为方差,非对角线为协方差cov_matrix = np.cov(x, y)print(cov_matrix)# [[ 2.5 -2.5]# [-2.5 2.5]]# 提取 x 和 y 的协方差cov_xy = np.cov(x, y)[0, 1] # -2.5# 或者指定 ddof=0 得到总体协方差cov_xy_pop = np.cov(x, y, ddof=0)[0, 1] # -2.0
注意:np.cov 要求输入是行排列,即每一行是一个变量,因此传入的两个数组会被视为两个变量
3、使用 Pandas
如果用 Pandas 处理数据框,可以非常方便地计算协方差矩阵
import pandas as pddf = pd.DataFrame({'x': [1, 2, 3, 4, 5],'y': [9, 8, 7, 6, 5]})# 协方差矩阵(默认样本协方差,分母 n-1)print(df.cov())# x y# x 2.5 -2.5# y -2.5 2.5# 提取 x 和 y 的协方差cov_xy = df['x'].cov(df['y']) # -2.5
Pandas 的 cov 方法也能通过参数调整,例如 df.cov(ddof=0) 得到总体协方差
总结
- 协方差 衡量两个变量线性关系的方向:正、负或零
- 它本质上是平均化的偏差叉积,叉积指两个变量偏差的交叉乘积
- 协方差受量纲影响大,难以跨数据集比较强度,因此常标准化为相关系数
- Python 中可通过手写公式、NumPy 的
cov 或 Pandas 的 cov 轻松计算协方差
掌握协方差,就打开了理解多元统计关系的大门,希望这篇文章能让你不仅“知其然”,更“知其所以然”
历史相关文章
以上是自己实践中遇到的一些问题,分享出来供大家参考学习,欢迎关注微信公众号DataShare,不定期分享干货
整理的一个资源共享库:
https://github.com/DataShare-duo/datashare_data