我前面那篇讲收包拷贝路径的时候,提到 ring buffer 那一页"安静地躺在那等网卡来写"。顺着这个,就自然要问:那一页到底怎么跟网卡对接的,描述符又是什么东西。这问题问到点子上了——ring buffer 这个名字容易让人以为它就是一块连续的大缓冲,网卡往里写、内核从里读。其实完全不是。
RX ring 是一圈描述符,描述符里只存一个指向数据页的地址。真正装帧数据的是另外分配的内存页。网卡、描述符、内存页,三者靠地址和状态位完成一次握手。
描述符环长什么样
以 Intel 网卡为例,RX 描述符环是一块用 dma_alloc_coherent 分配的一致内存(consistent DMA memory),里面是一排 struct e1000_rx_desc(这是 legacy 描述符格式,igb 的 union igb_rx_desc 也包含这个布局,足以说明交互原理):
struct e1000_rx_desc {
    __le64 buffer_addr;   /* 数据页的总线地址,网卡往这写 */
    __le16 length;        /* 网卡回写:帧长度 */
    __le16 csum;          /* 校验和 */
    u8     status;        /* 网卡回写:DD / EOP 等位 */
    u8     errors;
    __le16 special;
};
关键看两个字段:buffer_addr 是给网卡写数据的目标地址(总线地址,不是虚拟地址);status 里的 DD(Descriptor Done)位是网卡告诉驱动"我写完了"的信号。
注意这个结构体才 16 字节,里面不含任何帧数据。ring 的大小由 ethtool -g 看(不同网卡默认不同,这里以某 Intel 网卡为例):
$ ethtool -g eth0
Current hardware settings:
RX:             512
512 个描述符,每个 16 字节,描述符环总共才 8KB。但它背后挂着 512 个 4KB 的数据页——真正的存储开销在那些页上。
数据页是另一块内存
每个描述符 buffer_addr 指向一个独立的数据页。这个页不是描述符环的一部分,是驱动用 alloc_page 分配、再用 dma_map_page 映射出总线地址后填进 buffer_addr 的:
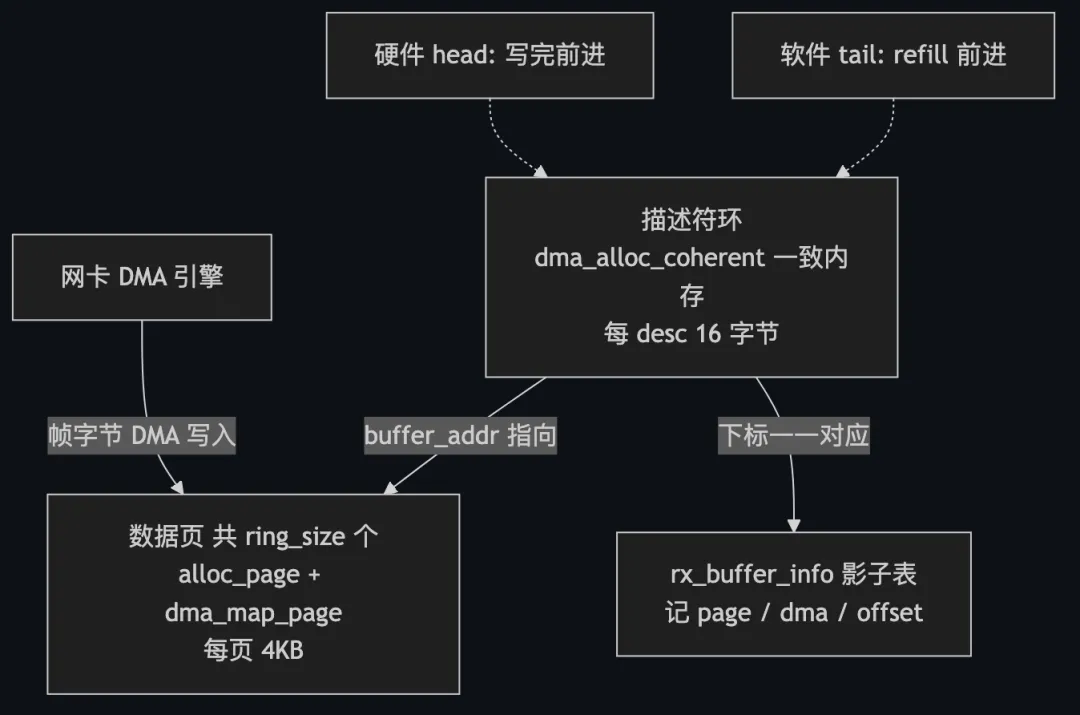
这里有个容易被忽略的点:数据页的地址关系是驱动自己记的。网卡回写描述符时只会写 length、status 等字段(并不记录这是哪个 struct page),驱动光看描述符没法反查出对应的页和 dma 句柄。所以每个驱动都维护一张影子表 rx_buffer_info[](igb 里叫 struct igb_rx_buffer),存着 page、dma、page_offset 这些元数据,下标和描述符一一对应。
一次 DMA 握手的全过程
把三者串起来,一个帧从网卡到 skb 的握手是这样走的:
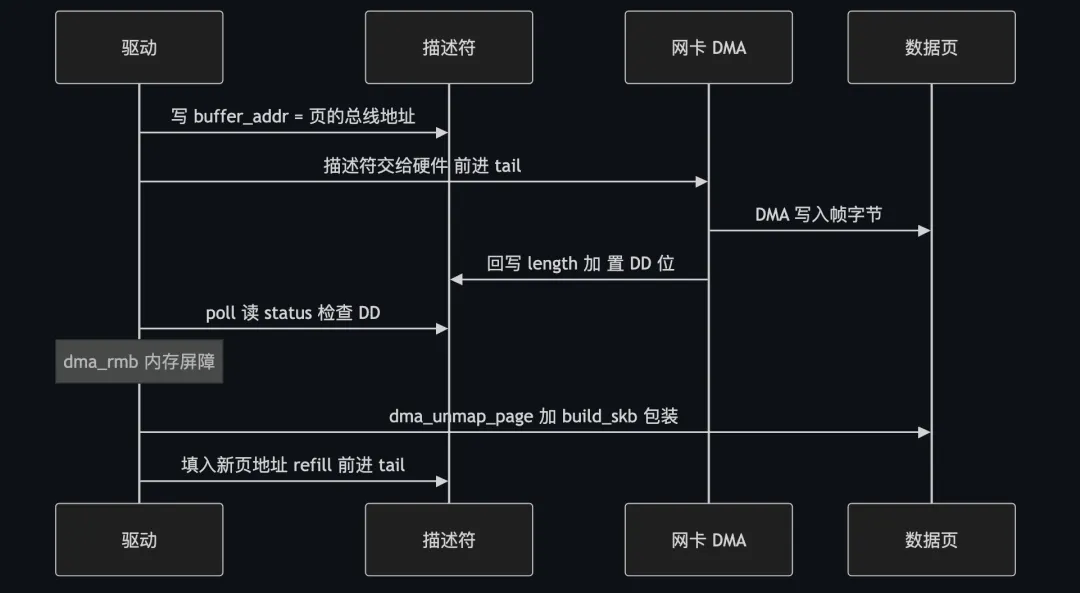
一步一步说:
- 驱动分配一个页,
dma_map_page 得到总线地址,写进某个空闲描述符的 buffer_addr,状态清零,描述符交给硬件(驱动前进 tail 指针)。 - 网卡收到帧,按描述符里的
buffer_addr 把帧字节 DMA 写入那一页物理内存。 - 网卡在描述符里回写
length,并置上 DD 位(EOP 表示这是包的最后一描述符)。 - 驱动的 NAPI poll 循环读描述符状态,先用
dma_rmb() 内存屏障保证看到的是网卡写回的值,再检查 DD。 DD 置位 → 驱动对这页做 dma_unmap_page,用 build_skb 把它包装成 skb,交给协议栈。- 驱动立刻给这个位置 refill 一个新页的地址,前进 tail,把环补满。
整圈下来,网卡和驱动不直接传数据,只传"地址"和"状态位"。数据从头到尾只在那页物理内存里待着,被 DMA 写一次、被 copy_to_user 读一次。
head 和 tail:环是怎么转起来的
描述符环是环形的,靠两个指针转:
- head(硬件维护):网卡写完一个描述符,head 前进一格。
- tail(软件维护):驱动 refill 一个新页,tail 前进一格。
驱动永远在 head 和 tail 之间补页。当 head 追上 tail(环满了,没有空闲描述符),新到的帧没地方放,网卡只能丢弃——这时候 ethtool -S eth0 | grep rx_missed 的丢包计数就会涨。所以 ring size 太小、收包慢,会直接体现在 rx_missed_errors 上。
ring 的下标用 index & (size - 1) 取模回绕(size 必须是 2 的幂),这就是"环形"的实现方式,不需要真把内存首尾相接。
page_pool:省掉每次的 map/unmap
上面第 1、5 步的 dma_map_page / dma_unmap_page 每个包都要做一次,在高 PPS 下是不小的开销。现代内核引入了 page_pool:数据页用完后不立刻释放,标记回收,下次 refill 直接复用同一页,跳过重新映射。相当于给 RX 路径做了个页缓存,把 per-packet 的 DMA 映射成本摊薄掉。
这也是为什么你 free 看内存时,会看到一块固定的、删不掉的内核内存——那批 ring 页被 page_pool 长期持有,等着下一轮收包。
几个能马上用上的查看命令
ethtool -g eth0                   # 看 ring 大小
ethtool -l eth0                   # 看网卡队列数(channels)
ethtool -S eth0 | grep rx_missed  # ring 满丢弃计数
cat /proc/slabinfo | grep skb     # skb 元数据缓存
ring buffer、描述符、内存页、DMA,四者各管一摊:描述符是"索引+状态",内存页是"实际存储",DMA 是"搬运工",驱动是"调度"。搞清楚谁是谁,收包路径上那些"丢包""延迟""内存占用"的锅,才知道该扣在谁头上。
 10个月宝宝每天需要喝多少奶粉?