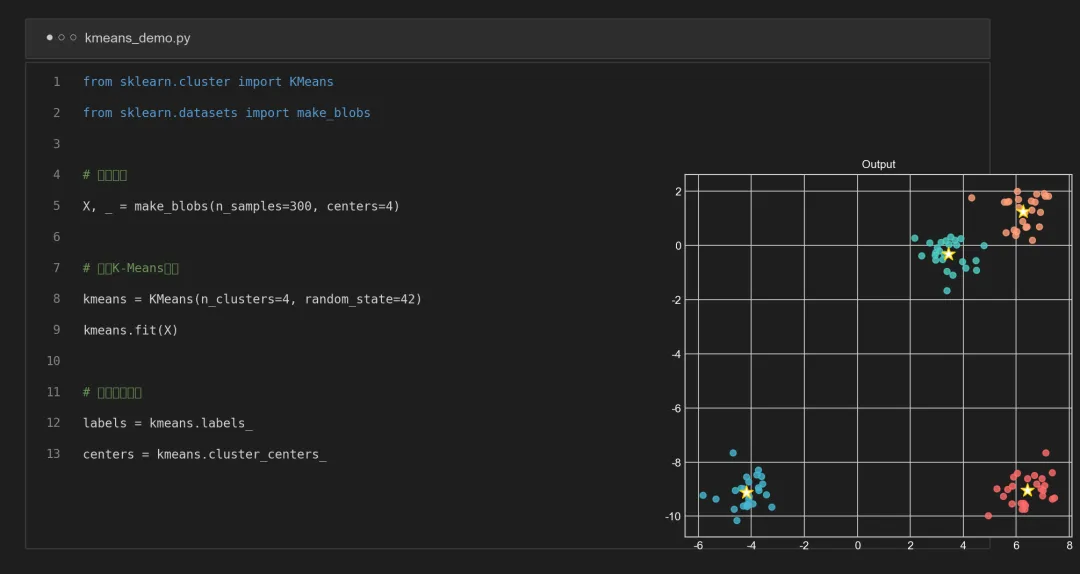
用 sklearn 和纯 Python 两种方式实现,代码完整、注释详尽
方式一:sklearn 一行搞定(推荐)
from sklearn.cluster import KMeansfrom sklearn.datasets import make_blobsimport matplotlib.pyplot as plt# 1. 生成模拟数据:300个点,分成4个簇X, y_true = make_blobs( n_samples=300, # 数据点数量 centers=4, # 真实的簇数量 cluster_std=0.8, # 簇的分散程度 random_state=42)# 2. 创建并训练K-Means模型kmeans = KMeans( n_clusters=4, # 指定分成4组 random_state=42, # 保证结果可复现 n_init=10 # 运行10次,选最优结果)kmeans.fit(X)# 3. 获取结果labels = kmeans.labels_ # 每个点的簇标签centers = kmeans.cluster_centers_ # 质心坐标# 4. 可视化plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='viridis', s=50)plt.scatter(centers[:, 0], centers[:, 1], c='red', marker='X', s=200, label='Centroids')plt.legend()plt.show()# 5. 预测新数据new_points = [[0, 0], [3, 3]]predictions = kmeans.predict(new_points)print(predictions) # 输出: [1 2]
方式二:纯 Python 实现(理解原理)
import numpy as npdef kmeans(X, k, max_iters=100): """ 纯Python实现K-Means X: 数据矩阵 (n_samples, n_features) k: 簇的数量 """ n_samples, n_features = X.shape # 1. 随机初始化质心 np.random.seed(42) centroids = X[np.random.choice(n_samples, k, replace=False)] for _ in range(max_iters): # 2. 分配:每个点找最近的质心 distances = np.linalg.norm(X[:, np.newaxis] - centroids, axis=2) labels = np.argmin(distances, axis=1) # 3. 更新:重新计算质心 new_centroids = np.array([ X[labels == i].mean(axis=0) if np.sum(labels == i) > 0 else centroids[i] for i in range(k) ]) # 4. 检查是否收敛 if np.allclose(centroids, new_centroids): break centroids = new_centroids return labels, centroids# 使用X, _ = make_blobs(n_samples=300, centers=4, random_state=42)labels, centroids = kmeans(X, k=4)
核心 API 速查
| |
|---|
fit(X) | |
predict(X) | |
fit_predict(X) | |
labels_ | |
cluster_centers_ | |
inertia_ | |
进阶:自动选 K 值
from sklearn.cluster import KMeansimport matplotlib.pyplot as pltinertias = []K_range = range(1, 10)for k in K_range: km = KMeans(n_clusters=k, random_state=42, n_init=10) km.fit(X) inertias.append(km.inertia_)# 绘制肘部图plt.plot(K_range, inertias, 'bo-')plt.xlabel('K')plt.ylabel('Inertia')plt.title('Elbow Method')plt.show()