《Python深度学习基于PyTorch(第2版)》—项目集
为什么有了【习题集】还要再推出一套【项目集】?
我们当初编写习题集,是希望帮助大家查漏补缺、夯实基础。但习题集终究偏重“知识点”的训练,覆盖维度相对单一,难以呈现完整的项目实战面貌。因此,作为习题集的重要补充,我们正在同步打造一套“源于本书、又高于本书”的配套【项目集】。
每一个项目体现实战性、工程化思维。我们希望这套项目集不仅能巩固所学,更能帮助大家把零散的知识,沉淀为一个个有亮点、能讲透、甚至能打动面试官的精品项目,让你在学习、求职和工作中,真正脱颖而出!
一、项目名称:
《用NumPy手写回归到PyTorch自动微分的四阶段演进》
二、项目实施步骤总览
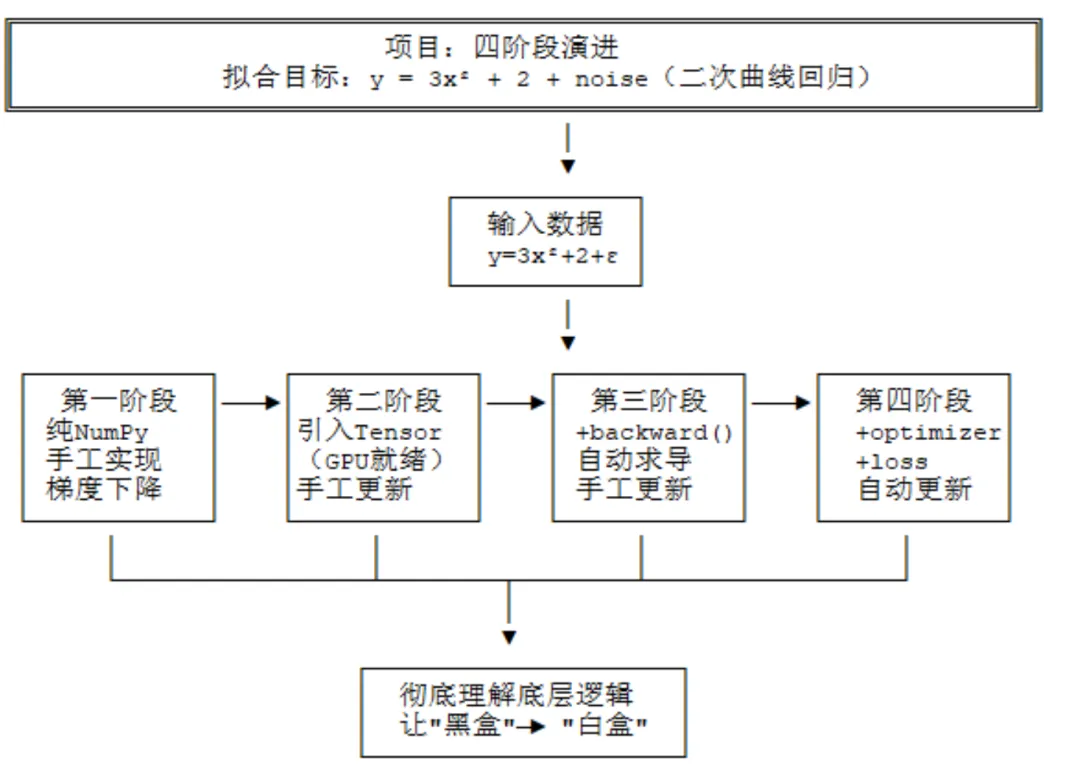
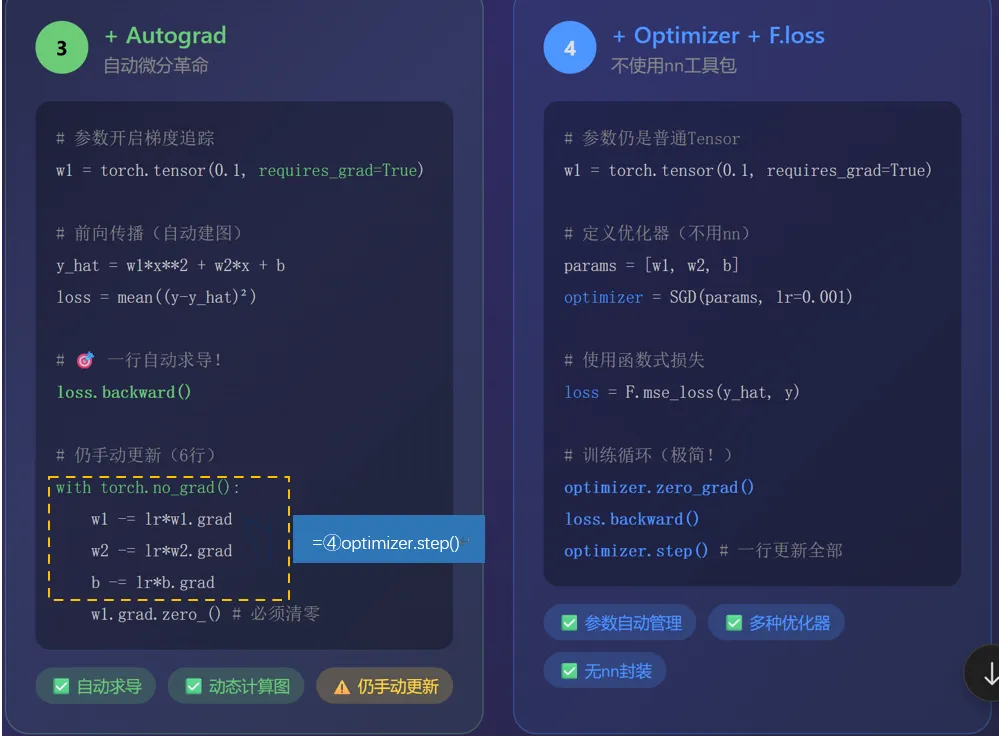
三、四阶段详细演进:代码结构对比
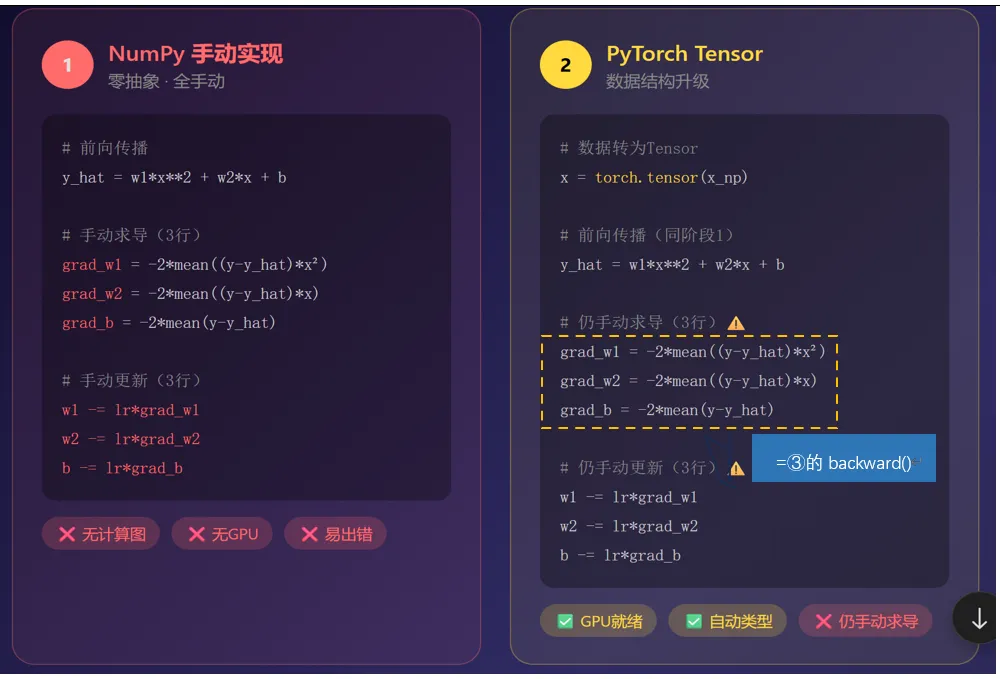
第1阶段到第2阶段:
四、核心挑战—理解backward()核心机制
手工求导繁琐,而且只适合简单任务,解决复杂模型不现实,必须借助 backward() 自动求导来提升效率;但这把“利器”也有使用门槛,下面我们就深入剖析其核心机制,避免踩坑。
1.loss.backward()默认梯度累加机制,多轮反向传播梯度会累加.grad属性,不会自动清空;若不手动zero_(),每一轮梯度不断累积(怎么累积?如下图所示),梯度值越来越大,参数更新步长失控,损失震荡爆炸、无法收敛。
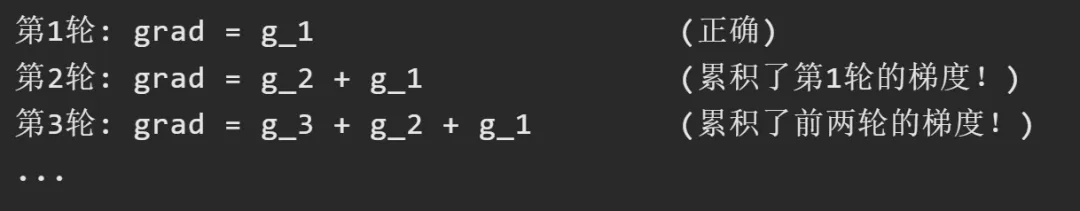
所以梯度清零的正确的方法是:
(1)不使用optimizer时,手工更新参数之后,手工梯度清零(如第3阶段)
(2)使用 optimizer 时,使用optimizer.zero_grad()进行梯度清理,该句可放在optimizer.step () 参数更新之后,或loss.backward () 之前。(如第四阶段)。
【注意】梯度清零语句,不能放在loss.backward ()和optimizer.step ()之间。为什么?
2.自动求导,更新参数时如果去掉 with torch.no_grad() 会怎样?
w = torch.zeros(1, 1, requires_grad=True)
# ...
loss.backward()
#这里缺少不跟踪梯度的语句
w -= lr * w.grad# ❌ 错误:缺少 with torch.no_grad()
运行结果:
runtimeError: a leaf Variable that requires grad is being used in an in-place operation.
3.根本原因
w -= lr * w.grad 等价于 w.sub_(lr * w.grad),这是一个 in-place 操作(直接修改内存)。
当 w.requires_grad=True 时:
·每次前向传播会构建一个计算图(Computational Graph)
·w 是计算图的叶子节点,其他节点可能引用了 w
·in-place 修改 w 后,计算图变得不一致(stale graph)
·下一轮 backward() 时,PyTorch 检测到不一致,抛出 RuntimeError
4.手动更新参数时,为什么要加这句with torch.no_grad(),这句的作用是什么?
作用 | 说明 |
关闭梯度追踪 | 不构建新的计算图 |
允许 in-place 操作 | 可以修改 requires_grad=True 的 Tensor |
节省内存 | 参数更新本身不需要计算梯度 |
5.正确代码
不使用优化器时
loss.backward()
with torch.no_grad():
w-= lr * w.grad# ✅ 正确
自动更新或使用优化器时,就简单多了,多句合为一句,而且还更高效!
loss.backward()
optimizer.step ()# ✅ 正确
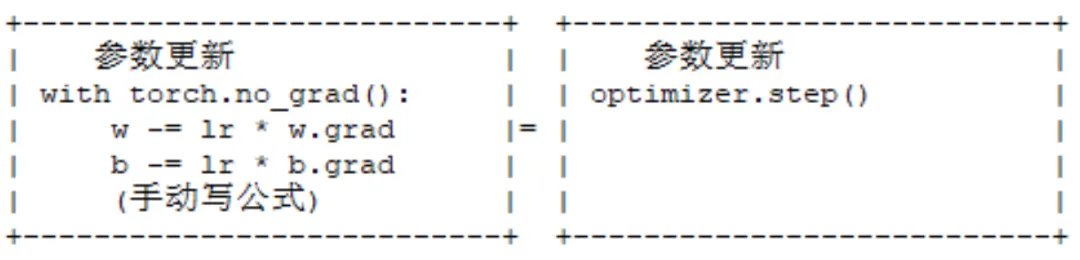
由此可知,不使用优化器时的这三句,等于使用优化器的一句,如下图所示(这个关系上个视频已介绍)
五、小结与拓展:
1.小结
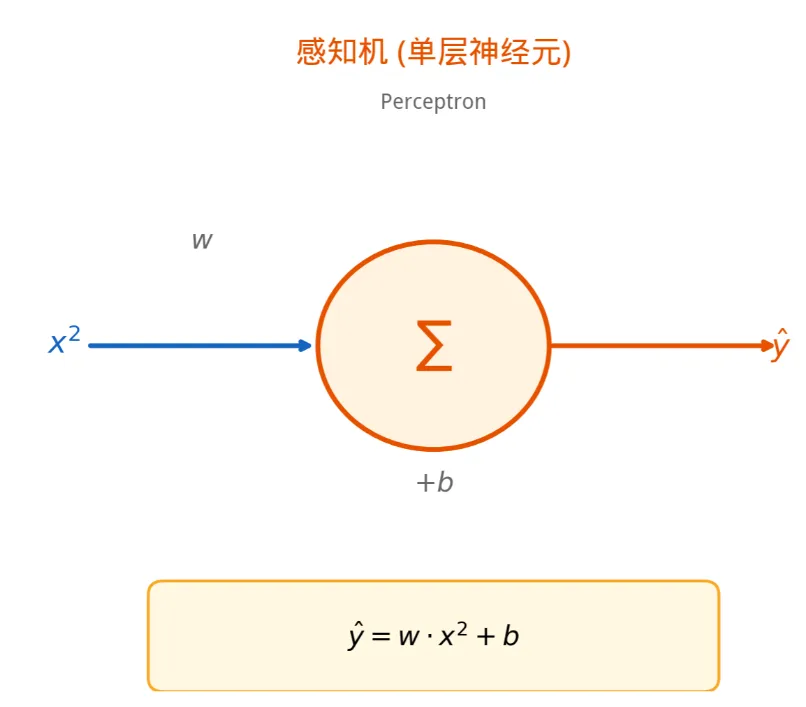
以上这个回归任务 ,实际上可以用一个简单模型(即只一个神经元,且没有激活函数)来表示,输入为
 ,对应权重为w,偏移量为b,感知机中表达式为
 ,感知机的输出为y,
 。
2.拓展:
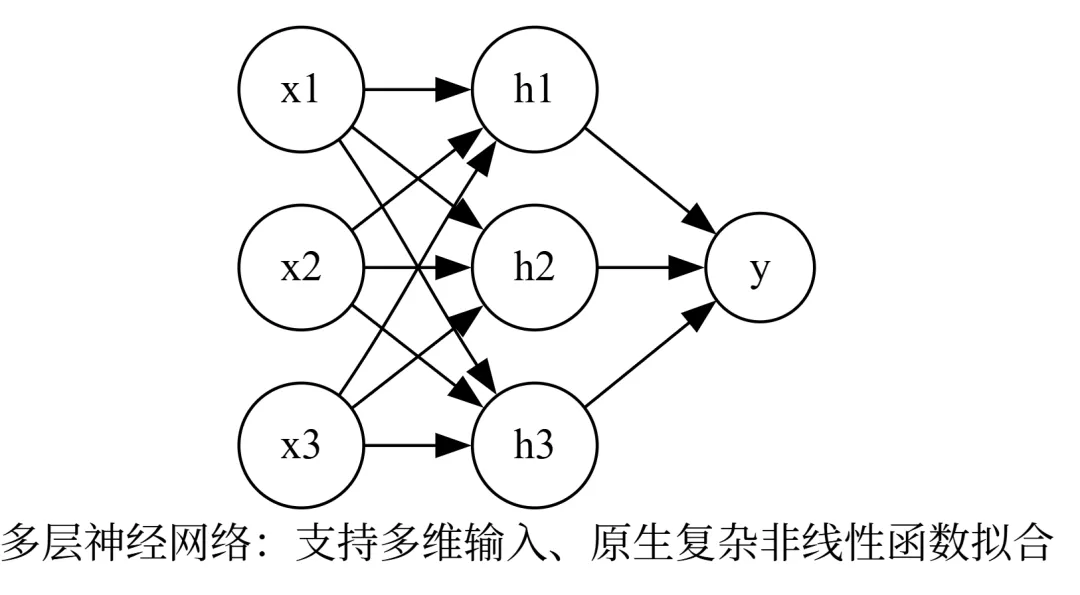
表达式是一个复杂函数(如 ,甚至没有表达式的情况,如何处理?如何构建相应模型?
理论上,多层神经网络可以拟合任何曲线。神经网络相关项目下个视频将介绍,敬请关注!
资料获取途径
视频连接:
抖音账号:84911487035
B站主页:https://space.bilibili.com/391424656
微信公众号【含电子文档及代码等】:大模型大智慧
六、附录【项目完整代码】
"""
====================================================================
项目:从NumPy到PyTorch —— 四阶段渐进式回归实现
目标:拟合 y = 3x^2 + 2 + noise
更新:第4阶段不使用nn工具包,仅使用optimizer + F.mse_loss
====================================================================
"""
import numpy as np
import matplotlib.pyplot as plt
import torch
import torch.nn.functional as F
import warnings
warnings.filterwarnings('ignore')
# 设置中文字体
plt.rcParams['font.sans-serif'] = ['SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False
# ==================== 公共数据准备 ====================
np.random.seed(42)
N = 100
x_np = np.linspace(-3, 3, N)
y_true = 3 * x_np**2 + 2
noise = np.random.normal(0, 0.5, N)
y_np = y_true + noise
print("=" * 70)
print("📊 数据准备完成")
print(f"样本数: {N}")
print(f"真实函数: y = 3x² + 2")
print(f"噪声标准差: 0.5")
print("=" * 70)
# ============================================================
# 第1阶段:NumPy从零实现
# 核心:手动前向传播 + 手动解析求导 + 手动参数更新
# ============================================================
print("\n" + "=" * 70)
print("🔧 第1阶段:NumPy从零实现机器学习回归")
print("=" * 70)
# 模型: y_hat = w1 * x^2 + w2 * x + b
w1, w2, b = 0.1, 0.1, 0.1
lr = 0.001
epochs = 2000
loss_history_p1 = []
w1_h1, w2_h1, b_h1 = [], [], []
pred_history_p1 = []
print(f"\n初始参数: w1={w1:.4f}, w2={w2:.4f}, b={b:.4f}")
print(f"学习率: {lr}, 迭代次数: {epochs}")
for epoch in range(epochs):
y_hat= w1 * x_np**2 + w2 * x_np + b
loss= np.mean((y_np - y_hat)**2)
loss_history_p1.append(loss)
#手动解析求导
grad_w1= -2 * np.mean((y_np - y_hat) * x_np**2)
grad_w2= -2 * np.mean((y_np - y_hat) * x_np)
grad_b= -2 * np.mean(y_np - y_hat)
#手动参数更新
w1-= lr * grad_w1
w2-= lr * grad_w2
b-= lr * grad_b
w1_h1.append(w1);w2_h1.append(w2); b_h1.append(b)
ifepoch % 100 == 0:
pred_history_p1.append(y_hat.copy())
ifepoch % 500 == 0:
print(f"Epoch{epoch:4d}: loss={loss:.6f}, w1={w1:.4f}, w2={w2:.4f}, b={b:.4f}")
print(f"\n✅ 阶段1完成! 最终: w1={w1:.4f}, w2={w2:.4f}, b={b:.4f}, loss={loss:.6f}")
# ============================================================
# 第2阶段:PyTorch实现,不使用autograd/optimizer
# 核心:Tensor替代ndarray,但手动求导和手动更新
# ============================================================
print("\n" + "=" * 70)
print("⚡ 第2阶段:PyTorch Tensor实现(无autograd/optimizer)")
print("=" * 70)
x_tensor = torch.tensor(x_np, dtype=torch.float32)
y_tensor = torch.tensor(y_np, dtype=torch.float32)
# 关键点:requires_grad=False
w1 = torch.tensor(0.1, dtype=torch.float32)
w2 = torch.tensor(0.1, dtype=torch.float32)
b = torch.tensor(0.1, dtype=torch.float32)
lr = 0.001
epochs = 2000
loss_history_p2 = []
w1_h2, w2_h2, b_h2 = [], [], []
pred_history_p2 = []
print(f"\n初始参数: w1={w1.item():.4f}, w2={w2.item():.4f}, b={b.item():.4f}")
print("⚠️ 关键点: requires_grad=False,Tensor只是GPU加速的ndarray")
for epoch in range(epochs):
y_hat= w1 * x_tensor**2 + w2 * x_tensor + b
loss= torch.mean((y_tensor - y_hat)**2)
loss_history_p2.append(loss.item())
#仍手动解析求导!
grad_w1= -2 * torch.mean((y_tensor - y_hat) * x_tensor**2)
grad_w2= -2 * torch.mean((y_tensor - y_hat) * x_tensor)
grad_b= -2 * torch.mean(y_tensor - y_hat)
#手动参数更新
w1-= lr * grad_w1
w2-= lr * grad_w2
b-= lr * grad_b
w1_h2.append(w1.item());w2_h2.append(w2.item()); b_h2.append(b.item())
ifepoch % 100 == 0:
pred_history_p2.append(y_hat.detach().numpy().copy())
ifepoch % 500 == 0:
print(f"Epoch{epoch:4d}: loss={loss.item():.6f}, w1={w1.item():.4f}, w2={w2.item():.4f}, b={b.item():.4f}")
print(f"\n✅ 阶段2完成! 最终: w1={w1.item():.4f}, w2={w2.item():.4f}, b={b.item():.4f}, loss={loss.item():.6f}")
# ============================================================
# 第3阶段:增加autograd自动微分
# 核心:backward()自动求导,但仍手动更新参数
# 关注点:计算图、梯度清零、叶子节点
# ============================================================
print("\n" + "=" * 70)
print("🧬 第3阶段:PyTorch + Autograd自动微分")
print("=" * 70)
# 关键点:requires_grad=True,让PyTorch追踪计算图
w1 = torch.tensor(0.1, dtype=torch.float32, requires_grad=True)
w2 = torch.tensor(0.1, dtype=torch.float32, requires_grad=True)
b = torch.tensor(0.1, dtype=torch.float32, requires_grad=True)
lr = 0.001
epochs = 2000
loss_history_p3 = []
w1_h3, w2_h3, b_h3 = [], [], []
pred_history_p3 = []
print(f"\n初始参数: w1={w1.item():.4f}, w2={w2.item():.4f}, b={b.item():.4f}")
print("⚠️ 关键点:")
print("1. requires_grad=True → PyTorch自动构建计算图")
print("2. loss.backward() → 自动计算所有梯度")
print("3. w1.grad.zero_() → 必须手动清零梯度!")
print("4. with torch.no_grad() → 参数更新时不构建计算图")
for epoch in range(epochs):
#===== 前向传播(自动构建计算图)=====
y_hat= w1 * x_tensor**2 + w2 * x_tensor + b
loss= torch.mean((y_tensor - y_hat)**2)
loss_history_p3.append(loss.item())
#===== 反向传播(一行替代所有手动求导!)=====
loss.backward()
#===== 参数更新(仍手动,但用计算出的梯度)=====
#必须用no_grad,否则更新操作也会被记录到计算图中
withtorch.no_grad():
w1-= lr * w1.grad
w2-= lr * w2.grad
b-= lr * b.grad
#⚠️ 关键!梯度不清零会累积!
w1.grad.zero_()
w2.grad.zero_()
b.grad.zero_()
w1_h3.append(w1.item());w2_h3.append(w2.item()); b_h3.append(b.item())
ifepoch % 100 == 0:
pred_history_p3.append(y_hat.detach().numpy().copy())
ifepoch % 500 == 0:
print(f"Epoch{epoch:4d}: loss={loss.item():.6f}, w1={w1.item():.4f}, w2={w2.item():.4f}, b={b.item():.4f}")
print(f"\n✅ 阶段3完成! 最终: w1={w1.item():.4f}, w2={w2.item():.4f}, b={b.item():.4f}, loss={loss.item():.6f}")
# ============================================================
# 第4阶段:不使用nn工具包,仅增加optimizer和F.mse_loss
# 核心:用torch.optim.SGD + torch.nn.functional.mse_loss
# 参数仍用requires_grad=True的Tensor,不用nn.Parameter
# ============================================================
print("\n" + "=" * 70)
print("🚀 第4阶段:不使用nn工具包,仅增加optimizer + F.mse_loss")
print("=" * 70)
# 参数仍使用普通Tensor + requires_grad=True(不用nn.Parameter)
w1 = torch.tensor(0.1, dtype=torch.float32, requires_grad=True)
w2 = torch.tensor(0.1, dtype=torch.float32, requires_grad=True)
b = torch.tensor(0.1, dtype=torch.float32, requires_grad=True)
# 将参数放入列表,供optimizer使用
params = [w1, w2, b]
# ===== 使用torch.optim.SGD优化器 =====
# optimizer会自动管理params列表中所有requires_grad=True的Tensor
optimizer = torch.optim.SGD(params, lr=0.001)
epochs = 2000
loss_history_p4 = []
w1_h4, w2_h4, b_h4 = [], [], []
pred_history_p4 = []
print(f"\n初始参数: w1={w1.item():.4f}, w2={w2.item():.4f}, b={b.item():.4f}")
print("⚠️ 关键点:")
print("1. 参数仍是普通Tensor(requires_grad=True),不用nn.Parameter")
print("2. 使用torch.nn.functional.mse_loss(函数式API,不用nn.MSELoss类)")
print("3. 使用torch.optim.SGD(params, lr)管理参数更新")
print("4. optimizer.step() 等价于: w1 -= lr * w1.grad(对所有参数)")
print("5. optimizer.zero_grad() 等价于: w1.grad.zero_()(对所有参数)")
for epoch in range(epochs):
#===== 前向传播 =====
y_hat= w1 * x_tensor**2 + w2 * x_tensor + b
#===== 使用F.mse_loss计算损失(函数式,不用nn.Module)=====
loss= F.mse_loss(y_hat, y_tensor)# 等价于 torch.mean((y_hat - y_tensor)**2)
loss_history_p4.append(loss.item())
#===== 反向传播 =====
optimizer.zero_grad()#一行清零所有参数梯度!
loss.backward()#计算梯度
#===== 参数更新 =====
optimizer.step()#一行完成所有参数更新!
w1_h4.append(w1.item())
w2_h4.append(w2.item())
b_h4.append(b.item())
ifepoch % 100 == 0:
pred_history_p4.append(y_hat.detach().numpy().copy())
ifepoch % 500 == 0:
print(f"Epoch{epoch:4d}: loss={loss.item():.6f}, w1={w1.item():.4f}, w2={w2.item():.4f}, b={b.item():.4f}")
print(f"\n✅ 阶段4完成! 最终: w1={w1.item():.4f}, w2={w2.item():.4f}, b={b.item():.4f}, loss={loss.item():.6f}")
print("\n📌 验证:阶段4与阶段3数学完全等价,只是将手动更新封装到optimizer中")
# ============================================================
# 可视化:四阶段对比
# ============================================================
fig = plt.figure(figsize=(20, 10))
colors = ['#ff6b6b', '#ffd93d', '#6bcb77', '#4d96ff']
labels = ['Phase 1: NumPy', 'Phase 2: PyTorch Tensor', 'Phase 3: + Autograd', 'Phase 4: + Optimizer/F.loss']
# 计算最终预测值
final_pred_p1 = np.array(w1_h1[-1]) * x_np**2 + np.array(w2_h1[-1]) * x_np + np.array(b_h1[-1])
final_pred_p2 = np.array(w1_h2[-1]) * x_np**2 + np.array(w2_h2[-1]) * x_np + np.array(b_h2[-1])
final_pred_p3 = np.array(w1_h3[-1]) * x_np**2 + np.array(w2_h3[-1]) * x_np + np.array(b_h3[-1])
final_pred_p4 = np.array(w1_h4[-1]) * x_np**2 + np.array(w2_h4[-1]) * x_np + np.array(b_h4[-1])
# 1. 损失下降曲线对比
ax1 = fig.add_subplot(2, 4, 1)
for loss_hist, color, label in zip([loss_history_p1, loss_history_p2, loss_history_p3, loss_history_p4], colors, labels):
ax1.plot(loss_hist,color=color, alpha=0.8, linewidth=2, label=label)
ax1.set_xlabel('Epoch')
ax1.set_ylabel('MSE Loss')
ax1.set_title('📉 损失下降曲线对比', fontweight='bold')
ax1.legend(fontsize=9)
ax1.set_yscale('log')
ax1.grid(True, alpha=0.3)
# 2. 参数收敛过程:w1
ax2 = fig.add_subplot(2, 4, 2)
for w1_hist, color, label in zip([w1_h1, w1_h2, w1_h3, w1_h4], colors, labels):
ax2.plot(w1_hist,color=color, alpha=0.8, linewidth=2, label=label)
ax2.axhline(y=3, color='black', linestyle='--', alpha=0.5, label='True w1=3')
ax2.set_xlabel('Epoch')
ax2.set_ylabel('w1 value')
ax2.set_title('📊 参数 w1 收敛过程', fontweight='bold')
ax2.legend(fontsize=9)
ax2.grid(True, alpha=0.3)
# 3. 参数收敛过程:b
ax3 = fig.add_subplot(2, 4, 3)
for b_hist, color, label in zip([b_h1, b_h2, b_h3, b_h4], colors, labels):
ax3.plot(b_hist,color=color, alpha=0.8, linewidth=2, label=label)
ax3.axhline(y=2, color='black', linestyle='--', alpha=0.5, label='True b=2')
ax3.set_xlabel('Epoch')
ax3.set_ylabel('b value')
ax3.set_title('📊 参数 b 收敛过程', fontweight='bold')
ax3.legend(fontsize=9)
ax3.grid(True, alpha=0.3)
# 4. 代码复杂度对比
ax4 = fig.add_subplot(2, 4, 4)
metrics = ['手动求导行数', '手动更新行数', '梯度清零行数', '总代码行数']
phase1_vals = [3, 3, 0, 25]
phase2_vals = [3, 3, 0, 23]
phase3_vals = [0, 6, 3, 22]
phase4_vals = [0, 0, 0, 18]
x_pos = np.arange(len(metrics))
width = 0.2
ax4.bar(x_pos - 1.5*width, phase1_vals, width, label='Phase 1', color=colors[0], alpha=0.8)
ax4.bar(x_pos - 0.5*width, phase2_vals, width, label='Phase 2', color=colors[1], alpha=0.8)
ax4.bar(x_pos + 0.5*width, phase3_vals, width, label='Phase 3', color=colors[2], alpha=0.8)
ax4.bar(x_pos + 1.5*width, phase4_vals, width, label='Phase 4', color=colors[3], alpha=0.8)
ax4.set_xticks(x_pos)
ax4.set_xticklabels(metrics, fontsize=10)
ax4.set_title('📊 代码复杂度对比', fontweight='bold')
ax4.legend(fontsize=9)
ax4.grid(True, alpha=0.3, axis='y')
# 5-8. 各阶段最终拟合效果
preds = [final_pred_p1, final_pred_p2, final_pred_p3, final_pred_p4]
for idx in range(4):
ax= fig.add_subplot(2, 4, 5 + idx)
ax.scatter(x_np,y_np, alpha=0.3, s=20, color='gray', label='Data')
ax.plot(x_np,y_true, 'k--', linewidth=2, label='True: y=3x²+2')
ax.plot(x_np,preds[idx], color=colors[idx], linewidth=2.5, label=f'{labels[idx]}\nFinal Fit')
ax.set_title(f'{labels[idx]}',fontweight='bold', color=colors[idx])
ax.legend(fontsize=8)
ax.grid(True,alpha=0.3)
plt.tight_layout()
plt.savefig('four_phases_comparison.png', dpi=150, bbox_inches='tight')
plt.show()
print("\n✅ 可视化完成!")
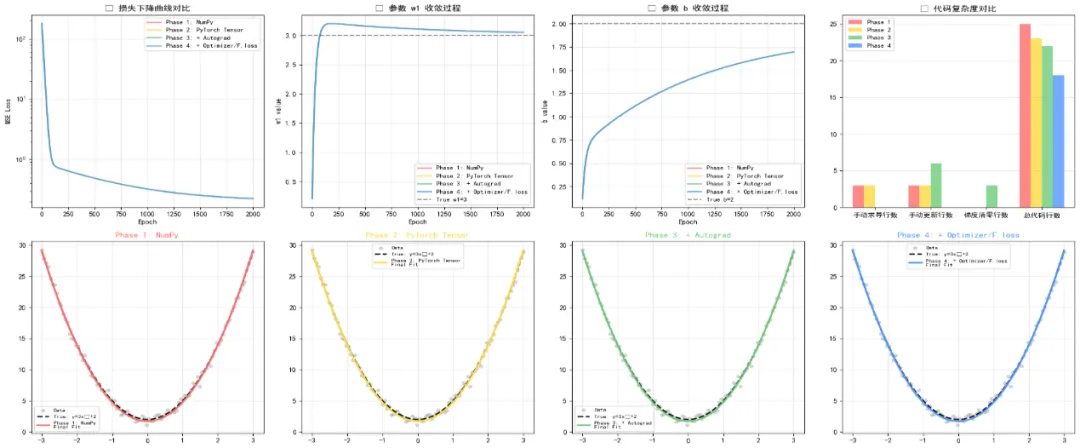
运行结果:
===========================================================
📊 数据准备完成
样本数:100
真实函数:y = 3x² + 2
噪声标准差:0.5
==========================================================
🔧 第1阶段:NumPy从零实现机器学习回归
==========================================================
初始参数: w1=0.1000, w2=0.1000, b=0.1000
学习率: 0.001, 迭代次数: 2000
Epoch0:loss=178.675044, w1=0.2092, w2=0.0995, b=0.1214
Epoch500:loss=0.488656, w1=3.1594, w2=0.0156, b=1.1162
Epoch1000: loss=0.323823, w1=3.1072, w2=0.0117, b=1.3960
Epoch1500: loss=0.254097, w1=3.0733, w2=0.0115, b=1.5781
✅ 阶段1完成! 最终: w1=3.0513, w2=0.0115, b=1.6963, loss=0.224630
===========================================================
⚡ 第2阶段:PyTorch Tensor实现(无autograd/optimizer)
==========================================================
初始参数: w1=0.1000, w2=0.1000, b=0.1000
⚠️ 关键点: requires_grad=False,Tensor只是GPU加速的ndarray
Epoch0:loss=178.675034, w1=0.2092, w2=0.0995, b=0.1214
Epoch500:loss=0.488656, w1=3.1594, w2=0.0156, b=1.1162
Epoch1000: loss=0.323824, w1=3.1072, w2=0.0117, b=1.3960
Epoch1500: loss=0.254097, w1=3.0733, w2=0.0115, b=1.5781
✅ 阶段2完成! 最终: w1=3.0513, w2=0.0115, b=1.6963, loss=0.224630
===========================================================
🧬 第3阶段:PyTorch + Autograd自动微分
===========================================================
初始参数: w1=0.1000, w2=0.1000, b=0.1000
⚠️ 关键点:
1.requires_grad=True → PyTorch自动构建计算图
2.loss.backward() → 自动计算所有梯度
3.w1.grad.zero_() → 必须手动清零梯度!
4.with torch.no_grad() → 参数更新时不构建计算图
Epoch0:loss=178.675034, w1=0.2092, w2=0.0995, b=0.1214
Epoch500:loss=0.488656, w1=3.1594, w2=0.0156, b=1.1162
Epoch1000: loss=0.323824, w1=3.1072, w2=0.0117, b=1.3960
Epoch1500: loss=0.254097, w1=3.0733, w2=0.0115, b=1.5781
✅ 阶段3完成! 最终: w1=3.0513, w2=0.0115, b=1.6963, loss=0.224630
===========================================================
🚀 第4阶段:不使用nn工具包,仅增加optimizer + F.mse_loss
===========================================================
初始参数: w1=0.1000, w2=0.1000, b=0.1000
⚠️ 关键点:
1.参数仍是普通Tensor(requires_grad=True),不用nn.Parameter
2.使用torch.nn.functional.mse_loss(函数式API,不用nn.MSELoss类)
3.使用torch.optim.SGD(params, lr)管理参数更新
4.optimizer.step() 等价于: w1 -= lr * w1.grad(对所有参数)
5.optimizer.zero_grad() 等价于: w1.grad.zero_()(对所有参数)
Epoch0:loss=178.675034, w1=0.2092, w2=0.0995, b=0.1214
Epoch500:loss=0.488656, w1=3.1594, w2=0.0156, b=1.1162
Epoch1000: loss=0.323824, w1=3.1072, w2=0.0117, b=1.3960
Epoch1500: loss=0.254097, w1=3.0733, w2=0.0115, b=1.5781
✅ 阶段4完成! 最终: w1=3.0513, w2=0.0115, b=1.6963, loss=0.224630
📌 验证:阶段4与阶段3数学完全等价,只是将手动更新封装到optimizer中
 10个月宝宝每天需要喝多少奶粉?