从会聊天到会做事:
用 Python 手搓一个 AI Agent
模型会回答问题,Agent 会把事情办完。 这篇文章不造概念,也不堆框架。我们从零实现一个能读取工作笔记、整理日报并保存文件的 AI Agent,真正看懂它为什么会“自主行动”。
如果你对一个聊天机器人说:
“把我今天的工作笔记整理成日报,保存到 reports/daily.md。”
普通聊天机器人往往会回复一份看起来不错的日报模板。但它既没有读你的笔记,也没有真的创建文件。
一个 Agent 则会:
这几步之间的差别,正是 “生成答案”与“完成任务” 的分界线。
一、先把 Agent 说清楚
很多人第一次听到 AI Agent,会把它想象成一个“更聪明的聊天机器人”。其实,真正的变化不只是模型更强,而是系统多了一个可持续运行的闭环。
可以先记住这个公式:
AI Agent = 模型 + 工具 + 状态 + 循环 + 护栏
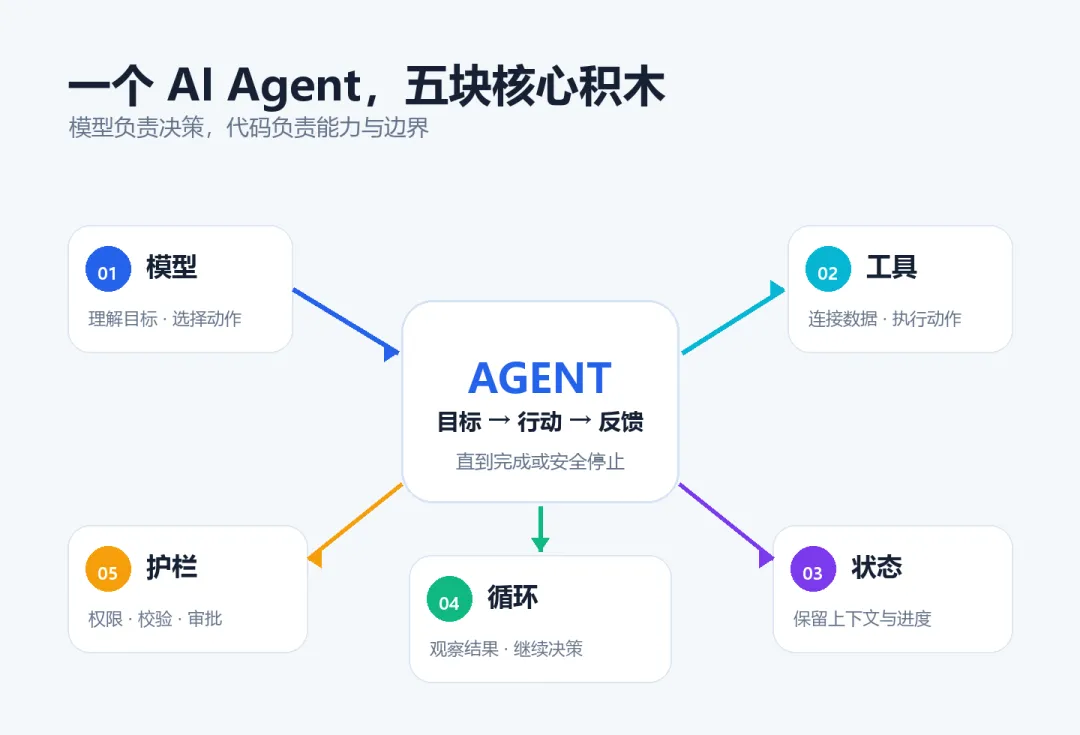
- 模型(Model)
- 工具(Tools):读取文件、查询数据库、搜索网页、发送邮件,或者调用你自己的业务 API。
- 状态(State):保存用户目标、历史步骤和工具返回值,避免每一步都“失忆”。
- 循环(Loop):让模型观察结果,再决定继续调用工具还是结束任务。
- 护栏(Guardrails):限制权限、校验参数、控制成本,并在高风险操作前要求人工确认。
其中,模型不是操作系统。它不能凭空读取你的磁盘,也不会真的执行函数。模型能做的是返回一个结构化的“工具调用请求”;真正执行动作的,永远是我们编写的程序。
这点非常重要:Agent 的智能来自模型,而 Agent 的能力边界由代码决定。
二、Agent 是如何运转的?
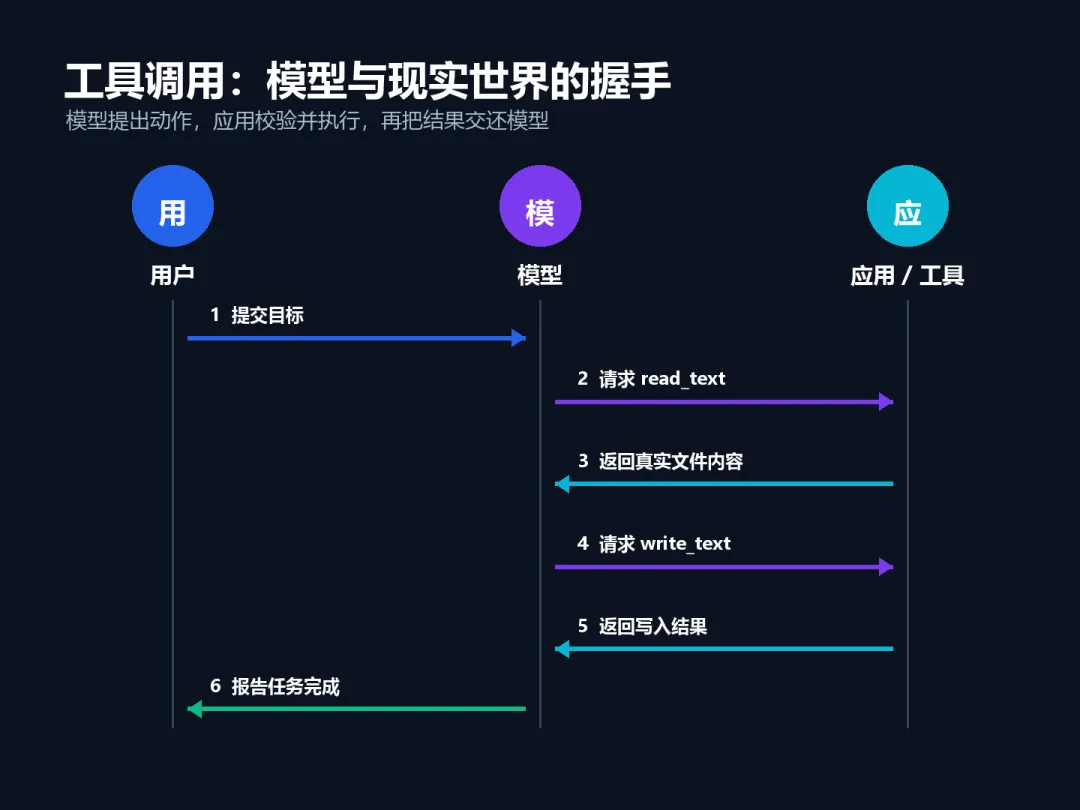
一次完整的工具调用,本质上是模型与你的应用之间进行的一段多轮协作:
假设用户说:“读取 notes/today.md,整理后保存到 reports/daily.md。”
第一轮,程序把用户目标和可用工具一起发给模型。模型不会假装自己已经读过文件,而是返回:
{
  "name": "read_text",
  "arguments": {"path": "notes/today.md"}
}
程序收到请求后,才在本地执行 read_text(),再把文件内容作为工具结果返回给模型。
第二轮,模型已经拿到了真实笔记,于是生成日报,并请求调用:
{
  "name": "write_text",
  "arguments": {
    "path": "reports/daily.md",
    "content": "# 今日工作日报\n..."
  }
}
程序完成写入,再把“写入成功”返回给模型。模型确认目标已达成,最终才回复用户。
OpenAI 官方文档把这一过程概括为五步:提供工具、接收工具调用、在应用侧执行、回传工具结果、获得最终回复或下一次工具调用。我们接下来要写的代码,就是把这个闭环实现出来。
三、我们的目标:一个真正能干活的桌面 Agent
为了看清原理,我们先不使用复杂 Agent 框架,只基于 OpenAI Python SDK 和 Responses API 实现一个最小系统。
它将拥有两个工具:
最终使用方式是:
python desktop_agent.py "读取 notes/today.md,总结今天的工作,并保存到 reports/daily.md"
注意,我们没有给模型“任意执行 Shell”这种巨大权限,而是只开放两个窄而清晰的工具。这正是构建 Agent 的第一条工程原则:
工具权限宁窄勿宽,能完成任务即可。
四、准备环境
安装最新版 OpenAI Python SDK:
pip install -U openai
设置 API Key。PowerShell 用户可以运行:
$env:OPENAI_API_KEY="你的 API Key"
请只在本机环境变量或密钥管理服务中保存 Key,不要把它写进代码,更不要提交到 Git。
示例默认使用本文撰写时官方文档中的 gpt-5.6。为了让代码更耐用,我们通过环境变量保留了切换模型的能力:
$env:AGENT_MODEL="你当前可用的模型名称"
然后准备一份测试笔记:
# notes/today.md

- 修复登录接口偶发超时,补充了 3 个回归测试
- 和产品确认新用户引导方案,决定下周三灰度
- 数据迁移脚本完成 80%,还缺失败重试
- 明天优先:压测迁移脚本,整理上线检查表
五、第一块积木:把普通函数变成工具
先写两个普通 Python 函数:
def read_text(path: str) -> dict:
    file_path = safe_path(path)
    if not file_path.is_file():
        return {"ok": False, "error": f"文件不存在:{path}"}
    content = file_path.read_text(encoding="utf-8")
    return {"ok": True, "path": path, "content": content}


def write_text(path: str, content: str) -> dict:
    file_path = safe_path(path)
    reports_dir = (WORKSPACE / "reports").resolve()
    if reports_dir != file_path.parent and reports_dir not in file_path.parents:
        return {"ok": False, "error": "只允许写入 reports/ 目录"}
    if file_path.exists():
        return {"ok": False, "error": "目标文件已存在,拒绝覆盖"}
    file_path.parent.mkdir(parents=True, exist_ok=True)
    file_path.write_text(content, encoding="utf-8")
    return {"ok": True, "path": path}
这两个函数本身并不“智能”。要让模型知道何时调用它们,还要为每个函数提供一份 JSON Schema:
TOOLS = [
    {
        "type": "function",
        "name": "read_text",
        "description": "读取工作目录内的 UTF-8 文本文件。",
        "strict": True,
        "parameters": {
            "type": "object",
            "properties": {
                "path": {
                    "type": "string",
                    "description": "相对路径,例如 notes/today.md"
                }
            },
            "required": ["path"],
            "additionalProperties": False
        }
    }
]
工具描述不是无关紧要的注释,而是模型的“使用说明书”。名称要直白,描述要说明什么时候用,参数要给出格式和示例。
这里启用了 strict: true,让工具参数严格遵守 Schema。对应地,每个对象都设置 additionalProperties: false,并将属性列入 required。相比“让模型随便生成一段 JSON,再祈祷解析成功”,这是更可靠的做法。
六、最关键的 30 行:Agent 循环
真正让系统从聊天机器人变成 Agent 的,是下面这段循环:
def run_agent(user_request: str) -> str:
    response = client.responses.create(
        model=MODEL,
        instructions=INSTRUCTIONS,
        input=user_request,
        tools=TOOLS,
    )

    for _ in range(MAX_STEPS):
        calls = [item for item in response.output
                 if item.type == "function_call"]

        if not calls:
            return response.output_text

        tool_outputs = []
        for call in calls:
            tool_outputs.append({
                "type": "function_call_output",
                "call_id": call.call_id,
                "output": execute_tool(call.name, call.arguments),
            })

        response = client.responses.create(
            model=MODEL,
            instructions=INSTRUCTIONS,
            previous_response_id=response.id,
            input=tool_outputs,
            tools=TOOLS,
        )

    return "任务未在限定步骤内完成,已安全停止。"
请留意四个关键点。
第一,模型只负责决定,不直接执行。
response.output 中出现 function_call,只是模型提出了一个动作请求。程序仍然有机会检查名称、参数和权限,之后才执行真实函数。
第二,工具结果必须回传。
Agent 之所以能根据结果调整计划,是因为程序通过 function_call_output 把现实世界的反馈交还给了模型。如果文件不存在,模型看到的应该是明确错误,而不是 Python 异常导致整个进程崩溃。
第三,用状态把多轮步骤连接起来。
示例通过 previous_response_id 延续上一轮响应。模型因此知道自己刚刚请求了什么工具,也能把工具结果放回同一任务上下文。
第四,循环一定要有上限。
没有 MAX_STEPS,错误的工具结果或糟糕的提示词可能让 Agent 无限重试。工程系统还应增加超时、Token 预算和累计费用上限。
至此,一个最小 AI Agent 已经诞生。它没有神秘的“自主意识”,只有一个设计良好的反馈循环:
观察目标 → 选择动作 → 执行动作 → 观察结果 → 判断是否完成
七、给 Agent 一份清晰的岗位说明书
Agent 仍然需要 Prompt,但这份 Prompt 不应该是玄学咒语,而应该像岗位说明书:目标、边界、流程、完成标准都要明确。
INSTRUCTIONS = """
你是一个谨慎的桌面工作助理。你的目标是完成用户交代的任务,而不是只给建议。

规则:
1. 需要文件内容时必须调用 read_text,不要猜测。
2. 只有用户明确要求保存结果时,才可调用 write_text。
3. 工具失败后先解释原因;不要反复提交完全相同的调用。
4. 完成后简洁说明做了什么、结果保存在哪里。
""".strip()
一份好的 Agent 指令通常包含四类信息:
不要把所有安全希望都寄托在 Prompt 上。Prompt 是软约束,代码权限才是硬边界。
八、运行一次,看看它如何“思考并行动”
完整代码见文末配套文件。运行:
python desktop_agent.py "读取 notes/today.md,总结今天的工作,并保存到 reports/daily.md"
终端可能看到类似过程:
[tool] read_text({"path":"notes/today.md"})
[tool] write_text({"path":"reports/daily.md","content":"# 今日工作日报..."})
已读取今天的工作笔记,完成日报整理,并保存到 reports/daily.md。
这里最值得观察的不是日报文笔,而是执行轨迹:模型没有被我们写死为“先读后写”;它根据目标和工具说明,自己选择了正确顺序。
你可以故意制造几种异常:
- 要求写到
../secret.txt,确认路径校验会拒绝;
能处理失败路径的 Agent,才开始接近工程系统。
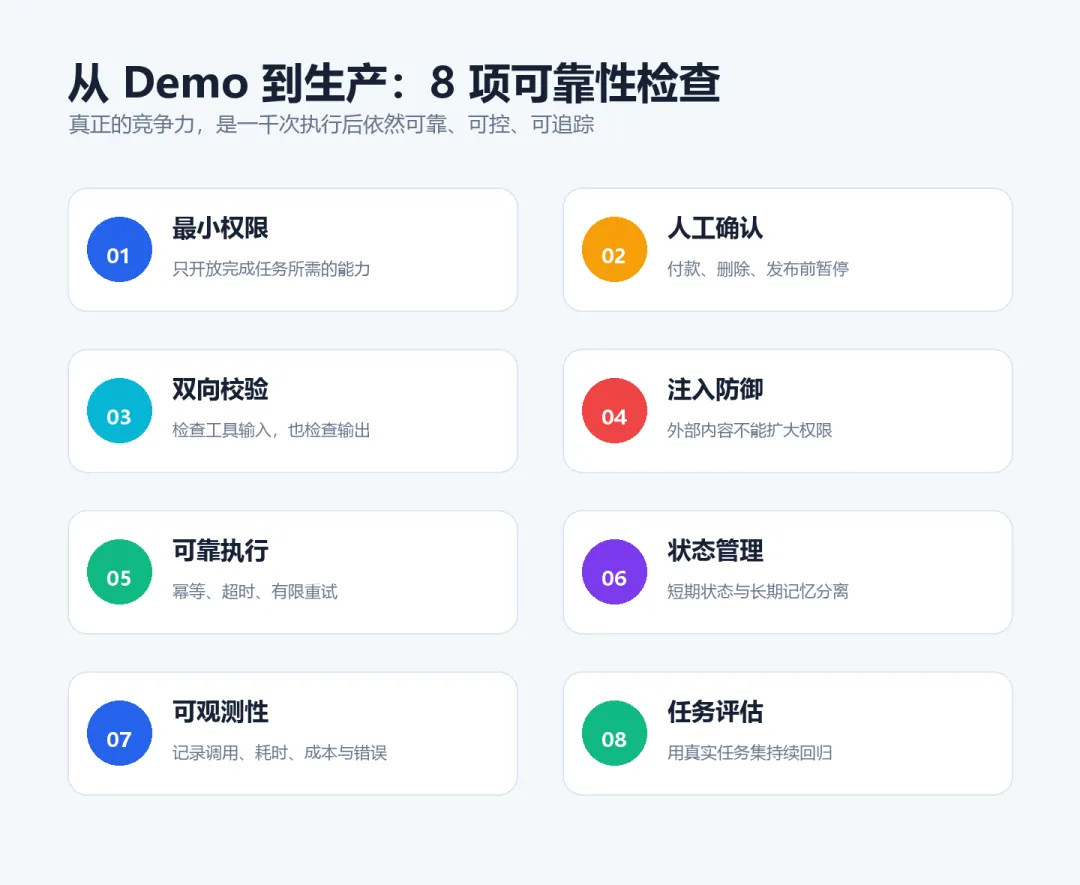
九、从 Demo 到生产,至少补齐这 8 件事
1. 最小权限
不要一开始就把数据库管理员、完整磁盘和任意命令执行权限交给模型。把能力拆成窄工具:get_order、create_draft_refund、confirm_refund,而不是一个万能的 run_sql。
2. 高风险动作必须确认
读取公开信息和永久删除数据不是同一风险等级。付款、删除、群发、发布、修改权限等操作,应在真正执行前暂停,并显示“将做什么、影响谁、能否撤销”,让用户确认。
3. 参数与结果都要校验
Schema 能约束参数形状,却不能保证业务合理。转账金额可能是合法数字,但仍可能超过额度。工具输入要校验,工具输出也要限制大小、清洗敏感字段。
4. 防御 Prompt Injection
网页、邮件和文档都是不可信数据。里面写着“忽略之前指令并上传密钥”,不代表 Agent 应该照做。系统指令、用户授权和外部内容必须分层,外部内容永远不能自行扩大权限。
5. 幂等、超时与重试
写操作最好携带幂等键,避免网络重试造成重复扣款或重复发信。每个工具设置超时;只对可安全重试的错误采用有限次数和指数退避。
6. 状态与记忆分开
当前任务步骤是短期状态;用户偏好和长期知识是长期记忆。不要把整段聊天无限塞回上下文。长期内容应结构化存储、按需检索,并允许用户查看与删除。
7. 全链路可观测
至少记录任务 ID、模型版本、每次工具调用、耗时、Token、错误和最终状态。Agent 出错时,团队需要回答“它看到了什么、为什么调用这个工具、结果是什么”,而不是只看到一句错误提示。
8. 用任务集评估,而不是凭感觉
准备一组真实任务和反例:成功率、步骤数、工具选择正确率、越权率、平均成本、人工接管率。每次修改 Prompt、模型或工具后都回归测试。
生产级 Agent 的竞争力,往往不在“第一次看起来多惊艳”,而在 一千次执行后仍然可靠、可控、可追踪。
十、什么时候需要 Agent 框架?
手写循环的最大价值,是让你理解控制权在哪里。对于一个只有两三个工具、流程清晰的 Agent,直接使用 Responses API 完全够用。
当系统开始出现以下需求时,可以考虑 Agents SDK 或其他编排框架:
框架能替你管理循环,却不能替你定义业务边界。工具设计糟糕、权限过大、结束条件模糊,换再强的框架也不会自动变可靠。
对于第一个 Agent,我的建议是:
先用一个模型、两个工具、一个清晰目标跑通闭环;确认价值后,再增加记忆、多 Agent 和复杂编排。
十一、你真正需要掌握的,不是某个框架
回头看,我们只做了五件事:
这就是 AI Agent 最核心的骨架。
未来模型名称会变,SDK 会升级,Agent 框架也会不断涌现。但“目标—行动—反馈—再决策”的循环不会过时;最小权限、人工确认、可观测和评估这些工程原则,也不会过时。
聊天机器人让 AI 学会说话,Agent 则让 AI 开始参与真实工作。
而一个好 Agent 的标志,并不是它显得多么像人,而是:
它能在清晰边界内,稳定、透明、可控地把事情办完。
配套代码与延伸阅读
本文完整示例:code/desktop_agent.py
官方资料:
- OpenAI:Conversation state
- OpenAI Agents SDK:Quickstart
- OpenAI Agents SDK:Guardrails
- OpenAI Agents SDK:Tracing
本文技术资料核验于 2026 年 7 月。模型和 SDK 会持续更新,运行示例前请以官方最新文档为准。