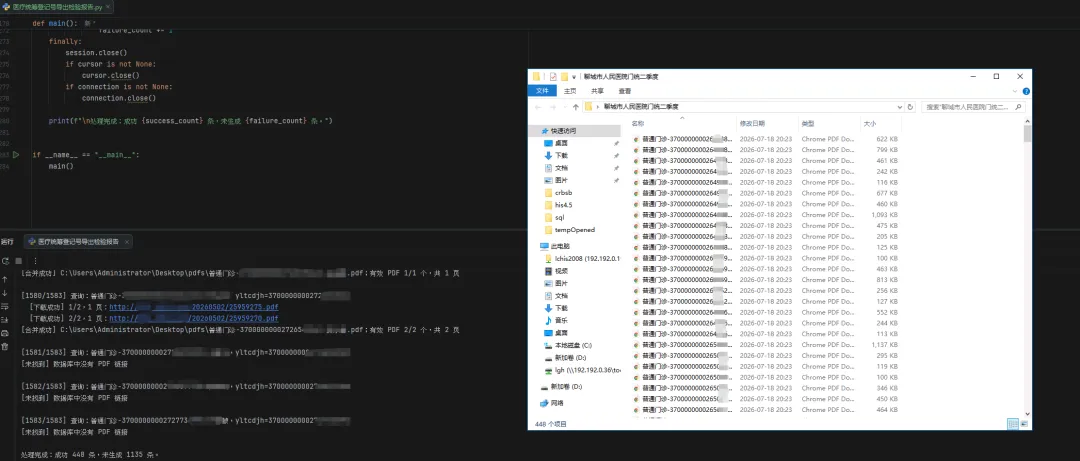
export_history_reports.py复制完整代码import ctypesimport ioimport osimport refrom ctypes import wintypesfrom pathlib import Pathfrom urllib.parse import urljoinimport cx_Oracleimport pandas as pdimport requestsfrom pypdf import PdfReader, PdfWriter# ================= 配置区 =================EXCEL_FILENAME = "待下载清单.xlsx"PDF_OUTPUT_FOLDER = "pdfs"ORACLE_USER = "his数据库账号"ORACLE_PASSWORD = "请改成实际数据库密码"ORACLE_DSN = "数据库链接/his"# BLOB 保存相对链接时填写站点根地址;完整链接则保持为空REPORT_BASE_URL = ""CONNECT_TIMEOUT = 10READ_TIMEOUT = 60# =========================================SQL = """SELECT r.report_file FROM 门诊检验结果表 r JOIN 门诊结算表 s ON r.patient_id = s.card_no AND s.inpatient_no = r.treatment_code WHERE s.yltcdjh = :yltcdjh AND r.report_file IS NOT NULL"""def get_desktop_path(): """获取真实桌面路径,兼容 OneDrive 和系统重定向。""" if os.name != "nt": return Path.home() / "Desktop" class GUID(ctypes.Structure): _fields_ = [ ("Data1", wintypes.DWORD), ("Data2", wintypes.WORD), ("Data3", wintypes.WORD), ("Data4", ctypes.c_ubyte * 8), ] desktop_id = GUID( 0xB4BFCC3A, 0xDB2C, 0x424C, (ctypes.c_ubyte * 8)( 0xB0, 0x29, 0x7F, 0xE9, 0x9A, 0x87, 0xC6, 0x41 ), ) path_ptr = ctypes.c_wchar_p() try: result = ctypes.windll.shell32.SHGetKnownFolderPath( ctypes.byref(desktop_id), 0, None, ctypes.byref(path_ptr) ) if result == 0 and path_ptr.value: return Path(path_ptr.value) finally: if path_ptr.value: ctypes.windll.ole32.CoTaskMemFree(path_ptr) return Path.home() / "Desktop"def read_lob_text(value): """把 Oracle BLOB/CLOB 转换为链接文本。""" if value is None: return "" if hasattr(value, "read"): value = value.read() if isinstance(value, bytes): for encoding in ("utf-8", "gb18030"): try: return value.decode(encoding).strip().strip("\x00") except UnicodeDecodeError: pass return value.decode( "utf-8", errors="replace" ).strip().strip("\x00") return str(value).strip().strip("\x00")def extract_urls(text): """从字段内容中提取一个或多个链接。""" text = text.strip().strip("\"'") if not text: return [] urls = re.findall( r"https?://[^\s,;|\]\[\"']+", text, flags=re.I ) if urls: return urls return [ item.strip().strip("\"'") for item in re.split(r"[\r\n,;|]+", text) if item.strip() ]def safe_filename(value): """移除 Windows 文件名不允许出现的字符。""" name = str(value).strip() if name.lower().endswith(".pdf"): name = name[:-4] name = re.sub(r'[<>:"/\\|?*\x00-\x1f]', "_", name) name = re.sub(r"\s+", " ", name).strip(" .") return name or "未命名"def unique_output_path(directory, filename): """文件重名时自动追加序号,避免覆盖。""" path = directory / f"{filename}.pdf" number = 2 while path.exists(): path = directory / f"{filename}_{number}.pdf" number += 1 return pathdef download_pdf(session, url): full_url = urljoin(REPORT_BASE_URL, url) if not full_url.lower().startswith(("http://", "https://")): raise ValueError(f"无效链接:{url}") response = session.get( full_url, timeout=(CONNECT_TIMEOUT, READ_TIMEOUT) ) response.raise_for_status() if not response.content: raise ValueError("下载内容为空") return response.contentdef append_pdf(writer, pdf_bytes): reader = PdfReader(io.BytesIO(pdf_bytes), strict=False) if reader.is_encrypted: reader.decrypt("") if len(reader.pages) == 0: raise ValueError("PDF 没有页面") for page in reader.pages: writer.add_page(page) return len(reader.pages)def main(): desktop = get_desktop_path() excel_path = desktop / EXCEL_FILENAME save_dir = desktop / PDF_OUTPUT_FOLDER if not excel_path.is_file(): raise FileNotFoundError(f"桌面未找到:{excel_path}") save_dir.mkdir(parents=True, exist_ok=True) # 默认第一行为表头,只按位置读取前两列 df = pd.read_excel(excel_path, dtype=str, usecols=[0, 1]) connection = None cursor = None session = requests.Session() success_count = 0 failure_count = 0 try: connection = cx_Oracle.connect( ORACLE_USER, ORACLE_PASSWORD, ORACLE_DSN ) cursor = connection.cursor() for position, (_, row) in enumerate( df.iterrows(), start=1 ): raw_name = row.iloc[0] raw_yltcdjh = row.iloc[1] if pd.isna(raw_name) or pd.isna(raw_yltcdjh): print(f"[跳过] Excel 第 {position + 1} 行存在空值") failure_count += 1 continue filename = safe_filename(raw_name) yltcdjh = str(raw_yltcdjh).strip().lstrip("*") print(f"[查询] {filename},登记号={yltcdjh}") try: cursor.execute(SQL, yltcdjh=yltcdjh) rows = cursor.fetchall() urls = [] for (report_file,) in rows: text = read_lob_text(report_file) urls.extend(extract_urls(text)) urls = list(dict.fromkeys(urls)) if not urls: print(" [未找到] 没有报告链接") failure_count += 1 continue writer = PdfWriter() valid_count = 0 page_count = 0 for url in urls: try: content = download_pdf(session, url) page_count += append_pdf(writer, content) valid_count += 1 print(f" [下载成功] {url}") except Exception as exc: print(f" [下载失败] {url}:{exc}") if valid_count == 0: failure_count += 1 continue output_path = unique_output_path(save_dir, filename) with output_path.open("wb") as output_file: writer.write(output_file) print( f" [合并成功] {output_path}," f"共 {valid_count} 份、{page_count} 页" ) success_count += 1 except Exception as exc: print(f" [处理失败] {exc}") failure_count += 1 finally: session.close() if cursor is not None: cursor.close() if connection is not None: connection.close() print( f"处理完成:成功 {success_count} 条," f"未生成 {failure_count} 条" )if __name__ == "__main__": main()